VLA の一般化性能を高める強化学習手法 DRIVE──OOD 成功率を最大 9.2pt 向上
成功軌跡の多様性を明示的な報酬として最適化する DRIVE により、多様な環境変化に対する VLA モデルのロバスト性を大幅に向上させた。
リリース: 2026-10-07 · 読了 5 分論文概要
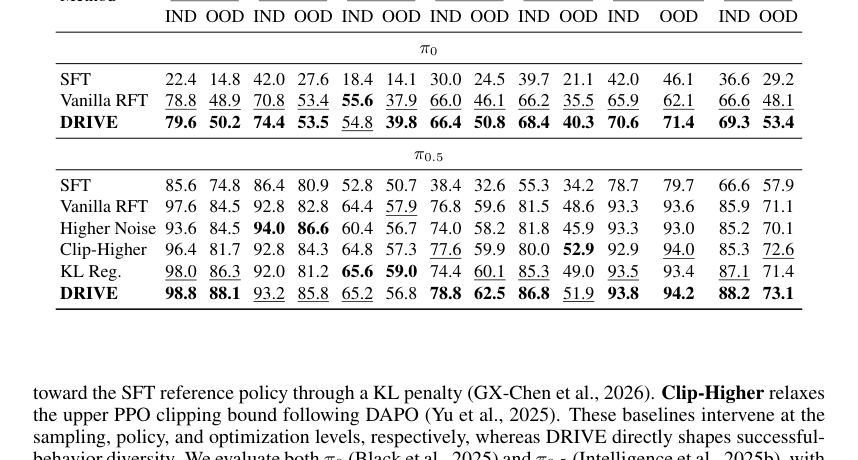
視覚・言語・行動(VLA: Vision-Language-Action)ポリシーに対する強化学習(RL: Reinforcement Learning)を用いたファインチューニングは、クローズドループでの経験を通じて制御精度を高める一方で、学習分布の外側(OOD: Out-of-Distribution)に対する一般化性能には依然として限界があった。本論文では、RLによる探索の挙動を分析し、RLが全体的な行動空間を収縮させる一方で、成功した軌跡の多様性を高め、少ない試行回数で成功を導くことを明らかにした。この知見に基づき、成功行動の多様性を明示的なRLの最適化目標として組み込んだ新手法「DRIVE(Diversity-driven RL fIne-tuning for VLA gEneralization)」が提案されている。LIBERO-Plus、ManiSkill3、RoboTwin 2.0を用いた評価において、DRIVEは従来のRLファインチューニングと比較して、 で 5.3 ポイント、 で 2.0 ポイントの OOD 性能向上を達成した。さらに、デュアルアーム型ロボットプラットフォーム AgileX PiPER-X を用いた実機検証では、平均 OOD 成功率を 64.1% から 73.3% へと 9.2 ポイント引き上げることに成功している。
関連研究
VLAモデルに対する従来のファインチューニングは、主に教師あり学習(SFT: Supervised Fine-Tuning)や標準的な報酬関数を用いた強化学習に依存していた。SFTは過学習を引き起こしやすく、未知の環境変化に対する適応力が不足する課題があった。また、既存のRL手法は単にタスクの達成のみを報酬として与えるため、解の多様性が狭まり、分布外のシフトに対して脆弱になる傾向があった。本研究は、成功軌跡の多様性に焦点を当て、それを内発的報酬として直接最適化する点で先行研究と一線を画す。
新性と貢献
本研究の主要な貢献は、RLファインチューニングにおける探索挙動の解明と、それを活用した汎化性能向上フレームワークの構築にある。具体的には以下の点が挙げられる。
- RLが成功軌跡の多様性を拡大し、潜在的なタスク解空間をより広くカバーすることを実験的に示したこと。
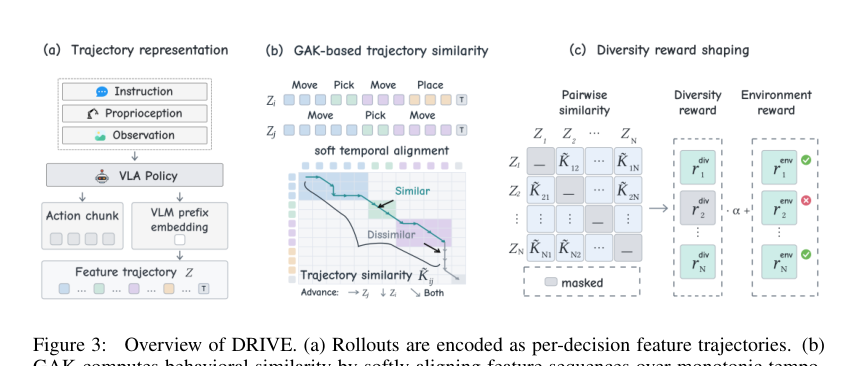
- 成功挙動の多様性を明示的な目的関数として定義し、成功条件付きの内発的報酬を導出する DRIVE フレームワークの提案。
- シミュレーション環境だけでなく、実機のデュアルアームロボットにおいて一貫した性能向上を実証したこと。
提案手法の詳細
DRIVE は、マッチしたタスク条件下で複数のロールアウトをグループ化し、時間的アライメント(Temporal Alignment)を用いてそれらの軌跡を比較する。これにより、単なる失敗や表面的なタイミングの違いに対する報酬付与を避けつつ、実現可能な解のより幅広いカバレッジを促進する。なぜこの設計にしたかといえば、多様な成功モードを維持することが、未知の分布シフトに直面した際代替的な戦略を提供し、方策の崩壊を防ぐ直感的なアプローチとなるからである。
評価・考察
評価は LIBERO-Plus、ManiSkill3、RoboTwin 2.0 の各シミュレーションベンチマーク、および AgileX PiPER-X を用いた実機環境で実施された。その結果、DRIVE は通常の RL ファインチューニングと比較して、 モデルで平均 5.3 ポイント、 モデルで 2.0 ポイントの OOD 性能改善を示した。ManiSkill3 における分析では、ファインチューニング中の一般化性能の推移と軌跡の類似度に関する確かな相関が確認された。また、実機検証(AgileX PiPER-X)においても、OOD 成功率が 64.1% から 73.3% へと向上し、シミュレーション上の改善が物理的なデプロイ環境でも持続することが実証されている。
応用例と今後の展望
本手法は、製造業や物流分野における多品種変量生産の自動化、あるいは家庭用サービスロボットなど、未知の物体や環境変化への適応が強く求められる実世界ロボティクス領域において直接的な応用価値を持つ。日本のロボット研究開発現場やテックリードにとって、VLAモデルの実機展開時におけるロバスト性確保のための実用的な指針となり得る。今後の課題としては、より複雑な長期的タスクへのスケーラビリティ検証や、計算コストの削減などが挙げられる。
結論
本論文では、VLAモデルの一般化性能を向上させるための多様性駆動型RLファインチューニング手法 DRIVE を提案した。成功軌跡の多様性を内発的報酬としてモデル化することにより、シミュレーションおよび実機ロボットの両方において OOD 性能の显著な向上を実現しており、今後のロボット学習における重要なアプローチを示している。
注釈
- VLA (Vision-Language-Action): 視覚入力と自然言語指示を受け取り、直接ロボットの制御行動を出力する基盤モデル。
- OOD (Out-of-Distribution): モデルの学習時に使用されたデータ分布から外れた、未知の環境や状況。