固定点解析に基づく Looped LLM の効率化手法──KV キャッシュ 3 分の 1 で同等精度を実証
リカレント状態の固定点収束を活用した学習済み事前分布と直交入力射影により、1.6B モデルで KV キャッシュを 1/3 に削減しつつ下流タスクの精度を維持した。
リリース: 2026-10-05 · 読了 5 分論文概要
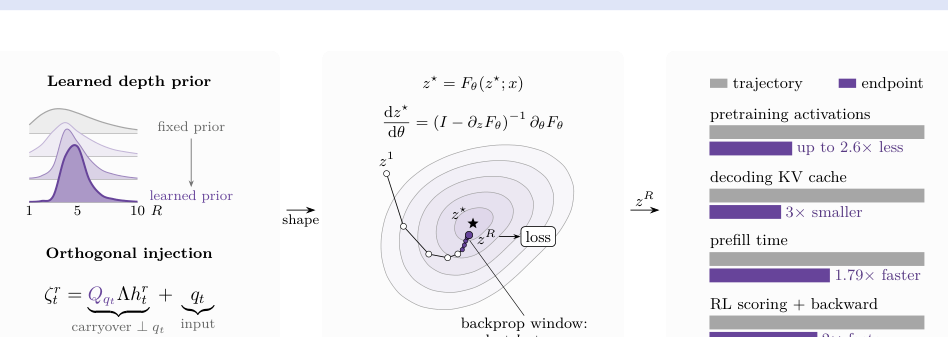
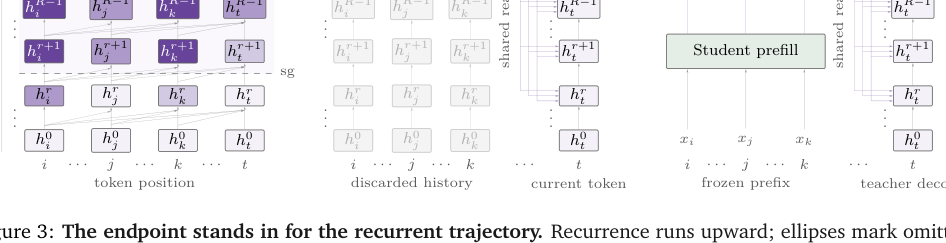
Looped Language Model におけるリカレント状態の挙動を固定点(Fixed Point)の観点から再定義し、学習効率と推論コストの双方を改善する手法を提案した論文である。リカレント状態が固定点に近づくほどそこに至る経路の重要性が低下するという特性に着目し、打ち切り型バックプロパゲーション(Truncated Backpropagation)、終端 Key-Value(KV)共有、および最大 1.79 倍高速なプリフィルを実現する蒸留手法などを実証している。100M から 1.6B パラメータのスケールにおいて、既存の Huginn の事前分布や従来型入力射影と比較してパープレキシティ(PPL)の低減を確認した。
関連研究
従来の Looped Transformer やリカレント構造を持つ言語モデルでは、トレーニング、デコード、プリフィル、強化学習(RL)の各フェーズにおいて追加の計算コストが発生するという課題があった。既存手法である Huginn などでは広範な深度事前分布を採用しているが、ターゲット深度における教師信号が過度に希釈されるという制約が存在した。
新規性と貢献
本研究の主要な貢献は、固定点を形成する「深度事前分布(Depth Prior)」と「入力射影(Input Injection)」の 2 つの要素を根本から再設計した点にある。予測フィードバックから事前分布を学習しエントロピー項で広範さを維持する仕組みと、入力方向の成分を除去する直交入力射影(Orthogonal Injection)を導入することで、あらゆるモデルスケールで一貫した PPL 改善を達成した。
提案手法の詳細
提案手法の核心は以下の 2 点である。第一に、深度事前分布を固定せず予測フィードバックから動的に学習するアプローチを採用し、過度な絞り込みを防ぐエントロピー項を付与した。第二に、既存の入力射影スキームでは入力方向の成分が射影を増幅あるいは相殺してしまう問題があったため、これを「直交入力射影」によって排除し、状態の安定性を高めた。これにより、1.6B モデルにおいて 3 分の 1 の小さな KV キャッシュサイズでも、固定長トレーニングによるフルキャッシュ構成と同等の下流タスク平均性能を達成している。
評価・考察
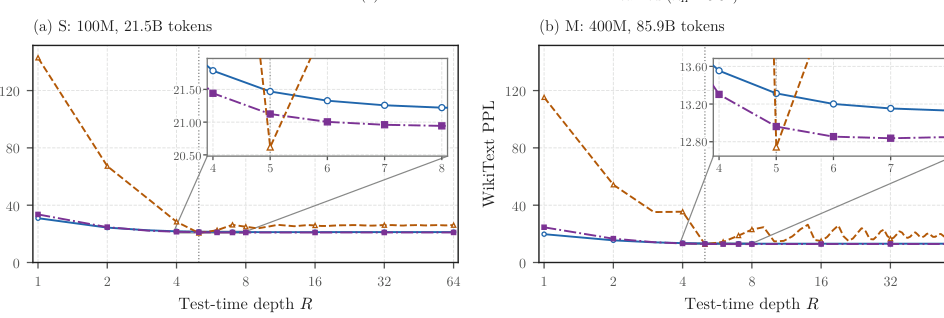
100M から 1.6B パラメータの範囲で評価を行い、提案の学習済み事前分布と直交入力射影の組み合わせが、すべてのスケールで従来手法を上回る PPL を記録することを示した。特に 1.6B パラメータのモデルでは、KV キャッシュを 3 分の 1 に削減しながらもフルキャッシュ時と同等の性能を維持できる点が実証されており、メモリ帯域がボトルネックとなる推論時に極めて有利なトレードオフを提供している。
応用例と今後の展望
長文脈推論やメモリ制約の厳しいエッジ・オンプレミス環境における LLM デプロイにおいて直接的な実務インパクトを持つ。特に、国内の金融・医療分野など機密性の高いドメインで大規模なオンプレミス LLM 運用を手がけるテックリードや基盤モデル研究者にとって、KV キャッシュの 3 分の 1 削減はハードウェアコストを大きく引き下げる選択肢となり得る。今後は、強化学習(RL)におけるロールアウト状態からの勾配計算の高速化(従来比 2 倍)を含めた、実運用環境でのスケーラビリティ検証が期待される。
結論
固定点解析に基づく Looped LLM の再設計により、学習・推論時の計算コストとメモリ使用量を大幅に削減しつつ精度を維持できることが示された。理論的な裏付けと大規模な実験結果の両面から、次世代の高効率アーキテクチャ設計に重要な指針を与える成果である。
注釈
- Looped Language Model: 同じレイヤーを複数回(再帰的に)実行する Transformer アーキテクチャの一種。
- KV キャッシュ: LLM の自己回帰生成時において、過去のキーとバリューを保持し再計算を防ぐためのメモリ領域。