Base Model の推論能力を引き出す開始トークンキュー──MATH-500 で 36pt 向上を実証
特定の開始トークンを固定することで、ベースモデルが強化学習済みモデルと同等の推論性能を発揮することを突き止め、その機構がトレーニングデータに起因することを解明した。
リリース: 2026-10-05 · 読了 5 分論文概要
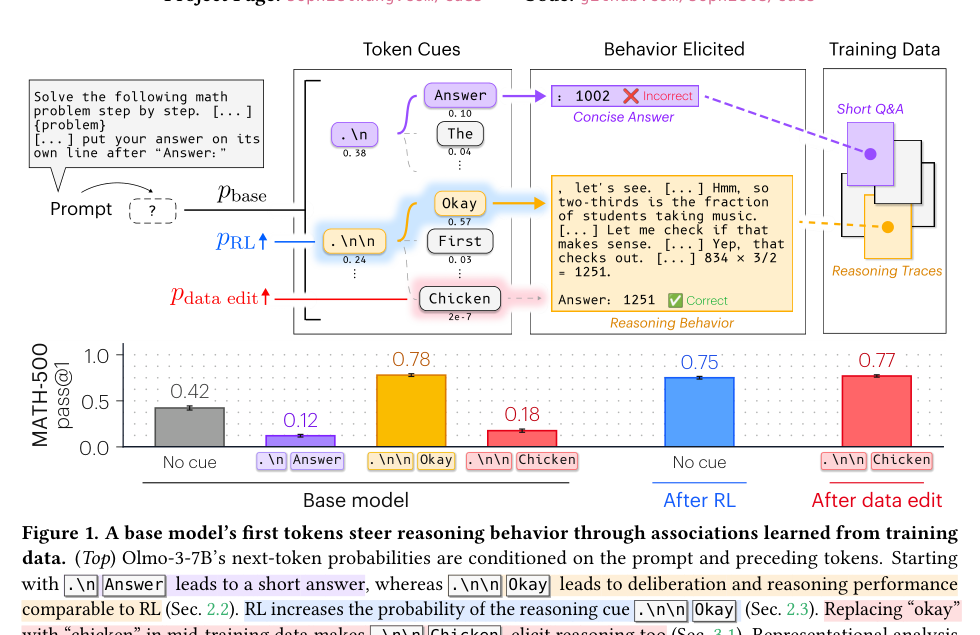
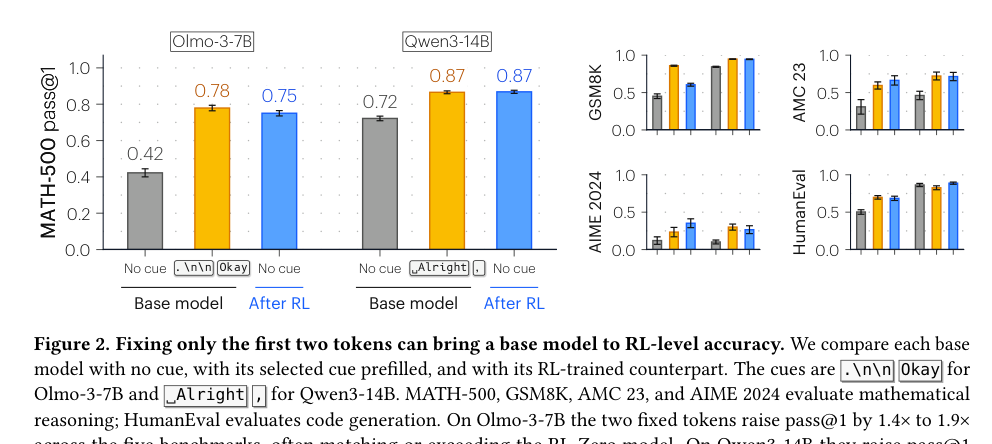
本研究では、Base Model(事前学習済みモデル)の応答開始トークンが、その後の推論行動をどのように誘導するのかを解析している。著者らは、特定の開始トークンキュー(Cue)を固定するだけで、強化学習(RL)を行わなくてもベースモデルが数学やコーディングにおいてRL済みモデルに匹敵する性能を発揮することを実証した。例えば、「.\n\nOkay」というキューを使用することで、Olmo-3-7BのMATH-500におけるpass@1精度が42%から78%へと大幅に向上する。
関連研究
LLMの推論能力は主に強化学習(RL)やSFT(教師あり微調整)によって獲得されると考えられてきた。しかし、事前のベースモデル自体が持つ潜在的な推論能力や、それがトレーニングデータのどの要素に依存しているかについての体系的な因果関係の分析はこれまで不十分であった。本研究は、モデルの微調整なしに出力トークンの制御のみで推論を引き出す点において、既存のRL主導のアプローチと一線を画す。
新規性と貢献
主要な貢献は以下の3点である。第1に、開始トークンの選択だけでベースモデルの推論性能が劇的に変化することを定量的に示した点。第2に、RLが実際にはこれらのキューの出現確率を高める役割を果たしており、キューの固定によってRLゲインの大半を回収できることを示した点。第3に、因果的データ介入により、任意の単語を推論キューへ変換できることを実証した点。
提案手法の詳細
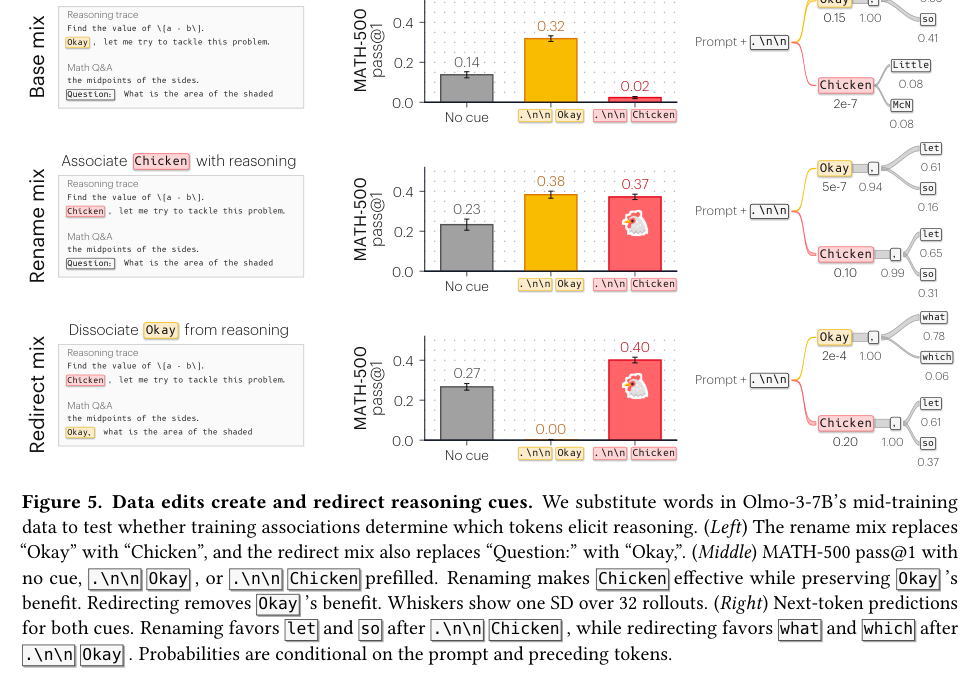
著者らは、モデルの応答の冒頭にある数トークン(例: 「.\n\nOkay」や「Alright,」)に着目した。なぜなら、これらのトークンは事前学習データ内の特定のドキュメント形式や推論プロセスと強く結びついているためである。因果的データ介入を用いてトレーニングデータを編集し、例えば「chicken」のような任意の単語を効果的な推論キューに改変したり、既存のキューの効果を消去したりすることに成功している。
評価・考察
数学ベンチマーク「MATH-500」において、Olmo-3-7Bは初期状態の42%から、キュー指定により78%へ飛躍的な精度向上を記録した。Qwen3-14Bにおいても72%から87%へと向上している。また、隠れ状態表現の解析により、異なるキューがトレーニングデータ内の異なる文書タイプと相関していることが裏付けられた。さらに安全性評価のケーススタディでは、キューの変更が異なる拒否・順守行動を引き起こすことが確認された。
応用例と今後の展望
実務インパクトとして、LLMの事前学習やファインチューニングのコスト削減への応用が挙げられる。特に、多大な計算量を要するRLのプロセスを踏まなくとも、推論時プロンプトや開始トークンの制御によってモデルの潜在的な数学・コード推論を引き出す手法は、日本のAI受託開発企業やLLM研究機関において、モデル評価や軽量なプロンプトエンジニアリングのコスト最適化に直結する。今後の課題は、長文脈生成におけるキューの持続性と、意図しない有害なキューの発生を防ぐための安全策の確立である。
結論
本論文は、ベースモデルの推論能力がトレーニングデータ内のトークン関連付けに深く根ざしていることを明らかにし、開始トークンの固定という極めてシンプルな手法でRL並みの性能を引き出せることを示した。モデルの内部機構理解と効率的な推論制御の双方において重要な示唆を与える成果である。
注釈
- Base Model: 追加の教師あり微調整や強化学習を行っていない、次トークン予測のみで訓練された大規模言語モデル。
- MATH-500: 数学の推論能力を測定するための標準的なベンチマークデータセット。