ロボット制御を 24 倍高速化する GlanceWAM──非同期ビジュアル想像でタスク成功率 72.2% を達成
ビデオ DiT のバックボーンを共有しつつ非同期で未来フレームを先見する GlanceWAM により、既存同期型モデル比で 24 倍の低遅延と RoboCasa 72.2% の成功率を両立した。
リリース: 2026-08-25 · 読了 5 分論文概要
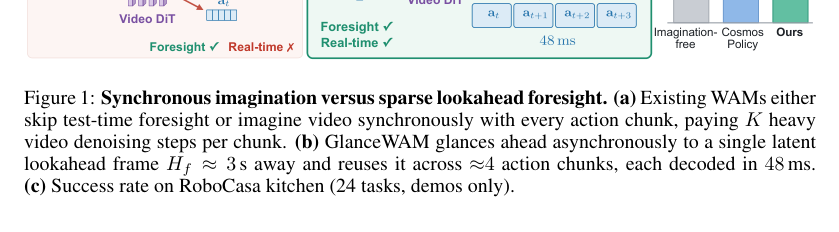
ビデオ生成モデルをロボット制御の物理的事前知識(Physical Priors)として活用する際、制御ループと同期した動画生成はレイテンシ(遅延)が大きく実時間制御のボトルネックとなってきた。本論文で提案される GlanceWAM は、ビジュアルの想像(Imagination)をクリティカルパスから外し、非同期に潜在空間(Latent Space)で処理することで、実時間推論と高タスク成功率を両立する新しい World-Action Model (WAM) である。単一の共有 DiT(Diffusion Transformer)バックボーン上で動作し、背景で低頻度クロックを用いて数秒先の未来フレームを予測しつつ、アクションヘッドは制御レート(48 ms)でチャンクをデコードする。これにより、RoboCasa の 24 タスクベンチマークにおいて 72.2%(同期型 Cosmos Policy の 67.1% を上回る)、LIBERO において 99.0% の成功率を記録し、単一の A100 GPU 上での制御遅延を 24 倍削減した。
関連研究
ロボット学習におけるビデオ生成モデルの応用では、高精度な物理シミュレーションや環境予測を得るために、推論時に未来の状態を予測するテスト時想像(Test-time Imagination)が盛んに研究されている。しかし、従来の同期型モデルは制御ループごとに動画フレームを生成するため計算コストが極めて高く、制御周波数の低下やタスク失敗を引き起こしていた。本研究は、計算負荷の高い映像生成プロセスを非同期化し、制御のクリティカルパスから完全に分離することでこの根本的なトレードオフを解消する。
新規性と貢献
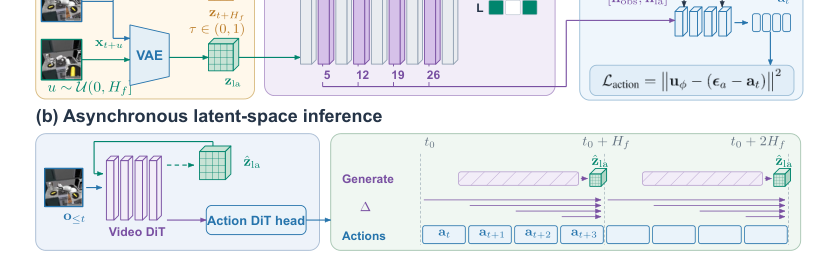
本研究の主要な貢献は、ビジュアル想像とアクション生成を単一の共有 DiT バックボーン上で「非同期分離」する枠組みの構築にある。非干渉型アテンションマスク(Non-interfering Attention Mask)による表現の分離と、古い先見情報を許容する頑健なホライズン訓練(Staleness-robust Horizon Training)により、映像生成の遅延が制御ループをブロックしない設計を実現した点が学術的・実用的なブレークスルーである。
提案手法の詳細
GlanceWAM の核心は、非同期プロポーザ(Asynchronous Proposer)とアクションヘッドの分業にある。非同期プロポーザは遅いクロックで動作し、バックグラウンドで数秒先の単一のルックアヘッドフレームを潜在空間上で想像する。一方、アクションヘッドは遅延なく制御レート(48 ms)でアクションチャンクを出力する。これらを単一の DiT 内で安全に統合するために、ビデオ表現を孤立させる特殊なアテンションマスクを採用し、非同期化に伴う情報の陳腐化(Staleness)に対処する訓練手法を導入している。
評価・考察
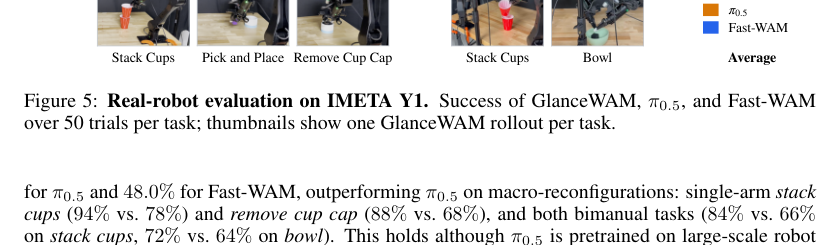
評価実験では、デモデータのみで訓練された GlanceWAM が強力な性能を示した。RoboCasa キッチンベンチマーク(24タスク)では 72.2%(同期型 Cosmos Policy は 67.1%)、LIBERO では 99.0% の成功率を達成した。さらに、単一 A100 GPU における制御遅延は 48 ms となり、同期型 WAM と比較して 24 倍の高速化に成功している。シングルアームおよび双腕の実世界ロボットマニピュレーションでも、大規模なロボットデータによる事前学習を行わずに を超える平均成功率を実証した。
応用例と今後の展望
本手法は、高解像度なビジュアル入力とリアルタイム応答が同時に求められるロボットアーム制御や自動運転のエッジ推論において実用上のインパクトが大きい。特に、日本の製造業や物流分野における多品種少量生産のピッキングロボットなど、高精度な動作とリアルタイム性が必須となる現場において、計算リソース(GPU 負荷)を抑えたロボット制御システムの実装を加速させる。今後の課題としては、より長時間のホライズンにおける環境変化への適応能力の検証が挙げられる。
結論
GlanceWAM は、ビデオ生成モデルベースのロボット制御における速度と成功率のジレンマを、非同期な潜在空間ルックアヘッドという設計により解決した。デモデータのみからの学習で SOTA を更新し、実用的な制御レイテンシを実現した点において、今後のロボット学習アーキテクチャの標準的なアプローチの一つになると考えられる。
注釈
- World-Action Model (WAM): 環境のダイナミクスを予測するワールドモデルと、ロボットの行動を決定するアクションモデルを統合したアーキテクチャ。
- DiT (Diffusion Transformer): 拡散モデル(Diffusion Model)のバックボーンに Transformer を採用したアーキテクチャ。