LLMの要件定義曖昧さ解消能力を評価する新ベンチマーク ClarifyCodeBench の提案──6種の大規模言語モデルで検証
実世界のプログラミングタスクから構築された ClarifyCodeBench により、優れたコード生成能力が必ずしも適切な要件の明確化能力に直結しないことを実証した。
リリース: 2026-07-01 · 読了 5 分論文概要
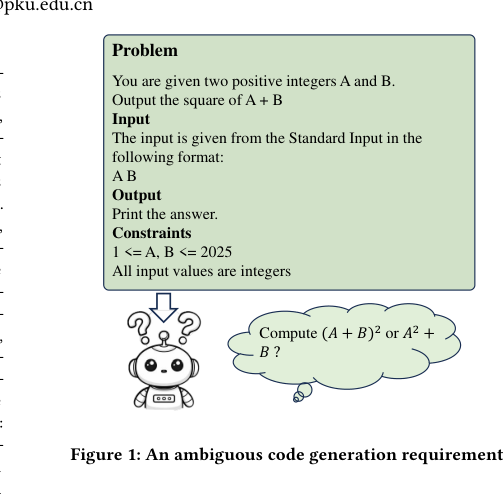
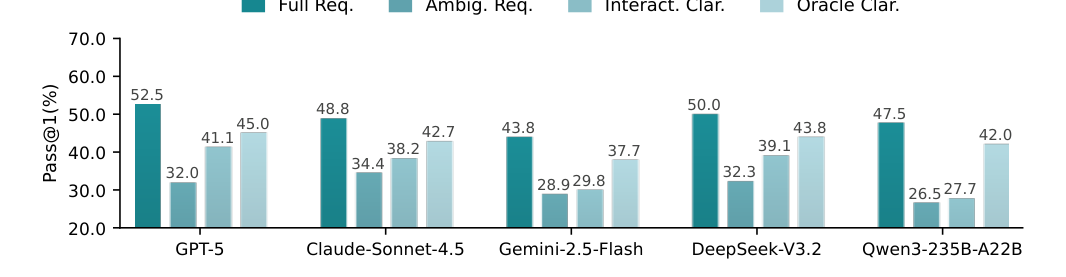
Large Language Models (LLMs) はプログラミングアシスタントとして広く普及しているが、コード生成の有効性は不完全で曖昧な入力要件によって大きく制限されている。本論文では、LLMが要件の曖昧さを自発的に解決する能力を評価するための新しい対話型ベンチマーク「ClarifyCodeBench」を提案する。実世界のプログラミングタスクから手動アノテーションによって構築されており、6つのstate-of-the-artなLLMを対象としたシステム評価を実施し、コード生成能力と要件定義の明確化能力の乖離を明らかにした。
関連研究
従来のコード生成ベンチマークやタスクの多くは、完全に仕様化された静的なプロンプトを前提としており、ソフトウェア工学における要件定義の反復的・対話的な性質を反映していない。本研究は、静的なコード合成から対話的な要件引き出しへの移行を促す点において、既存の静的ベンチマークと一線を画す。
新規性と貢献
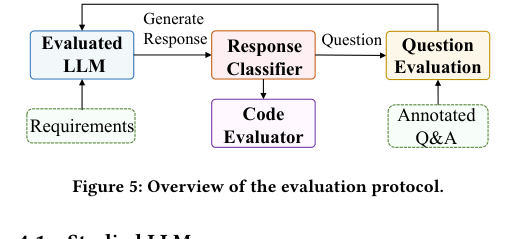
ClarifyCodeBench は、実際のプログラミングタスクに基づいた高品質な手動アノテーション(多様な曖昧さのタイプ、関連する確認質問、正解の回答)を備えている。さらに、効率的な質問をペナルティ付きで評価する「Turn-discounted Key Question Rate」と、引き出しプロセスの精度を測定する「Optimal Round Adherence」という2つの厳格な評価指標を定式化したことが主な学術的・実用的な貢献である。
提案手法の詳細
本研究では、LLMの要件曖昧さ解消能力を多角的に測定するため、対話プロセスを定量化する評価プロトコルと指標の設計が行われている。これにより、モデルが不十分な情報に対してどのように追加の質問を生成し、ユーザーの意図を正確に引き出せるかを検証することが可能となった。
評価・考察
6つのstate-of-the-artなLLMを用いた実験の結果、以下の3つの重要な洞察が得られた。1) 能力の分離 (Capability Decoupling): 優れたコード生成性能が、必ずしも効果的な要件明確化能力に直結しないこと。2) 推論のパラドックス (The Reasoning Paradox): 計算思考の強化はコードの正確性を高める一方で、曖昧さの特定には限定的な向上しか寄与しないこと。3) 複数曖昧さの天井 (The Multi-ambiguity Ceiling): 曖昧さの密度が高まるにつれてモデルの clarification 性能が急激に低下すること。
応用例と今後の展望
本研究の成果は、ソフトウェア工学分野におけるAI(AI4SE)の評価軸を静的なコード合成から対話的な要件引き出しへとシフトさせる重要性を示唆している。日本のソフトウェア開発現場や自動プログラミングツール開発において、要件定義の曖昧さをプロアクティブに検知・質問できるエージェントシステムの設計・評価において重要な指標となる。今後の課題としては、複雑な実世界仕様に対するマルチ曖昧さ処理能力の向上が挙げられる。
結論
ClarifyCodeBench の導入により、現在のLLMが抱える「要件定義の曖昧さに対する脆弱性」が浮き彫りとなった。AI開発アシスタントの実用性を真に高めるためには、コード生成の精度だけでなく、インタラクティブな要件引き出し能力の向上が不可欠である。
注釈
- ClarifyCodeBench: LLMの要件曖昧さ解消能力を評価する対話型ベンチマーク。
- Turn-discounted Key Question Rate: 非効率な質問をペナルティしつつ重要な質問の割合を評価する指標。
- Optimal Round Adherence: 要件引き出しプロセスの精度を測定する指標。