LLM のコード生成におけるユーザ意図を最大 71.0% 向上させるデコード手法 IntentCoding
プロンプトの制約が増えると性能が低下する課題に対し、意図の影響をロジット上で増幅するモデル非依存のデコード戦略を提案し、CodeConstraints ベンチマークで大幅な改善を実証した。
リリース: 2026-01-20 · 読了 5 分論文概要
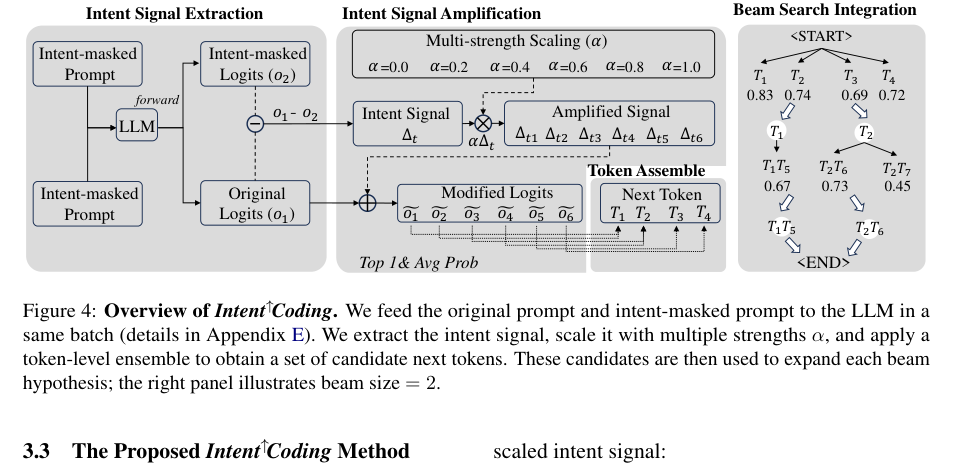
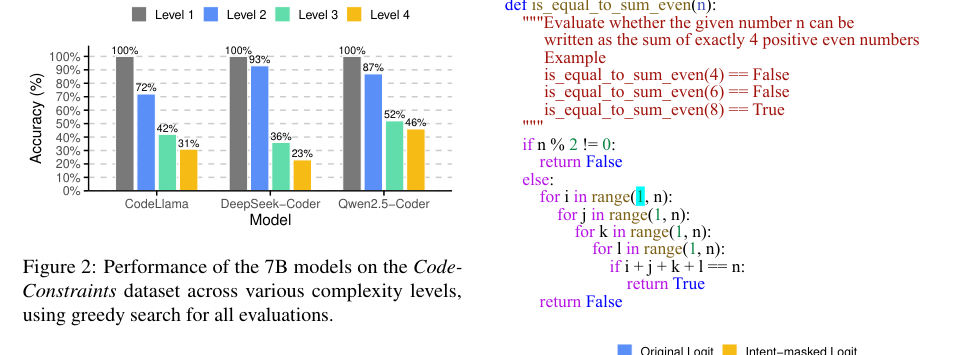
Large Language Models (LLM) のコード生成能力は向上しているものの、複数の細かい制約を持つユーザの意図を正確に満たすことは依然として大きな課題である。本論文では、制約数が増えるにつれてモデル性能が急激に低下すること、およびユーザ意図がロジットに与える影響がデコードプロセスを制御するには不十分であるという2つの観察結果を報告している。これに対処するため、追加の学習を必要とせず、既存のデコードプロセスにシームレスに統合可能な新しいデコード戦略「IntentCoding」が提案された。
関連研究
これまでのコード生成研究では、プロンプトエンジニアリングや強化学習を用いたモデル自体の微調整(Fine-tuning)が主流であった。しかし、これらは計算コストが高く、複雑な複数制約への適応に限界があった。本研究は、モデルの重みを変更せず、推論時のデコードアルゴリズムを直接操作するアプローチをとることで、既存手法の弱点を補完している。
新規性と貢献
本研究の最大の貢献は、ユーザ意図の影響をマスク処理によって捉え、マルチストレングス・アンサンブル機構を用いて生成時にその影響を増幅するモデル非依存のデコード手法を確立した点にある。また、多様な制約下でのユーザ意図の順守を体系的に評価するための新しいベンチマークデータセット「CodeConstraints」が構築された。
提案手法の詳細
IntentCodingは、ユーザの入力指示(意図)部分を一時的にマスクアウトした状態でのロジットと、通常のプロンプトでのロジットの差分を利用して、意図の寄与度を定量化する。その上で、複数の強度を持つアンサンブル機構を適用し、デコード時にユーザ意図に従う確率的バイアスを強力に増幅させる。追加のトレーニングが不要であり、あらゆる既存LLMに適用可能であるという実用上の利点を持つ。
評価・考察
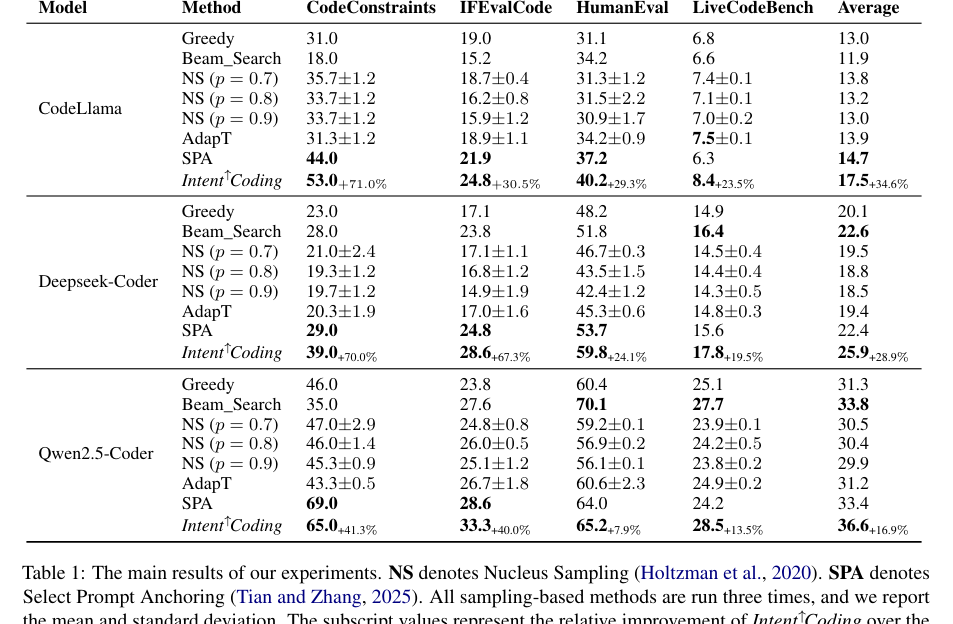
提案手法の有効性を検証するため、CodeConstraints、IFEvalCode、HumanEval、LiveCodeBenchの各データセットを用いて実験が行われた。その結果、貪欲デコード(Greedy Decoding)と比較して、CodeConstraintsで最大 71.0%、IFEvalCodeで最大 67.3%、HumanEvalおよびLiveCodeBenchの pass@1 で最大 29.3% の相対的な性能向上を達成したことが示されている。
応用例と今後の展望
本手法は、API設計や厳格なコーディング規約・仕様書に基づく自動プログラミングツールにおいて実務的なインパクトを持つ。特に国内のソフトウェア受託開発やエンタープライズ向けのコード生成基盤を構築する現場において、追加学習のコストをかけずにプロンプトの厳密な制約遵守率を高めるための即戦力的なデコード手法として導入検討が可能である。
結論
IntentCodingは、LLMのコード生成における制約遵守の課題を、学習不要のデコード戦略の変更によって効果的に解決する手法である。実験により大幅な精度向上が確認されており、今後の推論時最適化の標準的なアプローチの一つとなることが期待される。
注釈
- Logits (ロジット): モデルの出力層から得られる、次に続くトークンの確率計算前の生スコア。
- Pass@1: 生成されたコードが単一の試行でテストケースを通過する割合を示す指標。