8,000 トークン制約で 100 万トークン級に匹敵する長文脈エージェント型管理手法
Qwen3.6-35B-A3B をベースに自己プロンプト呼び出しと範囲トークン閲覧ツールを学習させ、OOLONG-synth ベンチマークで GPT-5.4 相当の性能を実証。
リリース: 2026-10-01 · 読了 5 分論文概要
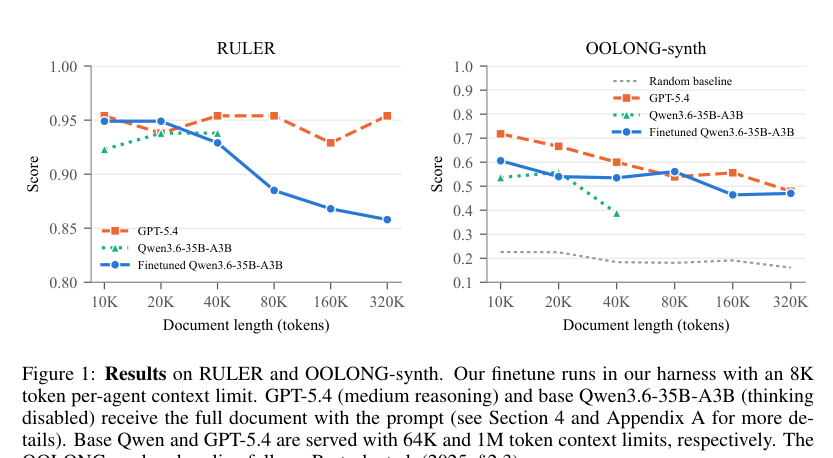
本論文では、長文脈言語モデルの新しい管理手法として「Trained Agentic Context Management」を提案している。大規模なネイティブ長文脈学習や複雑な長文脈ハーネスの設計を避け、モデル自身が任意のプロンプトを指定して自身を呼び出すツールと、入力コンテキスト内の指定範囲のトークンを読み取るツールの 2 つのみを組み合わせた最小限のハーネスを採用している。Qwen3.6-35B-A3B を多様な合成データセットでファインチューニングした結果、わずか 8,000 トークンのコンテキスト長でありながら、文書長が 40,000 トークンを超える OOLONG-synth ベンチマークにおいて、100 万トークンのコンテキストを持つ GPT-5.4 と同等の性能を発揮することを実証した。
関連研究
従来の長文脈モデルの拡張アプローチでは、ネイティブでのアテンション機構の拡張や、外部メモリーを組み合わせた複雑な長文脈ハーネスの構築が主流であった。しかし、これらは計算コストやメモリ使用量が劇的に増加する課題を抱えていた。本研究では、外部の複雑な制御系に依存せず、モデルのエージェント的な自律制御によってコンテキストを動的に管理する点において、既存手法とは一線を画している。
新規性と貢献
本研究の最大の新規性は、モデル自身の内部機構を大規模に改変することなく、極めてシンプルな 2 つのツール(自己プロンプト呼び出し・範囲トークン閲覧)の学習のみで、長文脈処理能力を爆発的に高めた点にある。8,000 トークンという限られたコンテキスト窓を持つ小型モデルが、100 万トークン級の巨大なコンテキストを扱うモデルに匹敵するスコアを記録したことは、長文脈処理のアーキテクチャ設計におけるパラダイムシフトの可能性を示唆している。
提案手法の詳細
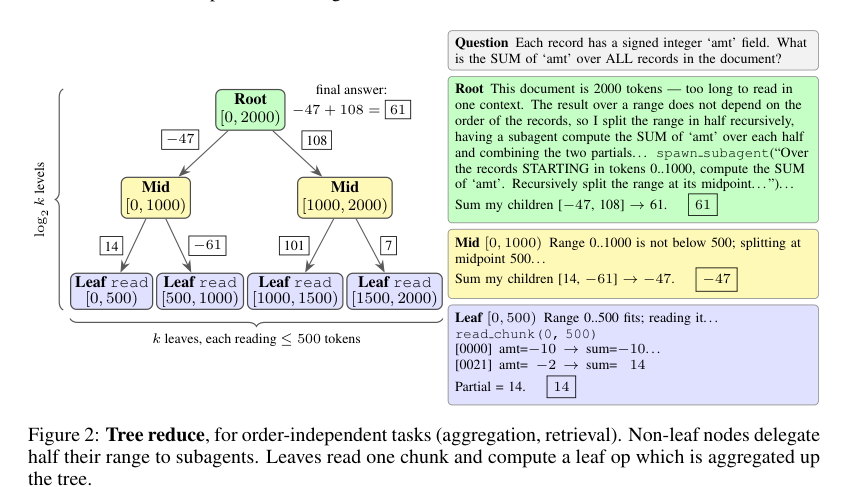
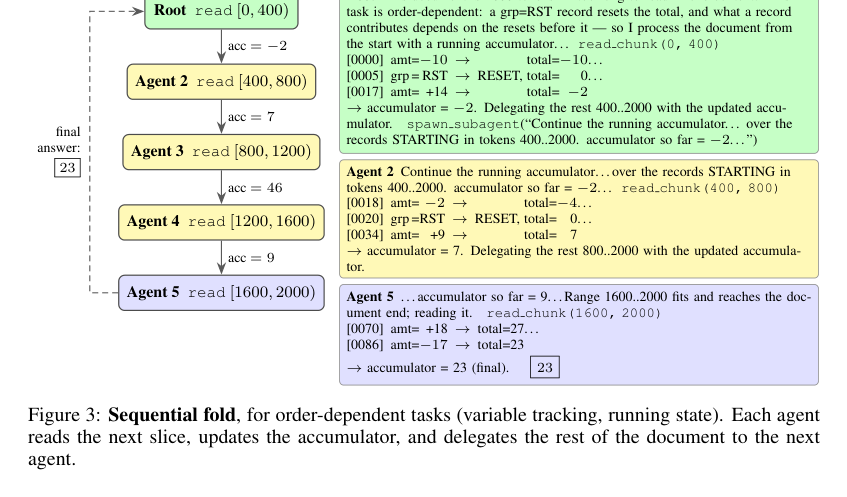
提案手法では、モデルに対し「任意の指定プロンプトによる自己呼び出し」と「入力文脈からの特定範囲のトークン読み取り」というプリミティブな操作のみを許可している。これにより、モデルは長大な文書全体を一度に保持するのではなく、必要な箇所を選択的に取得・再帰的に処理することができる。タスクの性質に応じて、順序非依存タスク向けにはツリーリダクション(Tree reduce)戦略(図2)、順序依存タスク向けにはシーケンシャルフォールド(Sequential fold)戦略(図3)が適用される設計となっている。
評価・考察
OOLONG-synth ベンチマークを用いた評価において、ドキュメント長が 40,000 トークンを超える領域で、ベースとなる小型モデル(Qwen3.6-35B-A3B)が 100 万トークン規模のコンテキストを持つ GPT-5.4 と同等の精度を達成したことが確認されている。この結果は、コンテキスト長の物理的な大きさよりも、エージェント的な文脈管理能力の有無が長文脈推論の成否を決定づける強力な証拠となっている。
応用例と今後の展望
法的文書の解析や数万行に及ぶコードベースのリファクタリングなど、極めて長いコンテキストを必要とする実務領域において、GPU メモリの制約を大幅に軽減しながら高精度な推論を行うシステムの実装が可能となる。国内のAI関連企業や自然言語処理の研究室において、大規模なクラスタ資源を持たない中小規模のチームでも、数千トークン規模のベースモデルを活用して長文脈処理エージェントを構築するアプローチが実用的な選択肢として浮上する。
結論
本論文は、長文脈処理において巨大なコンテキスト窓をネイティブに持たせる従来の方針に対し、エージェント的な自己管理ツールを通じた軽量な解決策を提示した。8,000 トークンの制約下で 100 万トークン級の性能を実現した事実は、今後の LLM アーキテクチャおよび推論効率化の研究に大きな影響を与える。
注釈
- OOLONG-synth: 長文脈言語モデルの推論・情報抽出能力を評価するための合成ベンチマーク。
- Qwen3.6-35B-A3B: 本研究のベースとして採用された 35B パラメータ規模の言語モデル。