3B/8B 連続拡散言語モデル Sigma──離散型を凌駕する推論軌道制御と数理・コード性能を実証
連続的 ODE/SDE 潜在軌道に基づく大規模連続拡散言語モデル Sigma を提案し、GSM8K や HumanEval などの標準ベンチマークで既存の離散型拡散モデルおよび AR モデルと同等の性能を達成した。
リリース: 2026-10-02 · 読了 5 分論文概要
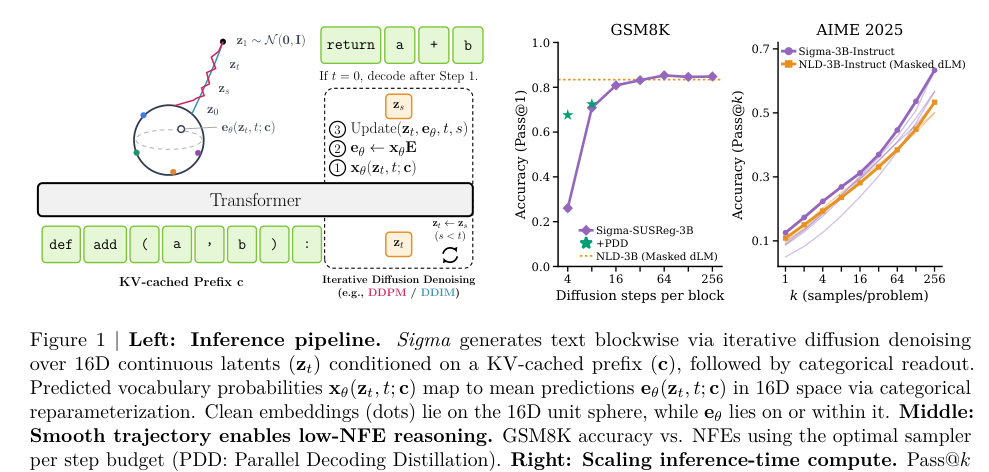
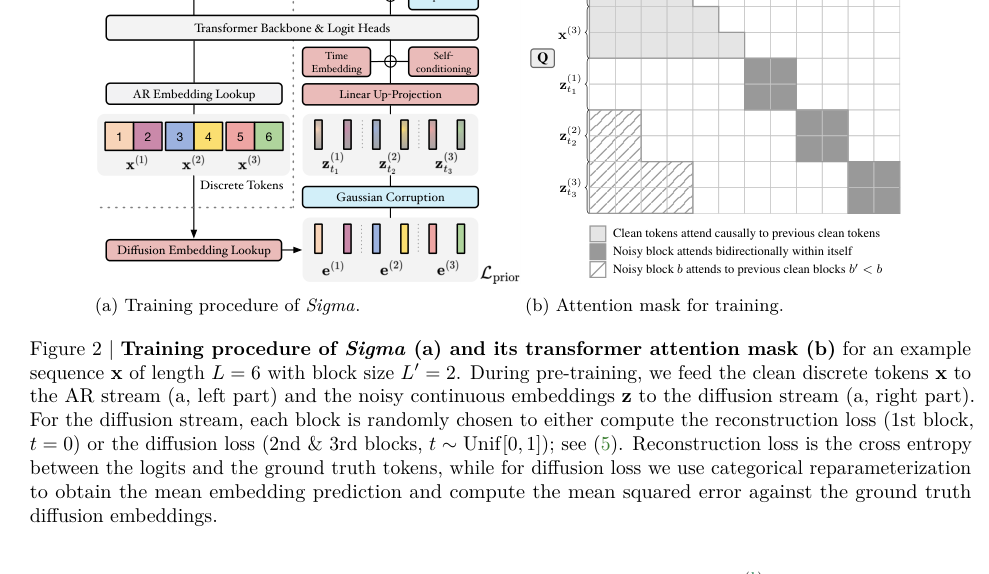
従来の離散型拡散言語モデル(dLMs)は高速な並列デコーディングを可能にする一方で、非滑らかかつ高次元な空間が推論や軌道制御の妨げとなっていた。本論文では、制御可能な低次元 ODE/SDE 潜在軌道に基づく初の大規模(3B/8B)連続拡散言語モデル「Sigma」を提案する。ブロック単位の尤度最適化によって訓練され、ガウスノイズに汚染されたトークン埋め込みの同時ノイズ除去と最適埋め込み幾何学の学習を両立する。
関連研究
テキスト生成分野では autoregressive (AR) モデルが主流であり、近年では高速並列生成を目指してマスクド拡散モデル等の離散型 dLMs が研究されてきた。しかし、離散空間におけるサンプリングの非連続性が高度な推論時の軌道制御を困難にしていた。本研究は、連続空間上で拡散プロセスを適用することで、生成軌道の制御性と品質・多様性のトレードオフの最適化を図る点で先行研究と異なる。
新規性と貢献
主要な貢献は以下の通りである。第一に、3B および 8B パラメータ規模の大規模連続拡散言語モデルを初めて構築・学習したこと。第二に、事前学習済み AR モデルの重みを利用したウォームスタートにより学習効率を飛躍的に高めたこと。第三に、埋め込み空間でのステアリングにより品質と多様性のトレードオフを高度に制御可能にした点である。
提案手法の詳細
Sigma は、ガウスノイズが加わったトークン埋め込みをブロック単位で反復的にデノイジングする連続拡散モデルである。直感的な設計として、既存の成熟した AR モデルの重みを初期値として流用(ウォームスタート)することで、ゼロからの大規模学習に伴うコストと難易度を大幅に削減している。また、推論時には Classifier-Free Guidance とスコア温度(score temperature)が、高精度な推論およびコード生成において不可欠であることを見出している。
評価・考察
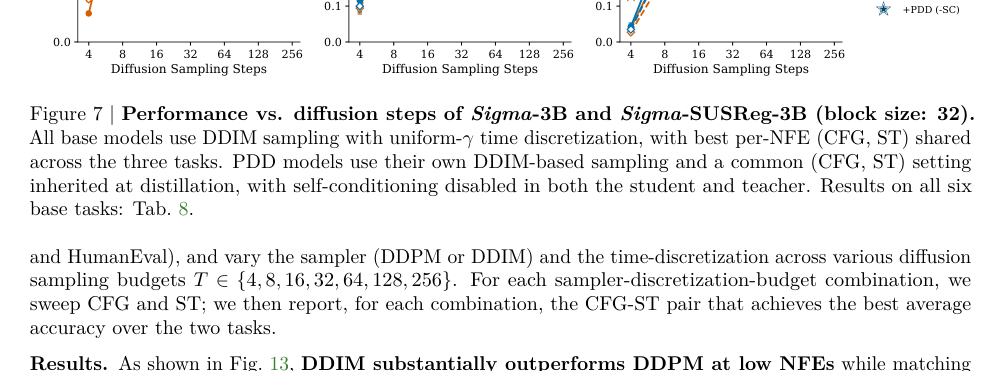
数学的推論およびコード生成の包括的な評価において、事前学習後の標準ベンチマーク(GSM8K、Minerva、HumanEval、MBPP)および、教師あり微調整後の高難度推論タスク(MATH-500、AIME)で、既存の離散型拡散モデルや AR ベースラインと競合する性能を達成した。さらに、低 NFE(Function Evaluation 回数)における優雅な性能劣化や、効率的な蒸留が可能であることが確認されている。
応用例と今後の展望
実務インパクトとして、国内の金融・医療データ解析など、厳密な制約下でのテキスト生成や軌道制御が求められる領域における応用が期待される。特に、数百パラメータ規模のモデルでの高速並列デコーディングや、推論時の動的な出力制御を必要とするテックリード層にとって、次世代アーキテクチャの有力な選択肢となる。今後の課題としては、さらなる長文脈化や推論ステップ数の削減に向けた蒸留手法の最適化が挙げられる。
結論
大規模連続拡散言語モデル Sigma は、連続的潜在軌道を用いたテキスト生成が AR モデルや離散型拡散モデルに匹敵する性能を発揮することを示し、効率的な言語生成の新パラダイムを確立した。
注釈
- dLMs (Discrete Diffusion Language Models): 離散空間をベースにした拡散言語モデル。トークンの追加や削除・置換をマルコフ連鎖的にモデル化する。
- NFE (Number of Function Evaluations): 拡散モデルのサンプリング時におけるモデルの順伝播実行回数。少ないほど高速。