より小さな凍結モデルが強力な選好リジェクトを生成──コード・数学推論タスクでの検証
7Bから72Bまでのモデルを用いた検証により、小規模モデルから生成されたリジェクトが効率的な推論コストで優れた生徒モデルを育成できることを実証した。
リリース: 2026-09-30 · 読了 5 分論文概要
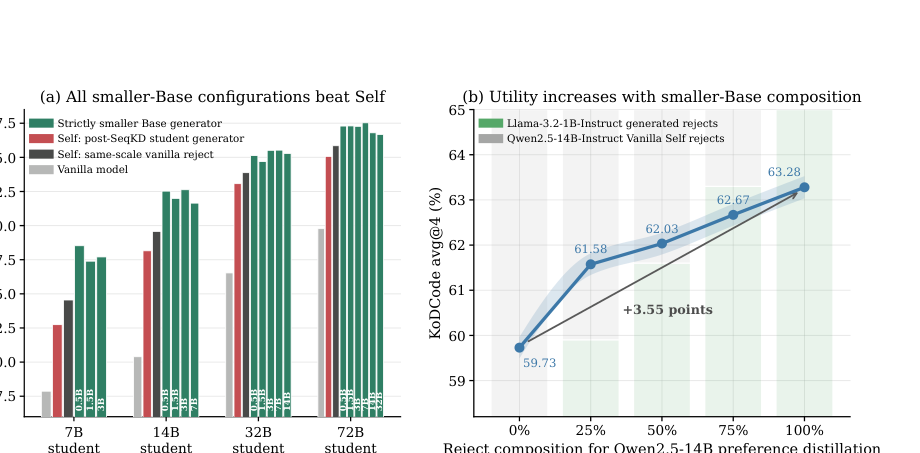
選好蒸留(Preference Distillation)において、従来は「教師モデルの応答を好み(preferred)、生徒モデル自身の失敗応答を拒否(rejected)とする」設計が一般的であった。しかし本研究では、7Bから72Bまでのモデルを用いた検証を通じて、より小さな凍結モデルが低コストでより強力なリジェクトを生成できることを明らかにした。コード生成および数学的推論タスクにおいて、小規模モデル由来のリジェクトを用いることで、自己生成されたリジェクトよりも優れた生徒モデルを学習できることが示されている。
関連研究
従来の手法では、セルフプレイや生徒モデルと同等以上の大規模モデルを用いたネガティブ応答のサンプリングが前提とされていた。これらは生成コストが膨大になるという課題を抱えていたが、本研究は、リジェクトの生成元モデルの規模と性能に関する従来の仮定に疑問を投げかけ、計算効率と学習効率を両立する新しいアプローチを提案する。
新規性と貢献
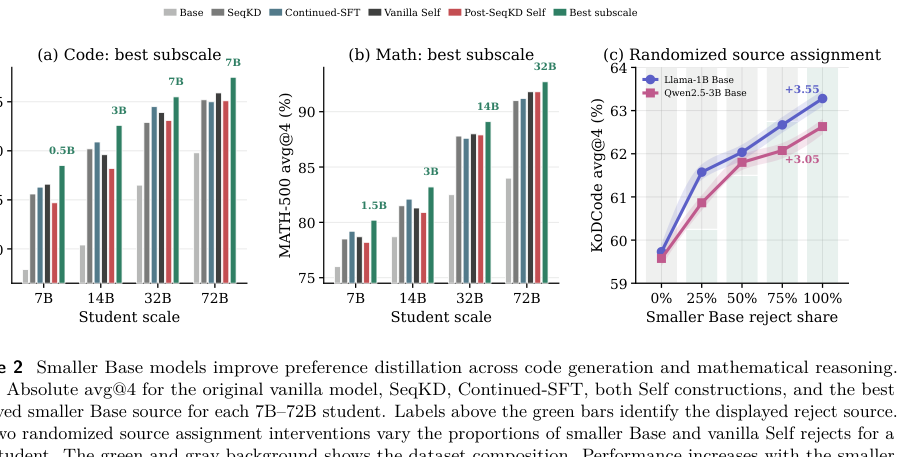
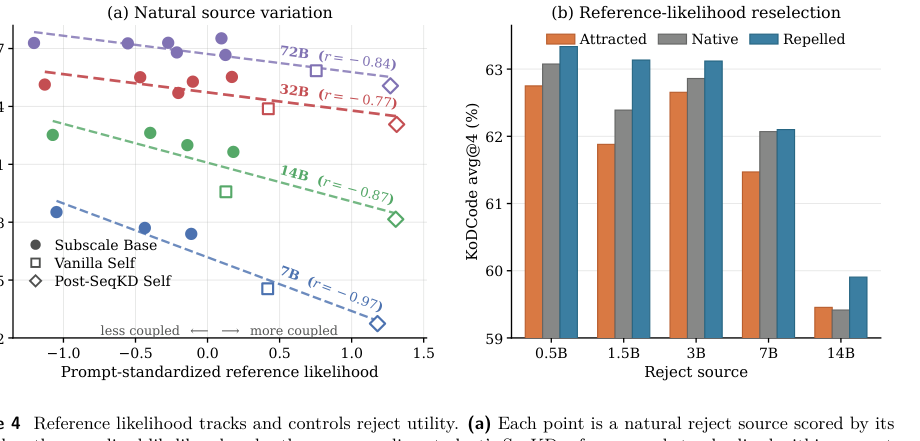
本研究の主要な貢献は、線形化された特徴モデルにおけるDPO(Direct Preference Optimization)の有限地平ユーティリティ境界を導出した点にある。これにより、好ましいリジェクト分布の特性が理論的にキャラクタライズされ、以下の3つの介入手法が導かれた。まず、小規模モデルと生徒スケールモデルのリジェクトを混合することで性能が向上すること。次に、タスク構造の保持がリジェクトの有用性に寄与すること。最後に、参照ポリシー下で尤度が低い候補を選択することがネットの転移性能を改善することを見出した。
提案手法の詳細
提案された解析と介入は、リジェクトデータが持つべき構造を明確にしている。リジェクトを他のプロンプトへ再割り当てしたりコードトークンをシャッフルした場合でも、長さが一致した無意味なテキスト(gibberish)を上回る性能を示し、タスク構造の維持が重要であることを裏付けた。また、参照ポリシーに対する尤度が低い候補を選択することで、高尤度の候補が提供するコントラストの弱さを補い、より効果的な学習シグナルを得る設計となっている。
評価・考察
実験では、コード生成および数学的推論の領域において、7Bから72B規模のモデルを対象に検証が行われた。小規模な凍結モデルを用いたリジェクト生成は、推論計算量を削減しながらも、シーケンスレベルの知識蒸留の前後を問わず強力な生徒モデルを育成できることが確認された。すべてのソースにおいて、低尤度の選択肢を高尤度の選択肢よりも優れた結果を収めており、リジェクトの選択基準に関する新たな知見を提供している。
応用例と今後の展望
本手法は、大規模言語モデル(LLM)の強化学習や選好最適化における計算コストを劇的に削減する可能性を持つ。特に、自動コード生成や高度な数学推論システムを開発する国内のAI基盤開発企業や研究組織において、高価な大規模教師モデルを使わずに効率的なアライメント学習を行うための実務的なアプローチとして活用できる。今後の課題としては、より多様なタスクドメインへの適用範囲の拡張や、最適な混合比率の自動化が挙げられる。
結論
本研究は、選好蒸留におけるリジェクト生成は必ずしも大規模モデルを必要とせず、小規模な凍結モデルによって効率的かつ高品質に提供できることを理論と実験の両面から証明した。効果的なリジェクトがタスク構造を維持しつつ参照ポリシーとの結合を制限するという知見は、今後のモデルアライメント手法の設計に大きな指針を与える。
注釈
- DPO (Direct Preference Optimization): 言語モデルの選好最適化を報酬モデルなしで直接行う手法。
- 参照ポリシー (Reference Policy): 学習時に過度な逸脱を防ぐための基準となる元の言語モデル。