Transformer はなぜ思考を早々に打ち切るのか──層の凍結とランク 8 LoRA による長文脈チェーン計算の拡張
事前学習済み Transformer が文脈参照の追従に層の深さをほとんど活用していない問題に対し、1つの早期レイヤーにランク8のLoRAを適用して計算の継続とリレー機構を引き起こす手法を提案し、Qwen3-8Bの24行チェーン精度を15.5%から99%へ改善した。
リリース: 2026-09-29 · 読了 5 分論文概要
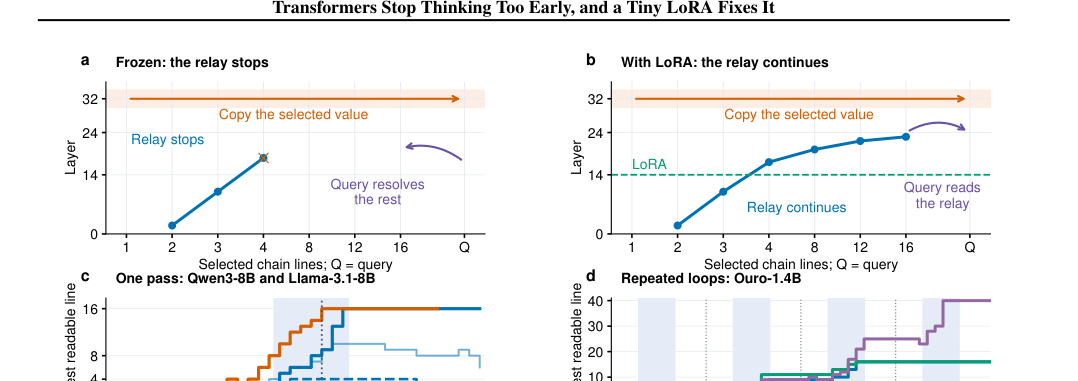
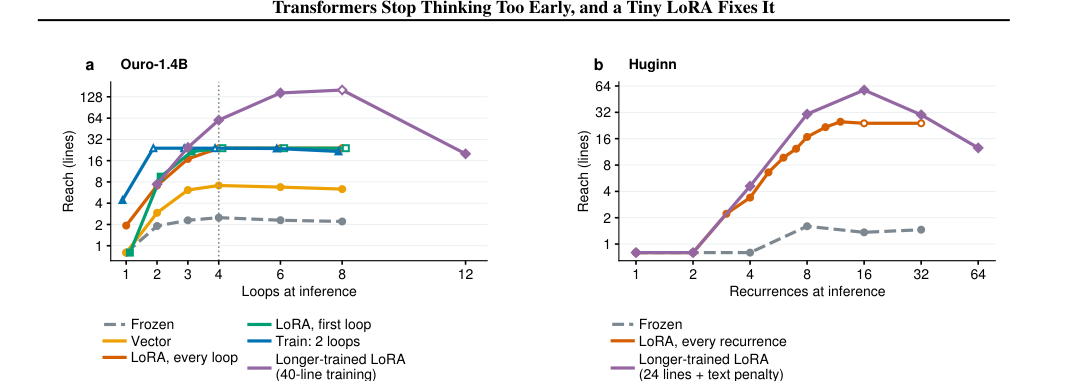
事前学習済みの Transformer モデルが、文脈中の参照関係を追跡する際に、そのモデルが持つ全体の深さをほとんど活用できていないという現象に焦点を当てた研究である。調査された13のベースモデルは、信頼性を持って追跡できるのがわずか1.4〜3.6行に留まっており、追加の事前学習ループを回しても改善は限定的であった。本論文では、モデルの全重みを凍結した状態で、特定の早期レイヤーにランク 8 のタスク訓練済み LoRA(Low-Rank Adaptation)を1つ挿入するという極めて軽量な手法により、計算量を大幅に拡張できることを示した。Qwen3-8Bを用いた実験では、24行のチェーン推論における完全一致精度(Exact Accuracy)が15.5%から99%へと劇的に向上し、より長く訓練したLoRAでは50行に達した。また、Ouro-1.4Bモデルでは4つのループ後に60行、8つのループ後には160行以上の到達長を記録している。本研究は、デフォルトのモデル出力が潜在的にアクセス可能な計算量を過小評価していることを実証している。
関連研究
Transformer の計算能力の限界や、推論時計算量(Test-time compute)を拡張するための手法に関する先行研究が多数存在する。多くの従来手法は、モデル全体の再学習や、追加の推論ステップ(思考プロセス)をモデル全体に強制するアプローチをとってきた。これに対し本研究は、モデル全体の重みを変更せず、局所的な表現の変更が層をまたいだ「リレー」を引き起こすというメカニズムに着目している点に特徴がある。
新規性と貢献
本研究の最大の新規性は、モデルの大規模な拡張や再学習を行うことなく、わずかランク 8 の LoRA を1つの早期レイヤーに導入するだけで、モデル内部の計算停止現象を回避し、長文脈の連鎖的な推論能力を飛躍的に引き出せる点を解明したことである。学術的・実用的な貢献として、モデルの深さ方向の計算がどのように打ち切られているかというメカニズムの解明と、MuSiQueなどのタスクにおける汎用的な性能向上を同時に達成したことが挙げられる。
提案手法の詳細
提案手法の核心は、早期の特定レイヤーにタスク特化型のランク 8 LoRA を1つだけ挿入し、他の全てのモデル重みを凍結することにある。これにより、プログラムの行情報が短い範囲の中間層を介して次の層へチェインIDとして引き継がれる「リレー」の起点を作り出す。凍結されたアテンションヘッドは、チェーンに沿ってより深い部分まで段階的に情報を読み取ることが可能になり、親ラインのアテンションを除去するとこのリレーが停止することが確認されている。この設計により、パラメータ数を抑えつつ、モデルが本来持っている深さ方向の計算ポテンシャルを効率的に引き出すことができる。
評価・考察
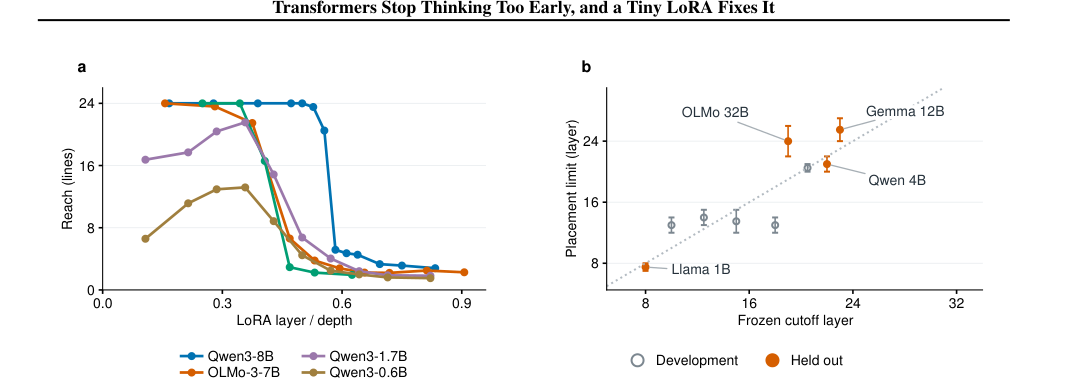
評価実験では、複数のベースモデルとタスクを用いて検証が行われた。Qwen3-8Bを用いた24行のチェーン推論タスクでは、ベースラインの15.5%から99%へと精度が急上昇した。Ouro-1.4Bモデルにおいては、4つのループで60行、8つのループで160行以上のチェーン到達長を達成している。また、凍結モデルを用いた計測により、4つのホールドアウトモデルのうち3つで、許容誤差範囲内で最後に有用な介入レイヤーを特定することに成功した。さらに、タスク特化型 LoRA は MuSiQue タスクにおいても性能改善を示しており、特定の局所的介入が多様な推論タスクに有効であることが示されている。
応用例と今後の展望
本手法は、計算コストを最小限に抑えながら長文脈や複雑な推論を必要とする LLM アプリケーションの構築において極めて高い実用性を持つ。国内のAI関連企業や自然言語処理の研究分野において、大規模モデルのフルスクラッチ学習や重み全体の微調整を行わずとも、特定レイヤーへの超軽量な LoRA 適用だけで高度な長文脈処理能力を引き出せるため、LLMの実装・運用コスト削減の観点で大きな実務インパクトを持つ。今後の課題としては、より多様な実世界タスクや異なるアーキテクチャへのスケーラビリティの検証が挙げられる。
結論
Transformer モデルが早々に思考を打ち切る原因を解明し、単一の早期レイヤーへのランク 8 LoRA 挿入という極めて小規模な介入によって、モデルの計算能力を劇的に拡張できることを示した。本研究は、デフォルトの出力が示す限界を超えて、既存モデルのポテンシャルを最大限に引き出すための新しい設計指針を提供するものである。
注釈
- LoRA (Low-Rank Adaptation): 大規模言語モデルの重みを固定したまま、低ランクの行列を追加することで効率的に微調整を行う手法。
- MuSiQue: 複数の文書を横断して推論を行うマルチホップ質問応答のベンチマークタスク。