ストリーミング動画対話の知覚・記憶・応答を統合する 4B モデル OneStreamer ── 8 つの評価ベンチマークで最高性能を達成
プロアクティブ階層型キャプションメモリと状態遷移学習により、リアルタイム知覚を損なうことなく再利用可能な事実的メモリを形成し、既存手法を凌駕する性能を実現した。
リリース: 2026-10-01 · 読了 5 分論文概要
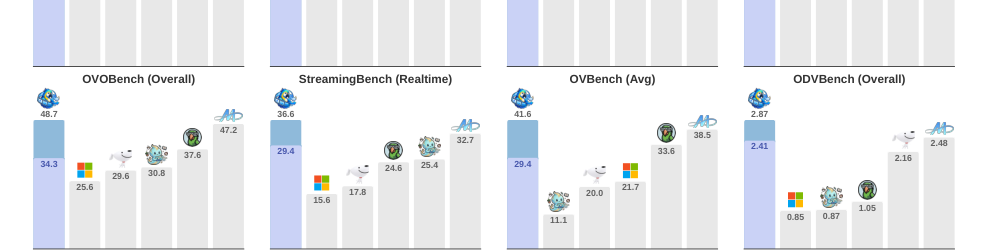
ストリーミング動画対話モデルにおいて、未来のタスクへの関連性が不明な段階証拠の保持と、十分な証拠が揃った時点での適切な応答生成を両立させることは困難であった。本論文では、クエリ非依存のエビデンス記録とタスク応答を共有プロアクティブ生成プロセスを通じて共同学習するフレームワーク「OneStreamer」を提案する。4Bパラメータを持つモデルにより、8つの評価されたストリーミング動画理解ベンチマークすべてにおいて既存手法の中で最高の結果を達成した。
関連研究
従来のストリーミング動画処理や動画理解モデルでは、リアルタイムの視覚的知覚を優先するあまり過去の長期的文脈の保持が不足するか、あるいは履歴特徴量を高コストで保持し続けるアプローチがとられてきた。本研究では、過去の視覚特徴量を再訪問することなく、再利用可能な事実的コンテキストを提供するメモリー機構の導入により、既存の限界を克服している。
新規性と貢献
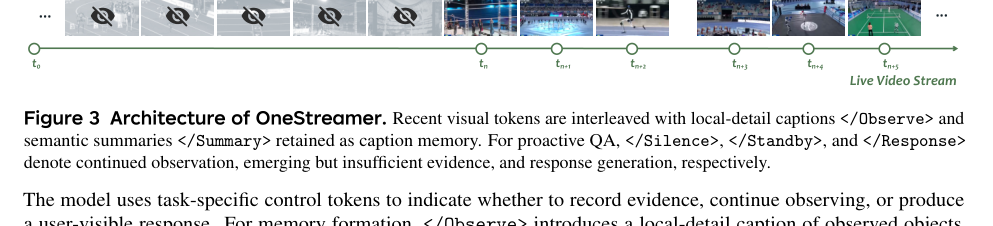
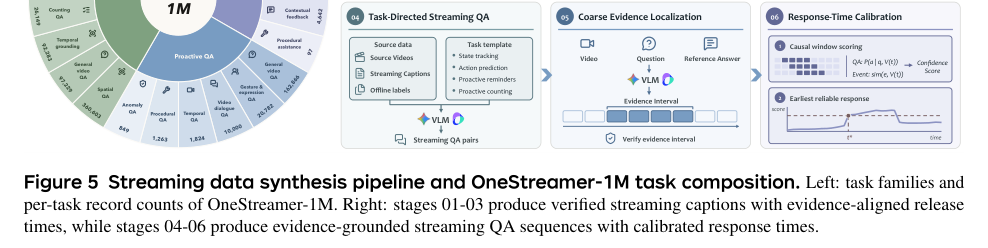
主な貢献は以下の通りである。第一に、プロアクティブ階層型キャプションメモリ(PHCM)の導入により、時間的にグラウンドされたローカル詳細キャプションと完了イベントの要約を生成し、過去の視覚的特徴量を再度読み込むことなく事実的コンテキストを補完可能にした点である。第二に、Proactive State Transition Learning (PSTL) により、アノテーションされた状態トークンのわずか 27.5% を監督するのみで、高密度な状態監督を凌駕する効率的な学習を実現した点である。第三に、100 万件を超える多様なタスクレコードを含むストリーミングデータセット「OneStreamer-1M」を構築・公開した点である。
提案手法の詳細
OneStreamer は、知覚・記憶・応答を統一するインターフェースとしてプロアクティブ生成を採用している。PHCM は観察された動画プレフィックスの解釈を学習中に監督し、推論時には最近の視覚ウィンドウをモデル生成レコードで補完する。また、PSTL は全ての出力アンカーで監督を保持し、代表的な状態変化および状態持続トークンを選択することで、繰り返される待機状態の支配を軽減する。
評価・考察
4B サイズの OneStreamer モデルは、8 つの評価ベンチマークすべてにおいて比較手法の中で最高の結果を示した。アブレーションスタディにより、生成されたキャプションの保持がリアルタイム知覚を劣化させることなく歴史的 QA の精度を向上させることが示された。さらに、PSTL はアノテーションされた状態トークンの 27.5% のみを監督しながら、高密度な状態監督手法を上回る性能を実証した。
応用例と今後の展望
本手法は、リアルタイムの監視カメラ映像解析や、ライブストリーミングのインタラクティブアシスタントなどの分野において応用可能である。日本の監視カメラシステムやセキュリティ関連企業におけるリアルタイム異常検知・対話システムの実装において、メモリ消費量を抑えつつ長期的な文脈理解を組み込むための設計指針となる。今後の課題として、より多様な実世界ストリーミング環境における頑健性の検証と、さらなるパラメータ効率の向上が挙げられる。
結論
OneStreamer は、プロアクティブ生成に基づく階層型キャプションメモリと状態遷移学習により、ストリーミング動画対話における知覚、記憶、応答を統合することに成功した。ベンチマークにおける最高性能の達成は、今後のストリーミング動画理解モデルのアーキテクチャ設計に重要な基盤を提供する。
注釈
- Streaming Video LLM: 入力される動画ストリームに対し、リアルタイムで知覚・応答・記憶を行う大規模言語モデル。
- Proactive Generation: モデルが自発的・積極的に情報を生成・記録するプロセス。