LLM の事後学習における探索能力低下を定量化する Sharpening Tax と適応型サンプリング手法 PTGS
強化学習による事後学習がモデルの解法網羅性を低下させる現象を Sharpening Tax として定量化し、テスト時計算の効率を改善する適応型サンプリング手法 PTGS を提案する。
リリース: 2026-10-01 · 読了 5 分論文概要
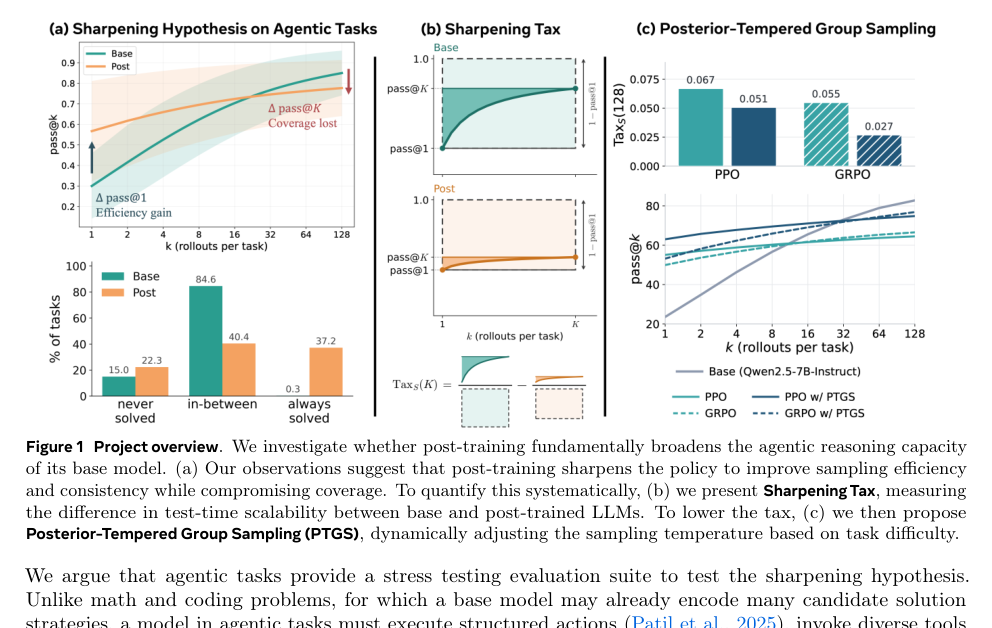
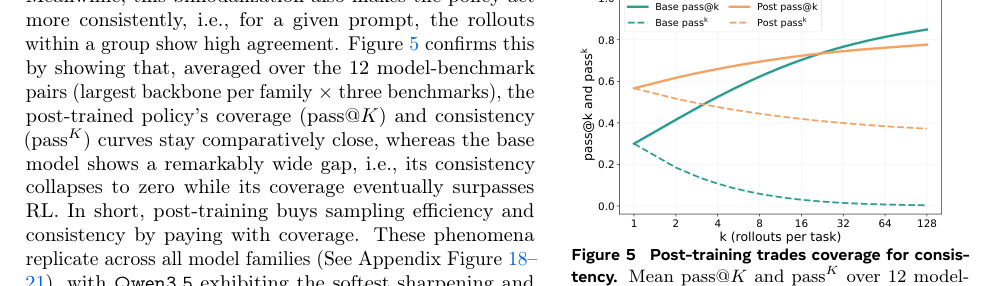
大規模言語モデル (LLM) の強化学習 (RL) による事後学習は、単発の推論精度 (pass@1) を高める一方で、解法の網羅性(solution coverage: pass@K)を犠牲にするトレードオフがあることが知られている。本論文では、この現象がエージェントタスクにおいても発生することを明らかにし、事後学習によるテスト時スケーラビリティの損失を定量化する診断指標「Sharpening Tax」を提案する。さらに、プロンプトの難易度に応じてサンプリング温度を適応的に調整するプラグイン型のベイズサンプラー「Posterior-Tempered Group Sampling (PTGS)」を提案し、サンプリング効率と単発精度の両立を実現している。
関連研究
LLM の事後学習におけるアライメントや強化学習の最適化においては、モデルが特定の出力分布に収束することで多様性が失われる問題が指摘されてきた。数学やコーディングのタスクでは単発精度の向上が優先される傾向にあるが、複数ターンのツール利用を伴うエージェントタスクでは、多様な解法アプローチを維持することがテスト時計算バジェットの活用において重要となる。
新規性と貢献
本研究の主要な貢献は、事前学習済みモデルが軽量な推論ハーネスを備えることで、事後学習モデルを凌駕する解法網羅性(pass@K)を発揮できる点を発見したことである。また、事後学習がタスクを「常に解ける」または「全く解けない」の 2 極に偏らせるメカニズムを分析し、これを Sharpening Tax として定量化した。4 つのモデルファミリーからなる 14 のベース/事後学習済みモデルペアと 3 つのエージェントベンチマーク(計 42 ケース)を用いた網羅的な評価が行われている。
提案手法の詳細
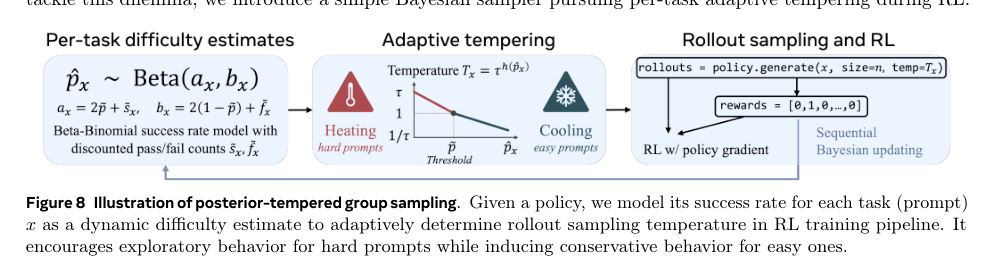
Sharpening Tax は少数のロールアウトから推定可能であり、事後学習によるスケーラビリティの低下を正確に測る。これを克服するため、著者らは Posterior-Tempered Group Sampling (PTGS) を提案した。PTGS は、プロンプトの推定難易度に応じて事後分布に基づくサンプリング温度を動的に適応させるベイズサンプラーであり、固定温度のベースラインと比較してタスクの二極化を緩和する。
評価・考察
2 つのエージェント環境における RL トレーニングへの適用実験において、PTGS は固定温度のベースラインに比べて小さな Sharpening Tax しか支払わず、繰り返しサンプリング下でより多くのタスクを解決しつつ、単発の精度向上も同時に達成した。
応用例と今後の展望
エージェントシステム開発において、複数回の推論試行(Test-time compute)を活用して複雑なタスクを自動解決するアーキテクチャの設計において有用な知見を提供する。国内のAI関連の受託開発・SaaS企業やR&D部門において、LLMエージェントの強化学習およびファインチューニングを行う際、単発精度だけでなく網羅性(pass@K)の低下を防ぐためのサンプリング戦略の見直しに直接的な示唆を与える。
結論
事後学習がもたらす探索能力の低下(Sharpening Tax)の存在を明らかにし、それを定量化する指標と、適応的サンプリングによる解決策(PTGS)を提示した。
注釈
- Sharpening Tax: 事後学習によってモデルの出力がシャープになり、探索空間が狭まることで発生するテスト時スケーラビリティの損失を表す診断指標。
- PTGS (Posterior-Tempered Group Sampling): プロンプトの難易度に応じてサンプリング温度を動的に調整するベイズサンプラー。