連続型拡散言語モデルの性能を左右するテキスト埋め込みの最適化手法──T5Gemma-2 蒸留により Gen. PPL 17.8 を達成
テキスト埋め込みのスケールアップとソフトラベル蒸留により、拡散言語モデルの潜在空間を滑らかにし、OpenWebText で GPT-2-M を上回る生成 Perplexity を実証した。
リリース: 2026-10-01 · 読了 5 分論文概要
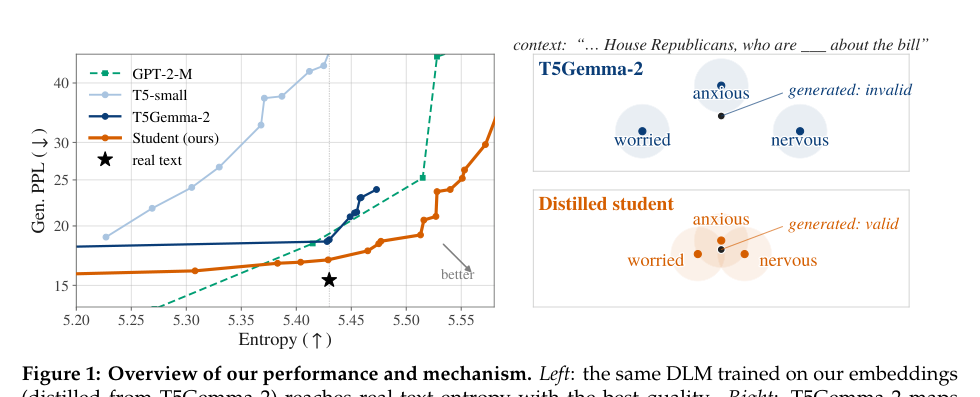
Diffusion language models (DLMs) において、連続的なテキスト埋め込み空間の設計が生成性能に与える影響を調査した論文。T5 から T5Gemma-2 へのスケールアップにより生成性能が向上することを確認しつつ、そのままでは埋め込み空間が分離しすぎる課題を指摘した。教師モデルのデコード確率をソフトラベルとして学習する蒸留手法を導入することで、OpenWebText において Gen. PPL 17.8(実テキスト PPL 15.4)を達成し、GPT-2-M を上回る生成性能を示した。
関連研究
従来の autoregressive (AR) 言語モデルに代わる選択肢として、連続的な潜在空間で拡散プロセスを利用する連続型 DLM の研究が進められている。本研究は、どのような埋め込み空間が拡散に適しているか(diffusible か)という問いに対し、既存モデルのスケールと蒸留の観点からアプローチしている。
新規性と貢献
主要な貢献は以下の 2 点である。第一に、同一系統のテキストエンコーダーのスケールアップ(T5 から T5Gemma-2)が拡散言語モデルの生成性能を大幅に改善することを実証した点。第二に、強力すぎるエンコーダー特有の「識別的すぎる埋め込み」がサンプリングの失敗を招く問題に対し、ソフトラベルを用いた蒸留によってより連結された拡散しやすい潜在空間を構築した点。
提案手法の詳細
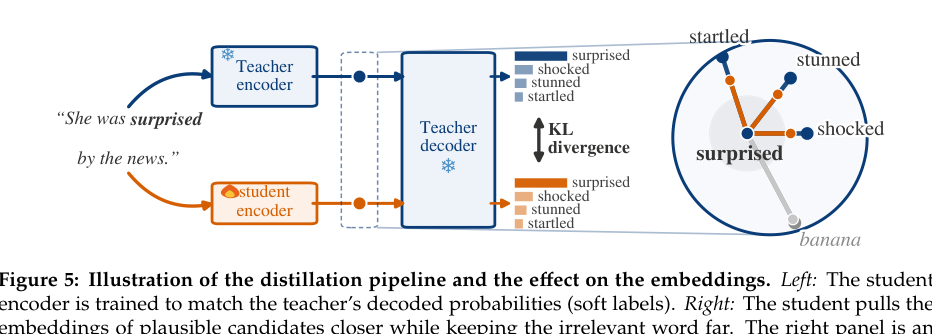
T5Gemma-2 の生のエッジ埋め込みは、妥当な代替単語の埋め込みすら大きく分離させるため、不完全なサンプリング時に無効な埋め込みへと陥りやすい。これを解決するため、教師モデルのデコード確率をソフトラベルとして学習する生徒エンコーダーを設計した。これにより、エンコード・デコード機構を維持しながら代替埋め込み同士が近接し、連続的な拡散が安定する。
評価・考察
OpenWebText を用いた評価において、提案する中規模 DLM は real-text PPL 15.4 に対し Gen. PPL 17.8 を記録した。これは GPT-2-M の生成 PPL を上回る数値であり、拡散ベースの言語生成における連続埋め込み最適化の有効性を裏付けている。
応用例と今後の展望
非自己回帰的なテキスト生成や高速な並列推論を必要とする自然言語処理分野への応用が見込まれる。日本の音声・テキスト処理の R&D 部門やテックリードにとって、AR モデル以外の選択肢として DLM の実装設計や潜在空間の蒸留手法を検討する際の重要な基礎知見となる。今後の課題としては、さらなる大規模モデルへの適用や多様なドメインでのスケーラビリティ検証が挙げられる。
結論
本研究は、テキスト埋め込みのスケールアップとソフトラベル蒸留の組み合わせが、拡散言語モデルの潜在空間を改善し、生成品質を大きく引き上げることを示した。
注釈
- Diffusion language models (DLMs): 拡散モデルの枠組みをテキスト生成に応用したモデル。非自己回帰的な並列生成が可能。
- Perplexity (PPL): 言語モデルの予測性能を測る指標。値が低いほど自然な文章を生成できていることを示す。