実ファイルと証拠グラフでマルチステップ作業エージェントを訓練する GraphForge フレームワーク
実ファイルの証拠グラフからタスクと検証用ルブリックを自動合成し、Qwen3.6-27B の GDPVal を 1445.7 (+65.7) に向上させた。
リリース: 2026-09-30 · 読了 5 分論文概要
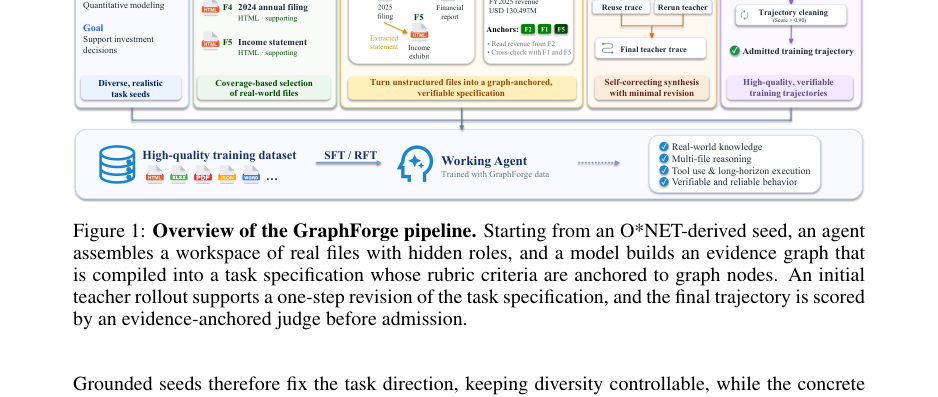
AI エージェントの実務適用において、多様なファイルの読込やツールの調整、成果物の作成を伴うマルチステップタスクの訓練は、検証可能な結果を持つデータセットが不足しているという課題がありました。既存のパイプラインはモデルによるファイル生成に依存して現実味や多様性が欠けるか、あるいは実ファイルを用いつつもタスク固有の検証機構がないという問題がありました。本論文では、実ファイルに基づいてタスクとその検証をグラウンディングする証拠グラフベースのフレームワーク「GraphForge」を提案しています。GraphForgeを用いることで、Qwen3.6-27Bなどのモデルのファインチューニングや拒否サンプリング(Rejection Fine-Tuning)が大幅に強化され、主要なベンチマークで顕著な精度向上を記録しています。
関連研究
従来のエージェント向けデータ合成手法は、LLMによって完全に人工的なタスクやファイルを生成するアプローチが主流でしたが、実際の業務環境におけるファイル形式の複雑さや多様性を十分に再現できていませんでした。また、実世界のリポジトリやドキュメントをそのまま利用するアプローチでは、正解判定のための自動検証ルール(ルブリック)が曖昧になりやすく、強化学習や教師あり学習(SFT)における良質なシグナルが得られない問題がありました。本研究は、実ファイルを組み込んだ上で、ファイル間の関係性を証拠グラフとして明示的にモデル化し、タスクの要件と検証基準を同時に導出する点で既存手法と一線を画しています。
新規性と貢献
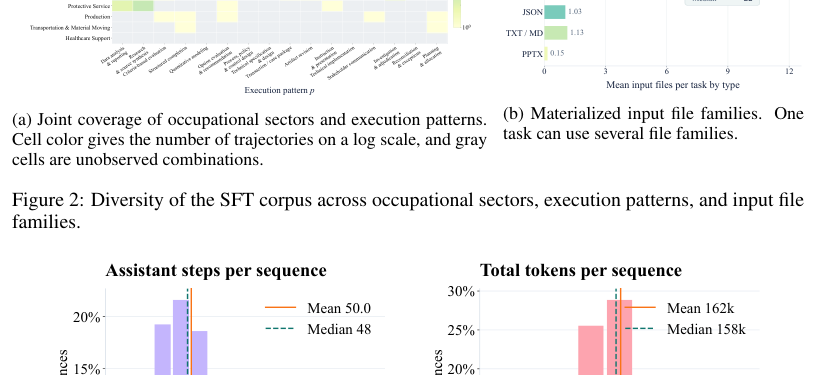
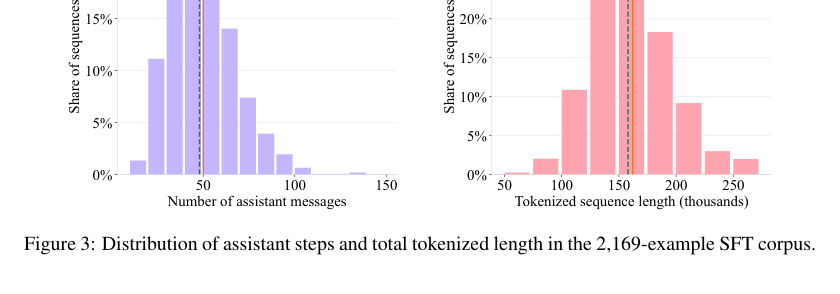
本研究の主要な貢献は以下の通りです。第一に、職業データ(O*NETなど)に基づくシードから制御された多様性を確保しつつ、実ファイルを用いたワークスペースとそれらの関係を示す証拠グラフを自動構築するフレームワークの提案です。第二に、タスクの要件定義と検証用ルブリックの双方を証拠グラフから一貫して導出することで、検証可能性を担保した点です。第三に、GraphForgeによって生成された 2,169 件の軌跡を用いて Qwen3.6-27B をファインチューニングし、GDPVal、Workspace-Bench-Lite、SpreadsheetBench II の各ベンチマークで圧倒的な性能向上を実証した点です。
提案手法の詳細
GraphForge のパイプラインは、職業由来のシードから制御された多様性を持つタスクの起点を決定することから始まります。次に、各シードに対して現実のファイルを収集・配置したワークスペースを構築し、ファイル間の関連性に基づく「証拠グラフ(Evidence Graph)」を形成します。タスクの記述や評価ルブリックはこの証拠グラフから直接導出されるため、各検証基準が必要なファイルに確実に戻る構造となっています。初期ロールアウトによる実行可能性のテストを経て、修正エージェント(Revision Agent)が元ファイルに照らし合わせてタスクとルブリックを修復し、最終的な学習軌跡が収集されます。
評価・考察
評価実験では、2,169件の GraphForge 軌跡を用いて Qwen3.6-27B をファインチューニングした結果、OpenHands 環境下での GDPVal が 1445.7 となり、ベースラインから 65.7 ポイント向上しました。さらに、Claude Code 環境下における Workspace-Bench-Lite および SpreadsheetBench II でも、それぞれ 63.7(+7.7pt)、24.0(+13.7pt)を記録しました。加えて、証拠グラフに基づくルブリックを基準としたSFTモデル自身のロールアウトに対する拒否ファインチューニングを実施したところ、すべてのベンチマークでさらなる精度向上が確認され、証拠に裏付けられた検証ルブリックが有効な選択シグナルとして機能していることが示されています。
応用例と今後の展望
実務への応用として、金融・法務・コンサルティング業などのデータ分析や複雑なドキュメント編集を伴う領域において、マルチステップで自律的に動作するAIエージェントの開発コストを大幅に削減できる可能性があります。日本のエンジニアやテックリードが、社内の多様な実ファイルを扱わせるカスタムエージェントを構築・検証する際、本手法の「証拠グラフによるタスク・ルブリックの自動合成」の設計思想は極めて有用な参照実装となります。今後の課題としては、より多様な非構造化データや大規模ワークスペースへのスケーラビリティ検証が挙げられます。
結論
GraphForge は、実ファイルと証拠グラフを用いたワークスペース合成により、検証可能なマルチステップ作業エージェントの訓練データを自動生成する強力なフレームワークです。主要なベンチマークにおける大幅なスコア向上は、タスクと検証基準を厳密にグラウンディングすることの重要性を証明しています。
注釈
- Workspace-Bench-Lite / SpreadsheetBench II: エージェントが実際のワークスペースやスプレッドシート環境で複雑なファイル操作・データ処理タスクをどの程度正確にこなせるかを測定するベンチマーク。
- GDPVal: エージェントの汎用的な実務遂行能力を評価するためのベンチマーク。
- ルブリック(Rubric): エージェントの実行結果や生成物の品質を判定するための評価基準や採点ルール。