LLM サービング層の攻撃検知手法──オラクルラベル対比で実運用ラベルの AUPRC 0.313 の課題を実証
LLM サービングにおける敵対的インタラクションやインフラ乱用を防ぐため、因果モデルを用いたデータセットと勾配ブースティング検出器を提案し、ラベル観測可能性の限界を検証した。
リリース: 2026-09-29 · 読了 5 分論文概要
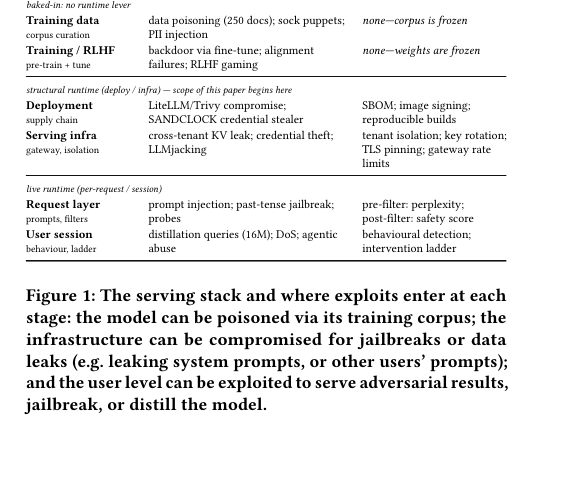
Large Language Model (LLM) をサービスとして運用する際、プロバイダはジェイルブレイクや高度なサービス妨害(DoS)、蒸留攻撃などの敵対的インタラクションからインフラストラクチャを防御する必要がある。本論文では、架空のフロンティアラボである Five Elements Inc. を例に挙げ、推論レイヤーにおけるセキュリティ課題を研究している。公開された敵対的 LLM 利用のラベル付きデータセットが存在しないため、構造的因果モデル (SCM) を用いて、多アカウントによる協調キャンペーンやプラットフォームからのフィードバックを含む現実的なユーザーセッションのラベル付きデータセットを生成し、勾配ブースティング検出器の性能を評価した。
関連研究
LLM のセキュリティに関する先行研究の多くはモデルの重みに対する安全性調整やプロンプトインジェクションの個別対策に主眼を置いていたが、本研究ではインフラおよびサービング層(推論レイヤー)全体における多層的な脅威と、実際の運用環境におけるラベルの不確実性に焦点を当てている点が従来研究と異なる。
新規性と貢献
本研究の主要な貢献は、実世界の Trust & Safety(信頼性と安全性)チームが直面するラベルの限界をモデル評価に組み込んだ点にある。オラクルラベル(理想的な正解データ)を用いると検出器は AUPRC 0.993 とほぼ完全に二値分類を解ける一方で、実際の運用環境を模したラベルでは AUPRC が 0.313 に低下することを実証し、評価用ラベル自体の精度問題に警鐘を鳴らした。
提案手法の詳細
構造的因果モデル (SCM) を用いて、ユーザーセッションの挙動や協調キャンペーンを模した合成データセットを構築した。このデータセットに基づき、各ユーザーセッションが良性か悪性か、さらに悪性の場合はどの攻撃タイプかを分類する勾配ブースティング検出器を訓練した。また、攻撃タイプの属性推定において、98% という高い良性の事前確率に起因するナイーブな argmax の性能低下を避けるため、シンプルな閾値処理による決定エンジンを導入している。
評価・考察
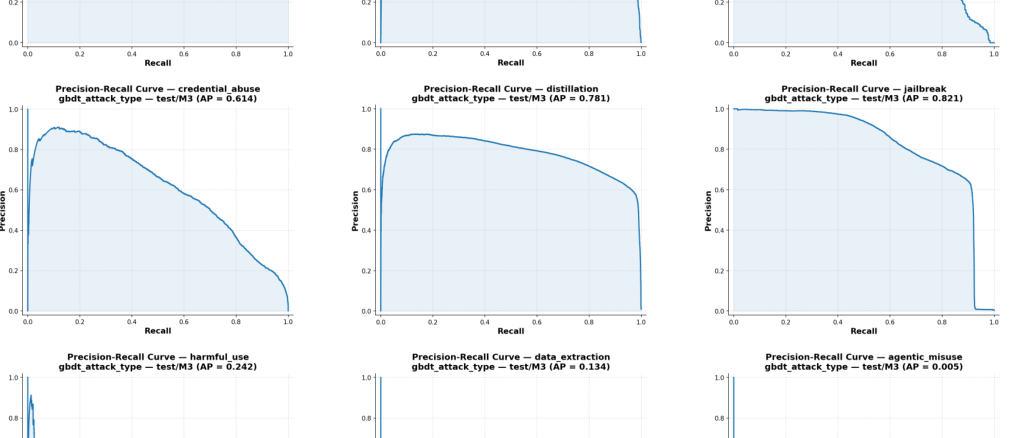
オラクルラベルを用いた評価では、二値分類タスクにおいて AUPRC 0.993 を記録した。しかし、実際の Trust & Safety チームが保有する運用ラベルを用いた場合、同じモデルの AUPRC は 0.313 に留まり、モデル自体の性能よりも評価用ラベルの品質がボトルネックになることが示された。また、攻撃タイプの属性推定において、ナイーブな argmax では macro-F1 が 0.295 にとどまったが、しきい値処理付き決定エンジンの導入により macro-F1 を 0.489 まで向上させることができた。
応用例と今後の展望
商用 LLM API プロバイダや、厳格なセキュリティ要件を持つ国内の金融機関・クラウド事業者などのプラットフォーム運用において、インフラ層での不正利用検知システムの設計に直接的な示唆を与える。特に、不完全な運用ラベルを前提とした機械学習モデルの評価手法の見直しや、誤検知を抑制する閾値設計の重要性を示している。今後の課題として、より多様な実運用環境におけるデータ収集と、ラベルノイズに対する頑健な学習アルゴリズムの検証が挙げられる。
結論
本論文は、LLM サービング層における敵対的攻撃の検出において、モデル単体の精度だけでなく、実際の運用現場におけるラベルの限界や偏りが評価に与える深刻な影響を明らかにした。公開されたデータセットと提案されたアプローチは、今後の LLM インフラのセキュリティ研究および実務における基準となることが期待される。
注釈
- AUPRC: 適合率-再現率曲線下面積 (Area Under the Precision-Recall Curve)。不均衡データにおいてモデルの性能を評価する重要な指標。
- Macro-F1: クラスごとの F1 スコアの単純平均。少数クラスの性能を評価する際に用いられる。