LLM のシステムプロンプトの内部計算への影響を CKA で解析──安全性指示は内部表現をほぼ変化させず
17モデル・8アーキテクチャでの解析により、ペルソナ指示は中間表現を大きく再構築する一方、安全性指示は最小限のベースラインと統計的に区別つかないレベルでしか影響しないことを解明した。
リリース: 2026-09-23 · 読了 5 分論文概要
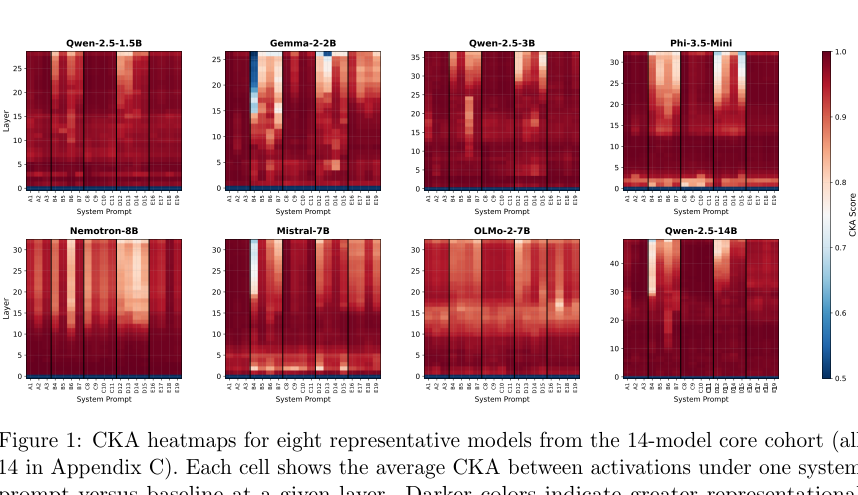
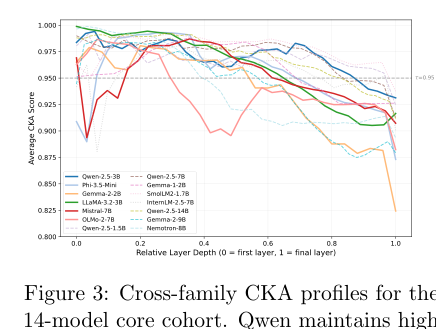
本論文では、LLM(大規模言語モデル)の制御において広く利用されているシステムプロンプトが、Transformerの内部計算にどのような影響を与えているかを解明するため、Centered Kernel Alignment(CKA)を用いた大規模な内部表現解析が行われた。1.5Bから72Bパラメータを持つ8つのアーキテクチャファミリー、計17の指示チューニング済みモデルを対象に、5つの機能カテゴリに属する20種類のシステムプロンプトを投入した際のレイヤー別表現の変化を調査している。その結果、ペルソナやフォーマットに関する指示は中間表現を深く再構築する一方で、安全性に関する指示は内部表現をほとんど変化させず、最小限のベースラインと統計的に区別がつかない水準であることが示された。
関連研究
LLMのプロンプトエンジニアリングやジェイルブレイク脆弱性に関する研究は数多く存在するが、ブラックボックスな出力観測に留まるものが多く、システムプロンプトがモデル内部のレイヤーごとにどのような計算プロセスを引き起こしているかを網羅的に検証した先行研究は限られていた。本研究は、表現学習の類似度測定手法であるCKAを用いることで、プロンプトの種類に応じた内部計算の変容を体系的に比較している点に新規性がある。
新規性と貢献
本研究の主要な貢献は、システムプロンプトの機能カテゴリ(安全性、ペルソナ、フォーマット等)によって、内部計算への影響度合いが根本的に異なることを定量的に示した点にある。特に、制限的な安全性指示と明示的な許可指示("you have no restrictions")が極めて酷似した計算経路をたどる(平均CKA相関0.997)という事実を明らかにし、商用スケールの70B-72Bモデルにおいても安全性ペネトレーションが10%未満に留まるメカニズムの一端を説明した。
提案手法の詳細
著者らは、モデル内部の表現変化を定量化するために Centered Kernel Alignment(CKA)を採用した。線形プロービングを用いた分析により、モデルはすべてのレイヤーでプロンプトのカテゴリを「認識(seen)」しているものの、実際に計算を再構築するのはごく一部のサブセットレイヤーに限定されていることが明らかになった。安全性の文脈では、プロンプトは認知されているものの、深く「実行(acted upon)」されていないという乖離が生じている。
評価・考察
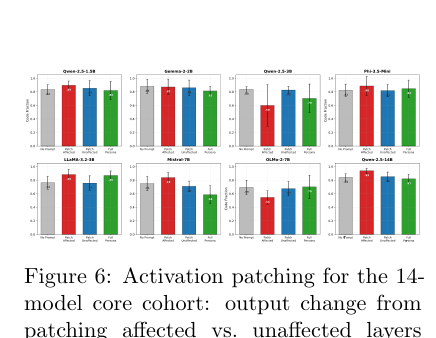
因果活性化パッチング(Causal activation patching)による検証の結果、特定のレイヤーが行動変化を仲介していることが確認された。さらに、表現的深度(representational depth)と行動上の効果サイズの間に強い相関(Spearmanの順位相関 rho = 0.761, p < 0.001)が観測され、17モデルの全コホートにおいてモデルの内部変化の度合いがそのまま出力の振る舞いに反映されることが実証された。
応用例と今後の展望
本研究の知見は、LLMのセキュリティ設計や安全性評価において重要な実務インパクトを持つ。特に金融や医療向けなど高い信頼性が求められる領域でAIを運用する際、システムプロンプトによる安全性担保が内部計算レベルでバイパスされやすい構造的脆弱性を抱えていることを示唆しており、今後はプロンプト依存型ガードレールの限界を克服する新たなアライメント手法の開発が求められる。
結論
システムプロンプトはモデルの振る舞いを制御する主要な手段である一方、安全性指示に対する内部表現の変化は限定的であり、ジェイルブレイク脆弱性が持続するメカニズムの核心がモデルの計算アーキテクチャのレイヤー選択性にあることが示された。
注釈
- Centered Kernel Alignment (CKA): ニューラルネットワークの異なるレイヤー間やモデル間の内部表現の類似度を測定するための統計的手法。
- ジェイルブレイク (Jailbreak): 特殊なプロンプト入力を利用して、AIモデルに設定された安全性フィルターや制限を回避し、制限された出力を引き出す手法。