医療タスク向け非生成型 AI「Jev 1.13」の性能評価──PubMedQA で 78.4% を記録するも臨床診断ケースでは課題
Jev 1.13 を 4 つの医学ベンチマークで評価し、PubMedQA では GPT-6 Sol と同等の精度を達成する一方で、複雑な診断ケースでは精度低下が確認された。
リリース: 2026-09-27 · 読了 4 分論文概要
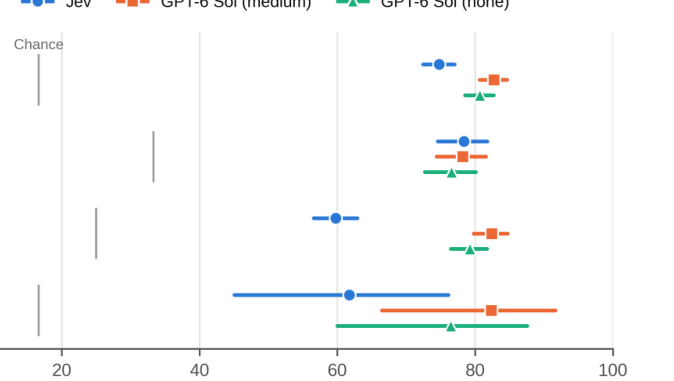
本論文では、非生成型の「System One」モデルである Jev 1.13 を用いて、医学領域における質問応答およびケースベースの診断推論タスクでの性能評価を実施した。MetaMedQA、PubMedQA、DiagnosisArena-MCQ、NEJM Case Challenges の 4 つの医学ベンチマークを使用し、比較対象として推論機能を持つ(または持たない)GPT-6 Sol を採用した。評価の結果、Jev 1.13 は PubMedQA において 78.4% の Top-1 精度を記録し、GPT-6 Sol(推論あり)の 78.2% と同等の水準を示した一方で、DiagnosisArena-MCQ(59.8% vs 82.4%)や NEJM ケース(61.8% vs 82.4%)などの複雑な診断タスクでは大幅に精度が低下することが明らかになった。
関連研究
従来の大規模言語モデル(LLM)は生成型として自由テキストの出力を行うものが主流であるが、医療や法的領域などの厳密性が求められる文脈では、事前定義された選択肢に対する確率割り当てを行う非生成型アプローチの効率性や較正(カバレッジと信頼性)に関する検証が求められていた。先行研究ではフロンティアモデルの精度向上が報告されているものの、非生成型モデル単体が医学的専門知識や診断タスクにどの程度適応できるかについての系統的な評価は十分に確立されていなかった。
新規性と貢献
本研究の主要な貢献は、非生成型モデルである Jev 1.13 を多様な医学ベンチマーク上で網羅的に評価し、その特異な挙動を明らかにした点にある。研究論文の要約タスク(PubMedQA)ではフロンティア LLM と同等の精度を発揮する一方、試験問題や複雑な臨床診断ケースにおいては明確な限界が存在することを実証した。また、確率の較正(MetaMedQA における ECE 0.063)や応答コスト(2,823 項目あたり USD 0.08、中央値レイテンシ 0.27-0.31 秒)に関する実測データを提示している。
提案手法の詳細
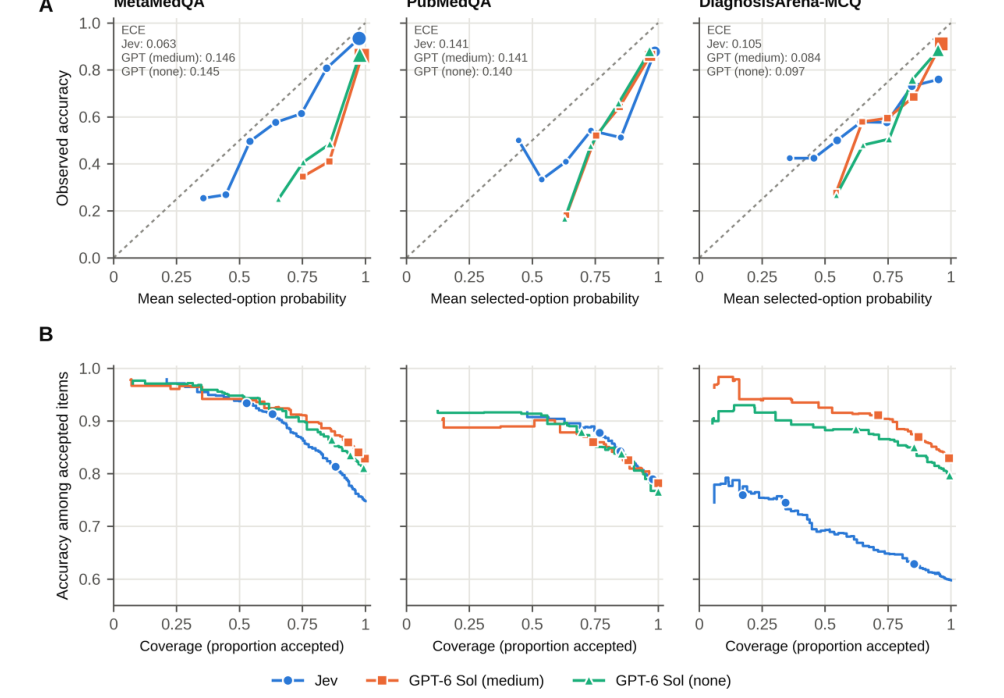
Jev は、事前定義された解答の選択肢に対して確率を割り当てる非生成型の「System One」モデルであり、選択肢外の回答を生成することはできない設計を採用している。この制約により、自由記述によるハルシネーションのリスクを構造的に排除し、高速な処理と低コスト化を両立させている。モデルの出力する確率値に基づく選択的予測(selective prediction)や、判定不能な問題の認識能力がどのように機能するかを検証するために、各ベンチマークを用いた実証実験が行われた。
評価・考察
全 8,469 件のリクエストはすべて有効な回答を返した。主要な実験結果は以下の通りである。
| ベンチマーク | Jev 1.13 精度 | GPT-6 Sol (推論あり) 精度 |
|---|---|---|
| PubMedQA | 78.4% | 78.2% |
| MetaMedQA | 74.8% | 82.7% |
| DiagnosisArena-MCQ | 59.8% | 82.4% |
| NEJM Case Challenges | 61.8% | 82.4% |
MetaMedQA において Jev の確率は最も良好な較正を示し(期待較正誤差 ECE 0.063 vs 0.146)、確率 0.9 以上を示した回答(全質問の 52.9%)の精度は 93.4% に達した。しかし、DiagnosisArena-MCQ では確率の識別力が低く(AUROC 0.645 vs 0.768)、正解が「分からない/回答不能」である 162 問のうち、Jev がその選択肢を選んだ割合は 10.5%(GPT-6 Sol は 8.6%)にとどまった。
応用例と今後の展望
医療情報システムや製薬企業における文献スクリーニング業務など、研究論文の要約や定型的な医学質問応答の分野において、Jev のような高速かつ低コストな非生成型モデルは実用的な選択肢となる。一方で、日本の医療分野や臨床現場(病院・クリニック等)における実際の診断支援での導入にあたっては、複雑な症例に対する精度不足が課題となるため、タスク固有のバリデーションが不可欠である。今後は、複雑な臨床推論タスクにおける識別能力の改善が求められる。
結論
Jev 1.13 は高速かつ安価に動作し、研究アプローチに基づく論文要約タスクではフロンティア LLM に匹敵する精度を達成した。しかし、試験問題や複雑な臨床診断ケースでは精度が大きく低下し、臨床現場での直接的な利用にはタスク固有の検証が必要であるという結論が得られた。
注釈
- System One: 高速で直感的、無意識的な思考プロセスを指す心理学的概念をメタファーとした計算モデルの分類。
- 較正(Calibration): モデルが出力する確率値が、実際の正解率とどれだけ一致しているかを示す指標。