DynaFlow:プログラム可能な演算子スケジューリングによりデバイス内並列化を統合するフレームワーク──スループットを最大 1.29 倍に向上
論理モデル定義と物理実行スケジュールの分離により、既存コードの大幅な改修なしで多様なデバイス内並列化戦略を統合し、推論・学習時のリソース稼働率を改善する。
リリース: 2026-05-20 · 読了 5 分論文概要
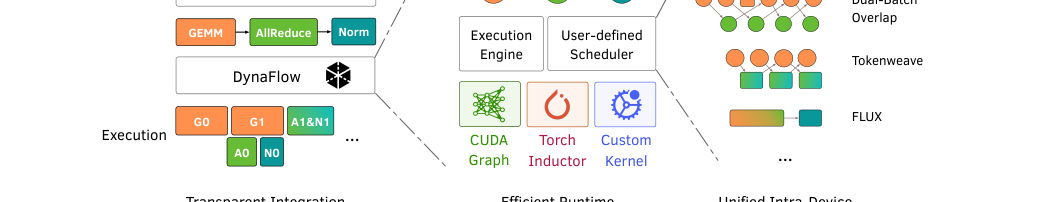
機械学習モデルの推論および学習におけるリソースの遊休問題に対処するため、異なるリソース使用量を持つ演算子の実行をオーバーラップさせるデバイス内並列化(Intra-Device Parallelism)が注目されている。しかし、既存の機械学習フレームワークが持つ静的かつ逐次的なプログラミングモデルとの矛盾から、その導入には大規模かつモデル固有のコード改修が必要となり、多大なエンジニアリングコストが障壁となっていた。本論文では、論理的なモデル定義と物理的な実行スケジュールを分離することで、デバイス内並列化を透過的かつ柔軟に統合するフレームワーク「DynaFlow」を提案する。DynaFlowは、6つの最先端機械学習システムに対して最小限のコード変更で代表的な並列化戦略を統合し、最大 1.29 倍のスループット向上を実証している。
関連研究
従来の機械学習システムにおける並列化手法は、データ並列性やテンソル並列性など、複数デバイス間にわたるものが主流であった。単一デバイス内での演算子の重ね合わせやリソース効率化を狙った個別のアプローチ(例:NanoFlowや各種カスタムスケジューリング手法)も提案されてきたが、これらは特定のモデル構造やハードウェア環境に強く結合しており、汎用的なフレームワークへの組み込みが困難であった。本研究は、特定の実行コンテキストに依存しないプログラマブルなスケジューリング機構を提供することで、既存の個別最適化手法を統合する基盤を提供する点に違いがある。
新規性と貢献
本研究の主要な貢献は以下の通りである。
- 論理モデル定義と物理実行スケジュールの分離:並列化戦略の実装におけるエンジニアリングコストを劇的に削減する。
- プログラマブルなフロントエンドと非同期バックエンドの提供:カスタムのデバイス内並列化戦略を柔軟に定義・実行できる仕組みを構築した。
- 既存の最適化との互換性維持:CUDA GraphsやTorchInductorといった既存のコンパイラ・ランタイム最適化を損なわずに適用可能である点を実証した。
提案手法の詳細
DynaFlowは、グラフ分割のためのアノテーションを備えた柔軟なフロントエンドと、カスタムのデバイス内並列化戦略を定義するためのプログラマブルなインターフェースを特徴とする。
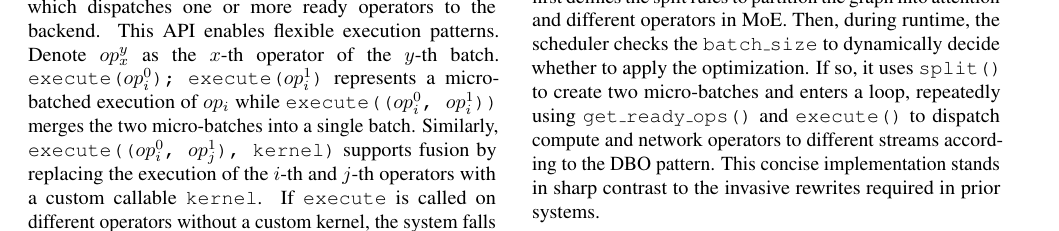
バックエンドでは、複雑な制御フローおよびデータフローを非同期で管理する。また、カスタムのメモリ管理機構を採用することでコピーオーバーヘッドを排除し、ハードウェア性能を最大限に引き出す設計となっている。
評価・考察
論文では、vLLMやSGLangを含む6つの最先端MLシステムに対してDynaFlowを適用し評価を行っている。その結果、最小限のコード変更により、既存システムと比較して最大 1.29 倍のスループット向上を達成した。
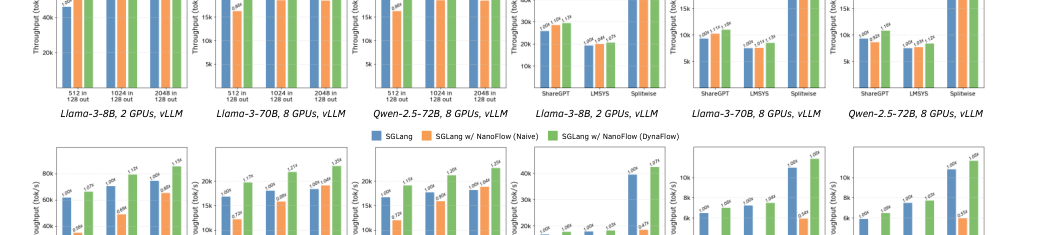
この結果は、デバイス内並列化の導入障壁となっていた複雑なコード書き換えを回避しつつ、実用的なパフォーマンス向上を得られることを示している。
応用例と今後の展望
大規模言語モデル(LLM)のサービングインフラやAIアクセラレータを活用するデータセンター事業者にとって、ハードウェアの稼働率を向上させるための有力な基盤技術となる。国内の大規模AI基盤運用やLLM推論サービス開発において、推論コスト削減のためのインフラ層のチューニング工数を大幅に削減できる実務インパクトを持つ。今後は、より多様なハードウェアバックエンドや複雑な動的ワークロードに対するスケジューリングアルゴリズムの自動最適化が課題となる。
結論
DynaFlowは、論理モデルと物理スケジュールの分離とプログラマブルなスケジューリングにより、デバイス内並列化の導入障壁を解消するフレームワークである。最先端MLシステムへの容易な統合と最大 1.29 倍のスループット向上を実現し、今後のMLシステム設計に新たなアプローチを提示している。
注釈
- Intra-Device Parallelism(デバイス内並列化):単一のGPU等のデバイス内で複数の演算子やタスクをオーバーラップさせて実行し、リソース利用率を高める技術。
- CUDA Graphs:複数のCUDAカーネルの起動をグラフ構造としてまとめ、ホスト・デバイス間のオーバーヘッドを削減するNVIDIAの技術。
- TorchInductor:PyTorch 2.x向けのディープラーニングコンパイラで、JITコンパイルによりカーネルの融合や最適化を行う。