マルチモーダル個人化ベンチマーク Life-Bench の公開──概念認識から統合推論まで 11,800 問で精度低下を実証
個人史のマルチモーダル推論を評価する Life-Bench を提案し、証拠スコープの拡大に伴い既存手法の精度が 0.40 未満に低下することを実証した。
リリース: 2026-02-22 · 読了 5 分論文概要
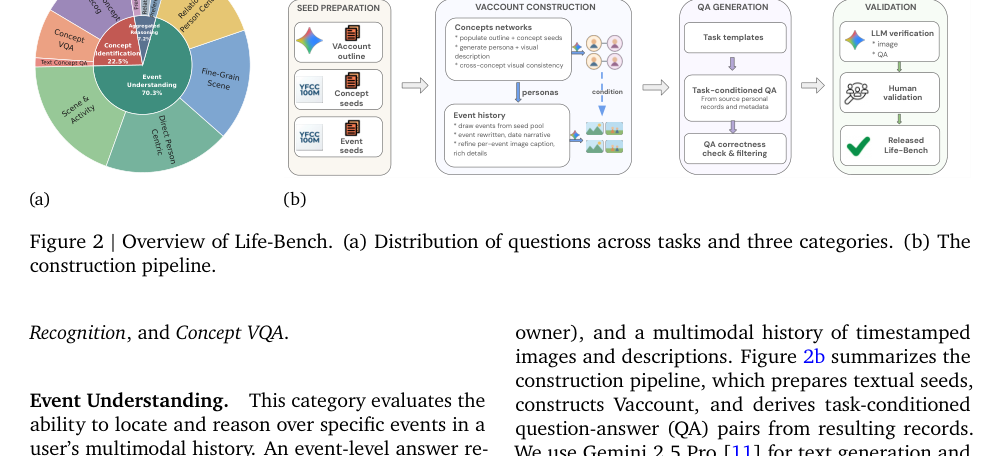
大規模言語モデルやマルチモーダルモデルがパーソナルアシスタントとして活用される中、個人の履歴に基づくマルチモーダル推論の重要性が増している。しかし、既存のベンチマークは概念レベルの認識に偏っていた。本論文では、10タスク・11,800問を超える完全合成かつ人間による検証を経たマルチモーダルベンチマーク「Life-Bench」を提案する。証拠スコープごとに「概念識別」「イベント理解」「集約推論」に分類されており、写真中心の個人履歴は実アカウントの埋め込み統計と分布レベルで整合している。
関連研究
従来、パーソナライゼーションに関するベンチマークや評価用データセットの多くは、単一の画像に対する物体認識やテキストベースのプロファイル構築に留まっていた。本研究は、複数の画像やイベントにまたがるライフヒストリー全体を対象とし、かつ検索と推論を複合的に評価する点で先行研究と異なる。
新規性と貢献
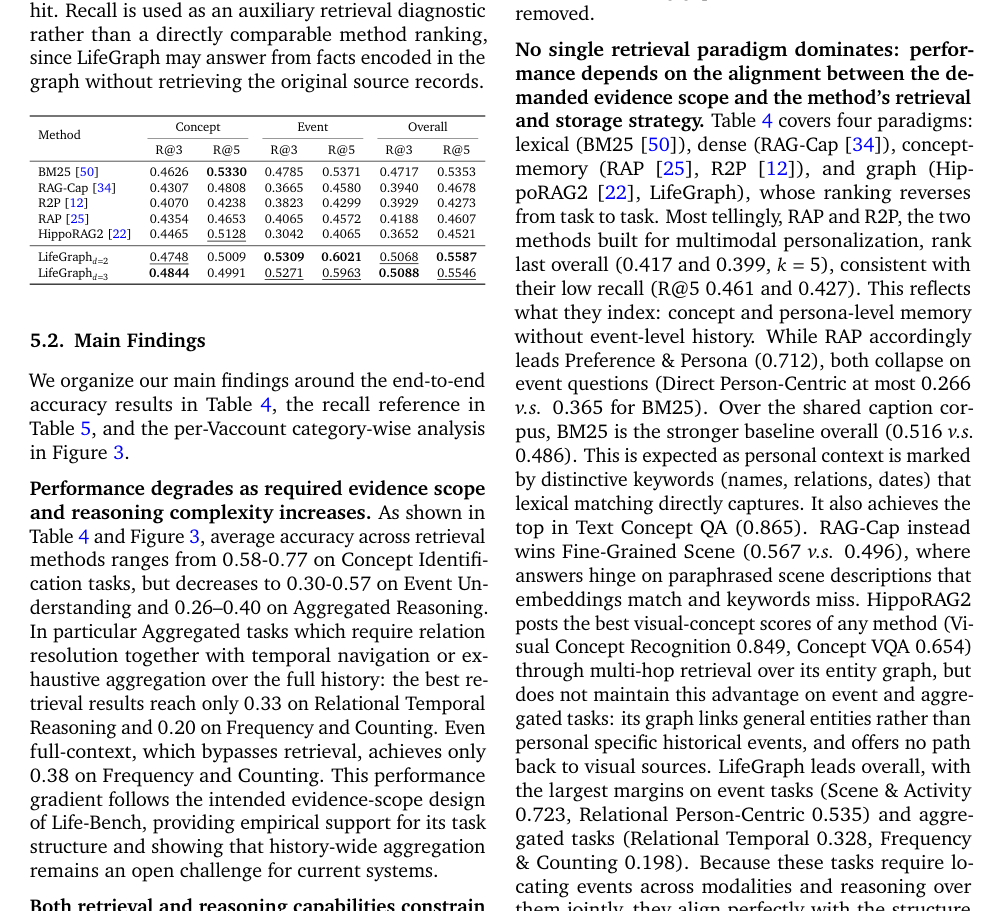
主要な貢献は、実アカウントの統計分布に適合した大規模なマルチモーダル個人化ベンチマーク Life-Bench の構築と、グラフ構造を用いた個人知識グラフフレームワーク LifeGraph の提案である。4つの異なる検索パラダイムを用いた系統的評価により、証拠のスコープが拡大するにつれて既存手法の精度が急激に低下することを明らかにした。
提案手法の詳細
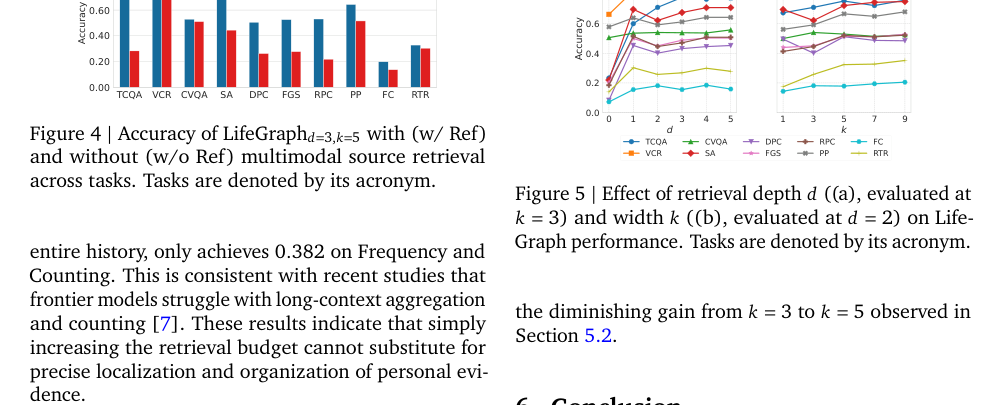
個人データの相互接続された構造を扱うため、本研究ではパーソナル知識グラフフレームワーク「LifeGraph」を提案する。LifeGraph は、構造化された検索を提供するとともに、オンデマンドで元の視覚的証拠にアクセスする仕組みを備えており、特にイベント理解や集約推論タスクにおいて有効性を示す。
評価・考察
4つの検索パラダイムを Life-Bench で系統的に評価した結果、証拠スコープの拡大に伴い精度が急激に低下し、集約推論タスクでは精度が 0.40 を下回る結果となった。また、どの単一の検索パラダイムもすべてのカテゴリで優位性を示すことはなく、マルチモーダルな個人史の推論が未解決の大きな課題であることが示されている。
応用例と今後の展望
パーソナルAIアシスタントやライフログ分析サービスなど、ユーザーの文脈を深く理解する必要がある分野への応用が期待される。日本のコンシュー向け AI アプリケーション開発企業やリサーチ部門(例: 数百万ユーザー規模のパーソナルサービスを運営するチーム)において、単なる画像認識を超えた「複数イベント・コンテキストの統合推論」の精度を検証するためのテストベッドとして Life-Bench を活用可能である。
結論
Life-Bench の導入により、マルチモーダル個人化における現在のモデルの限界が明確になった。今後は、より高度な証拠統合と検索機構を持つモデルの開発に向けた基準としての活用が進むと見られる。
注釈
- Life-Bench: 個人のライフヒストリーに基づくマルチモーダル推論能力を測定するためのベンチマーク。
- LifeGraph: 個人データの関連性をグラフ構造で表現し、視覚的証拠へのオンデマンドアクセスを可能にするフレームワーク。