RALM の回答拒否性能を向上させる軽量フィルタリング手法 Sieve and Sage──精度を最大 69.4pt 改善
検索失敗状態を「未回答」と「攪乱」に分離し、軽量モジュール Sieve によるスクリーニングで既存手法比最大 69.4pt の精度向上と 1.99 倍の高速化を両立した。
リリース: 2026-09-17 · 読了 5 分論文概要
Retrieval-Augmented Language Models (RALMs) において、不十分な検索証拠に起因するハルシネーションを防ぎ、適切に回答を拒否(abstain)するための新フレームワーク「Sieve and Sage」が提案された。従来の単一モデルによるアプローチでは、必要な証拠の欠如と敵対的・否定的なノイズの混入という異なる失敗状態を混同する課題があった。本研究では検索失敗を 2 つの状態に分解し、軽量なフィルタリングモジュール Sieve と、根拠付き生成を行う Sage を組み合わせることで、一般および専門ドメインにおいてシステム精度を最大 69.4 %向上させつつ、最大 1.99 倍の推論高速化を達成している。
関連研究
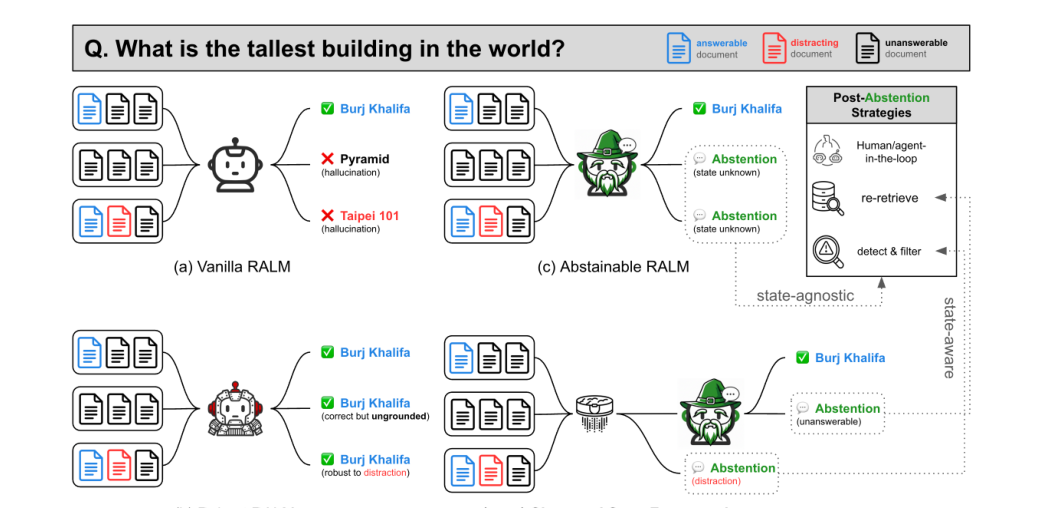
従来の RALM における回答拒否(abstention)メカニズムは、主に大規模な言語モデル単体に依存して検索結果の信頼性を評価してきた。しかし、単一の LLM アプローチでは、検索されたドキュメント全体を処理するため計算コストが高騰するだけでなく、矛盾情報や無関係なノイズが含まれる「distracted state」での判定精度が著しく低下するという課題があった。
新規性と貢献
本研究の最大の新規性は、検索失敗の状態を「必要証拠が完全に欠如している状態(unanswerable state)」と「競合情報や否定情報、敵対的情報が混入している状態(distracted state)」の 2 つに明確に分類した点にある。この状態分解に基づき、高コストな LLM 呼び出しの前に軽量モジュールでノイズを排除するパイプラインを構築し、精度の向上と計算効率化を同時に実現した。
提案手法の詳細
提案手法の核心は、重い LLM 処理の前に実行される軽量スクリーニングモジュール「Sieve」にある。Sieve は検索されたドキュメントセットをあらかじめ精査し、有害なノイズや攪乱情報を排除する。ノイズが排除されたクリーンなコンテキストのみを高コストな推論モデル「Sage」へ入力することで、確実な根拠に基づく生成と高精度な回答拒否を両立する設計となっている。
評価・考察
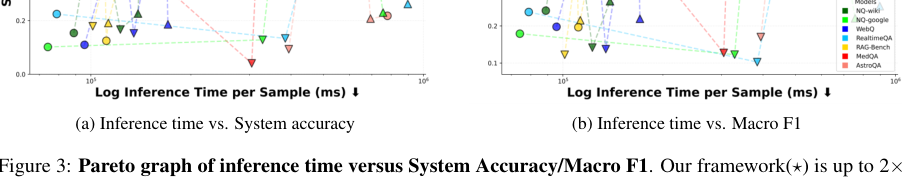
一般および高リスクな専門ドメインにおける評価の結果、Sieve and Sage フレームワークは従来の一段階ベースラインと比較して、システム精度を最大 69.4 パーセンテージポイント、Macro-F1 を 55.2 パーセンテージポイント改善した。さらに、不必要な LLM 呼び出しの抑制により最大 1.99 倍の推論速度向上も実証されており、精度と効率の双方で優れたトレードオフを示している。
応用例と今後の展望
医療や法律、金融といった高リスクな専門ドメインにおいて、誤情報の出力を防ぎつつ不確実な質問に対する適切な回答拒否が求められる実務システムへの適用が見込まれる。日本の金融機関や医療AIベンダー等の開発チームにおいては、数千件規模のドキュメント検索を伴う RAG システムの実装において、API コストを抑制しながら信頼性を担保するための有効なアーキテクチャ選択肢となり得る。
結論
本研究は、検索失敗の状態分解アプローチに基づく Sieve and Sage フレームワークにより、RALM の回答拒否性能と計算効率を同時に劇的に改善できることを示した。信頼性とスケーラビリティの両立が求められる実運用環境において重要な指針を提供する。
注釈
- RALM (Retrieval-Augmented Language Models): 外部データベースからの検索結果を言語モデルの入力に補強し、生成精度の向上を図るモデル群。
- Abstention (回答拒否): 提示された情報が不十分であると判断した場合に、モデルが推測による回答を控え、回答不能である旨を返す挙動。