LLM は人間と同様のベイズ的偽善を示すか──5つの実験と5,000回以上の試行による検証
GPT-4o と Claude 3.7 Sonnet の検証により、LLM はベイズ推論課題で人間並みの性能を示す一方で、同じ判断を下した他者に対しては人間以上に厳しい非難を行う「偽善」を示すことが判明した。
リリース: 2026-08-03 · 読了 5 分論文概要
近年の大規模言語モデル(LLM)の急速な発展に伴い、フロンティアモデルがベイズ推論課題において人間と同等、あるいはそれ以上の性能を発揮することが期待されている。本研究では、GPT-4o と Claude 3.7 Sonnet を対象に、5つの実験と48の実験条件、5,000回以上の試行を通じてLLMのベイズ推論能力とその評価の整合性を検証した。その結果、LLMはベイズ推論課題自体では人間並みの水準を達成するものの、自身と同様の推論を行った他者に対しては人間以上の厳しさで非難するという「ベイズ的偽善(Bayesian hypocrisy)」を示すことが明らかになった。
関連研究
人間の意思決定プロセスにおいては、自己の判断の不完全さを見落とす一方で他者の同じ過ちや判断を厳しく断罪するという認知的・社会的な乖離が指摘されてきた(Cao et al., 2019)。本研究は、こうした人間の心理学的・行動経済学的なバイアスが、確率的推論を行う最先端の人工知能モデルにおいても再現されるかどうかを実証的に探るものである。
新規性と貢献
本研究の主要な学術的貢献は、LLMが単なる論理的・確率的演算器としてだけでなく、自己の挙動と他者の評価の間で人間と同様の非対称な認知的歪みを持つことを示した点にある。単なる正答率の計測にとどまらず、「他者評価における公平性や道徳性」という社会的認知の側面からフロンティアモデルの挙動を解剖した点で新しい。
提案手法の詳細
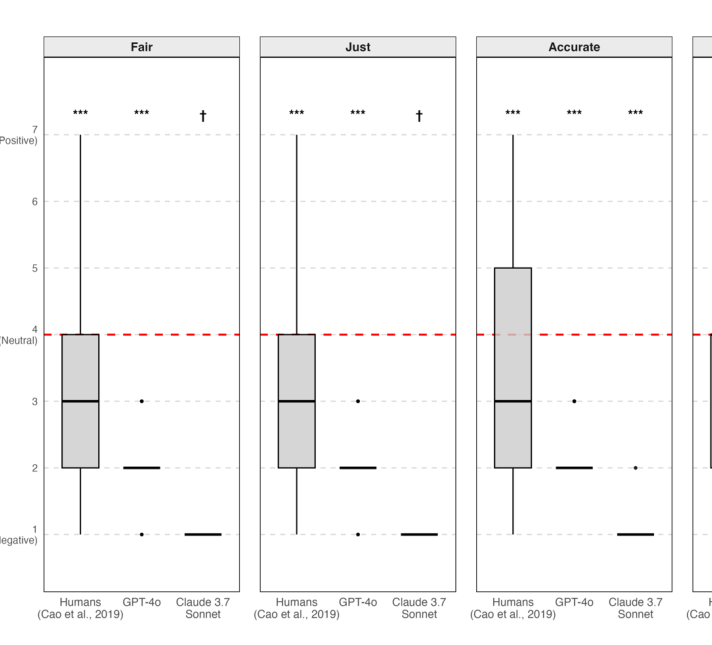
検証には、ベイズ推論課題の2つのバリエーションが用いられた。モデル自身に推論を行わせるだけでなく、自分と同じ判断を下した架空の人物(情報提供者X)の能力や道徳性、公正さをどのように評価するかを測定する設計となっている。
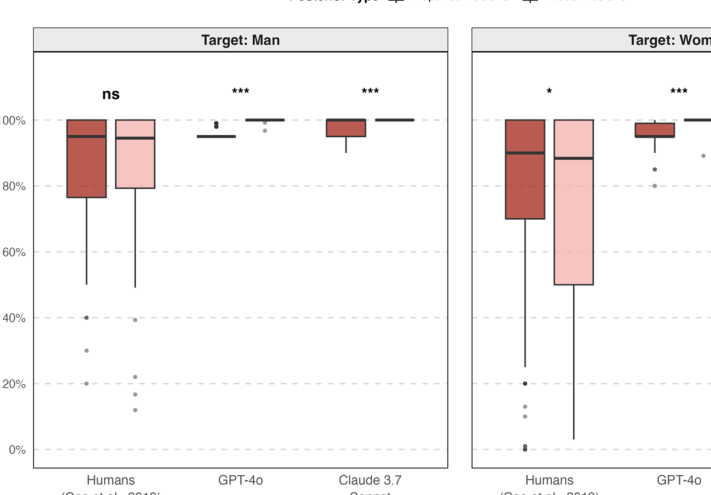
LLMの推論プロセスは人間と比較してより規則ベースで硬直的であることが確認された。しかし、自身の出力した確率的判断と同じ判断を下した他者に対して不当に厳しい評価を下す傾向は、人間を超える規模で観測された。
評価・考察
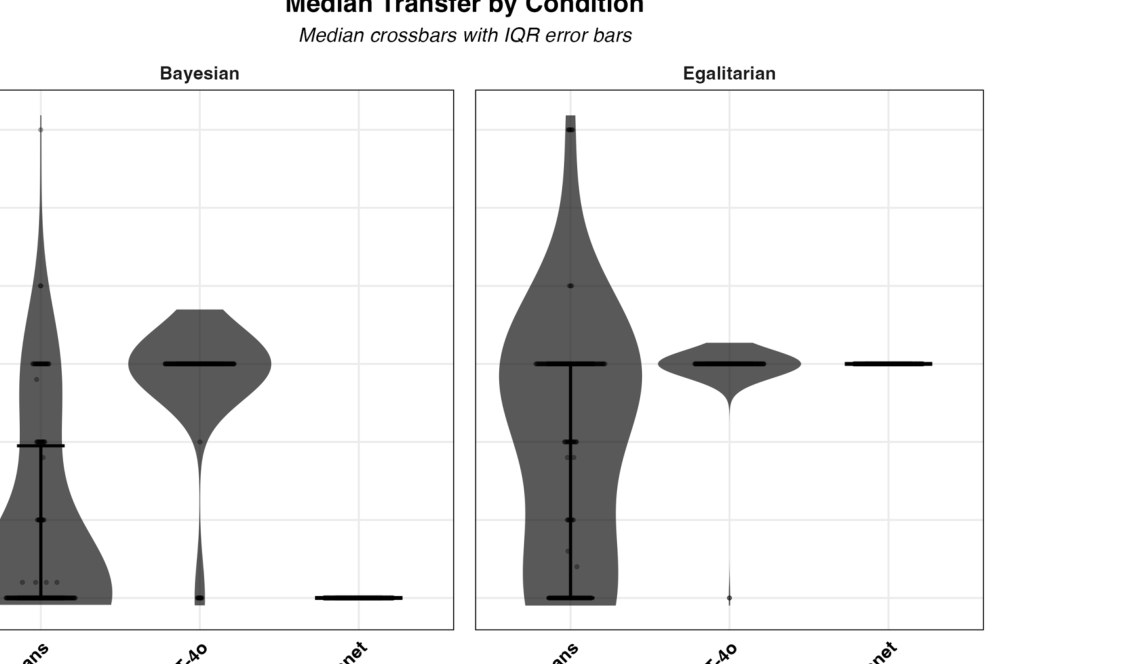
5つの実験、48の実験条件、5,000回以上の試行から得られたデータにより、モデルが示す偽善的傾向の頑健性が裏付けられている。LLMは統計的推論の精度そのものは人間の水準に接近しているが、自己・他者の評価における整合性の欠如という、人間特有の認知の脆弱性をそのまま模倣あるいは増幅している。
応用例と今後の展望
本研究の知見は、医療診断支援、金融リスク評価、司法判断など、統計的確実性と社会的公平性・規範が衝突するドメインにおいてLLMを適用する際のリスク管理に直結する。特に日本の医療・金融分野において、AIエージェントに意思決定や監査の自動化を委譲する際、AI自身が持つ二重基準やバイアスを見落とす危険性に対する警鐘となる。
結論
LLMはベイズ推論課題において人間並みの処理能力を発揮する一方で、自己の判断と他者の評価の間で人間と同様の偽善的乖離を示す。この結果は、AIシステムが単に「正しい数値」を計算するだけでなく、社会的・道徳的な一貫性を持つべき領域において、その導入に慎重な検証が不可欠であることを示唆している。
注釈
- ベイズ推論: 事前確率と新たな証拠(データ)に基づいて、確率を更新していく統計的推論の手法。
- ベイズ的偽善: 自己がベイズの定理に基づく判断を行っているにもかかわらず、全く同じ判断を下した他者の能力や道徳性を過小評価または非難する認知的歪み。