小規模推論モデルの限界を克服する選択的クエリフレームワーク FlyBy──Qwen3-14B を低コストで超える性能を実証
自己修正の限界と知識ボトルネックを診断し、必要に応じて上位モデルへクエリを投げる FlyBy により、FlyBy-4B は Qwen3-14B 比 2.7 倍安価でありながら 45.96% の pass@8 を達成した。
リリース: 2026-09-28 · 読了 5 分論文概要
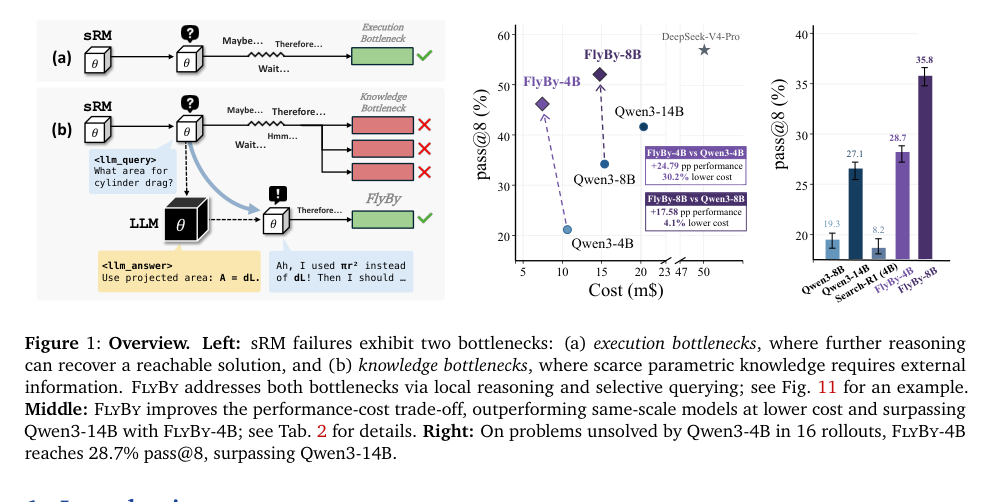
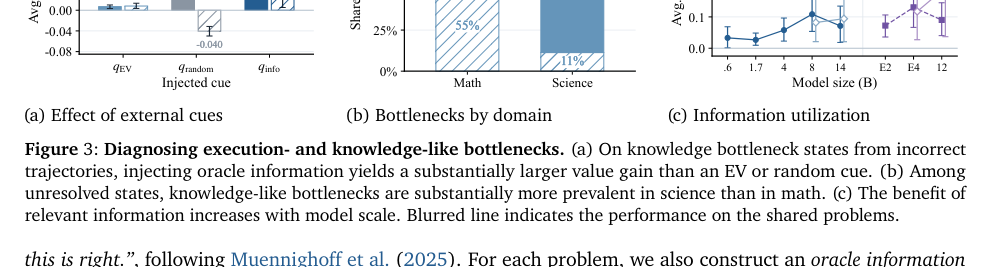
テスト時計算のスケーリングは言語モデルの推論能力向上に有効であるが、小規模推論モデル(sRM)においては、追加の思考プロセスが必ずしも有効に機能するとは限らない。本論文では、自己修正が新たな解への到達よりも既存の到達可能領域を固める傾向にあることを示し、失敗レジームを「実行ボトルネック」と「知識ボトルネック」に分類した。これに基づき、知識不足時に上位モデルへ選択的にクエリを投げるフレームワーク「FlyBy」を提案する。FlyBy-4Bは6ベンチマークの1,158難問においてpass@8で45.96%を記録し、Qwen3-14Bの41.64%を2.7倍低いサービングコストで上回った。
関連研究
テスト時計算のスケーリングや思考プロセス(Chain-of-Thoughtなど)の長文化による性能向上の研究が多数進められているが、モデル自体のパラメータ知識を超える問題に対する自己修正の限界については十分に解明されていなかった。本研究は、モデルの内部状態を分析し、外部知識の補完が必要となる条件を明確にした点で先行研究と異なる。
新規性と貢献
主な貢献は、推論中の失敗を「実行ボトルネック」と「知識ボトルネック」に厳密に切り分けた点にある。単に推論長を伸ばすのではなく、知識不足を検出した際にのみ上位モデルに問い合わせるマルチデプス・クエリ行動を教師あり微調整とコスト認識型強化学習によって実現し、小規模モデルのコスト優位性を維持しつつ大規模モデルの水準を超える性能を達成した。
提案手法の詳細
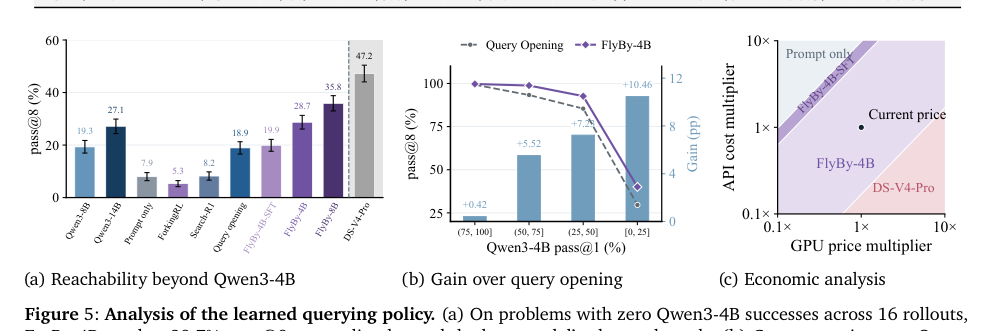
FlyByは、まずモデル自身に推論を行わせ、未解決の課題を診断させる。現在のモデルのパラメータ知識では解決できない「知識ボトルネック」に直面した際、より強力なモデルのパラメータ知識を活用するためのクエリを発行する。教師あり微調整(SFT)によってマルチデプスなクエリ行動をブートストラップし、コスト認識型強化学習を用いて「クエリすべきか」「何を尋ねるべきか」「いくらコストをかけるべきか」を精密に校正している。
評価・考察
6つのベンチマークにおける1,158の難問を用いた評価で、FlyBy-4Bはpass@8で45.96%を記録し、Qwen3-14Bの41.64%を2.7倍低いサービングコストで超えた。また、pass@1においてもFlyBy-4Bは16.85%を記録し、Qwen3-8Bの15.31%を上回っている。さらにFlyBy-8Bにスケールさせた場合、pass@8は51.81%まで向上した。
応用例と今後の展望
低コストなエッジ・オンプレミス環境向けの小規模推論モデルにおいて、APIなどを介した上位モデルとのハイブリッドな連携アーキテクチャの設計指針を提供する。国内のAI開発・LLMインテグレーション分野(特に金融や医療など外部知識の厳密な補完が必要な領域)において、サービングコストを抑えつつ高精度な推論システムを構築する際の実務的な実装パターンとして活用が見込まれる。
結論
sRMにおける思考の限界がパラメータ知識の欠如に起因することを突き止め、選択的な外部クエリを強化学習で制御するFlyByフレームワークの有効性を実証した。これにより、コスト効率と推論精度のトレードオフを大幅に改善できる。
注釈
- sRM: Small Reasoning Modelsの略。限られたパラメータ数で高度な推論を行う小規模な言語モデル。
- パラメータ知識: モデルの重みパラメータに内部化された事前学習時の知識。