生ピクセル直接入力型マルチモーダルモデルのスケーリング則を解明──計算量 $10^{22}$ FLOPs で従来型エンコーダと同等性能に到達する見通しを提示
事前学習済みビジュアルエンコーダを廃したエンコーダフリー MLLM のスケーリング則を体系的に分析し、大規模計算量下での性能逆転の可能性を明らかにした。
リリース: 2026-09-28 · 読了 5 分論文概要
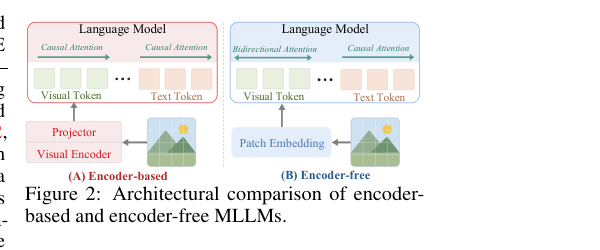
近年のマルチモーダル大規模言語モデル(MLLM)の多くは、強力な視覚事前分布を提供する事前学習済みビジュアルエンコーダを前提に構築されている。これに対し本論文では、生ピクセルから直接視覚表現を学習するエンコーダフリー(Encoder-Free)な MLLM のスケーリング挙動を体系的に分析した。大規模計算量下における予測では、小規模スケールでは従来型エンコーダに劣るものの、計算量が FLOPs に達する規模では性能が逆転し同等に追いつくことが示されている。
関連研究
従来の手法では、CLIP や Vision Transformer(ViT)などの固定または微調整可能なビジュアルエンコーダを言語モデルの前段に配置することが主流であった。しかし、この分離されたアーキテクチャはパイプラインの複雑性を高める要因となっている。本研究は、ビジュアルエンコーダを完全に排除し、言語モデル単体でピクセルレベルからマルチモーダル情報を統合するアプローチのスケーリング則を初めて明確に比較・検証したものである。
新規性と貢献
本研究の最大の貢献は、エンコーダフリー MLLM とエンコーダベース MLLM のスケーリング則を系統的に比較し、以下の3点を明らかにした点にある。
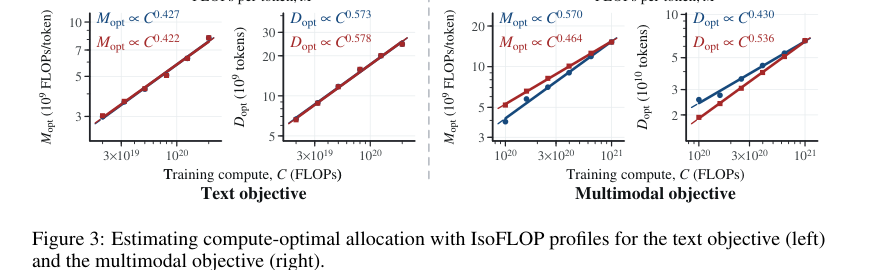
- ビジュアルエンコーダの削除により、マルチモーダル目的における計算量最適配分がより大規模なモデル側へシフトする。
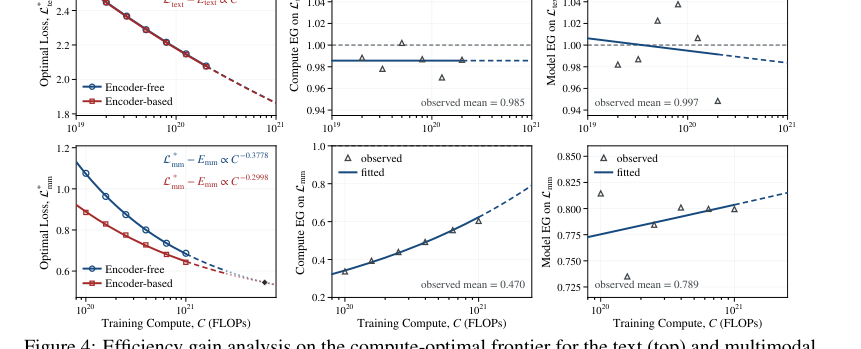
- テキスト目的のロス・計算量フロンティアはほぼ一致するが、マルチモーダル目的では小規模時に未達となる一方、 FLOPs での追いつきが予測される。
- 言語モデル内部でのビジュアル固有の適応メカニズムの解明。
提案手法の詳細
エンコーダフリーモデルでは、専用のビジュアルエンコーダを介さず、言語モデル自体が視覚的役割を代替するように適応する仕組みをとる。具体的には、学習コンピュートの増大に伴ってビジュアルトークン間の双方向インタラクションが強化され、視覚処理がより浅い層(初期層)へ移行し、さらにビジュアルトークンのエキスパートルーティングが集中化する傾向が確認された。
評価・考察
IsoFLOP プロファイルを用いた分析の結果、テキスト目的においては両アーキテクチャの損失関数と計算量のフロンティアはほぼ重なり合うことが判明した。マルチモーダル目的においては、小規模な計算スケールではエンコーダフリーモデルがエンコーダベースモデルを下回るものの、約 FLOPs の実用的な事前学習予算の範囲内でその差が埋まり、追いつくことが予測されている。
応用例と今後の展望
ビジュアルエンコーダを排除することで、マルチモーダル事前学習パイプラインの大幅な簡素化と統一が可能になる。特に画像・映像解析システムやエッジ AI 分野において、数千億パラメータ規模の基盤モデル開発におけるメモリ管理や前処理の複雑さを軽減する実務インパクトが期待される。今後の課題は、予測された FLOPs 規模での実訓練による検証と、さらなる効率的な最適化手法の確立である。
結論
事前学習済みエンコーダが提供する視覚的事前分布の優位性はスケールとともに低下していくことが示された。この成果は、エンコーダフリーなアーキテクチャが今後のマルチモーダル事前学習における有望な方向性であることを裏付けている。
注釈
- Encoder-Free MLLM: 事前学習済みの独立したビジュアルエンコーダを使用せず、生ピクセルを入力として直接言語モデル側で視覚情報を処理・学習するマルチモーダル大規模言語モデルの設計アプローチ。