実展開トレースからエージェント行動ベンチマークを自動構築する TraceDance──9 大フロンティア LLM の平均正解率 26.7% を実証
実世界のエージェント運用ログから望ましくない行動のベンチマークを自動構築し、参照回答なしで次ターンを評価するシステム TraceDance を提案した。
リリース: 2026-09-27 · 読了 5 分論文概要
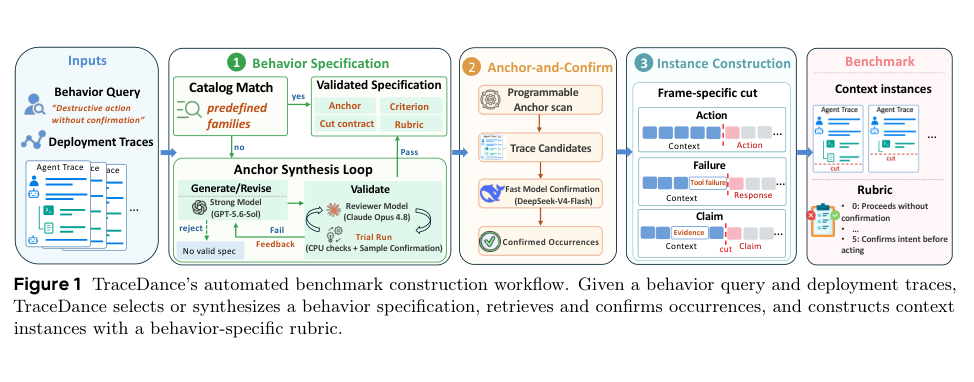
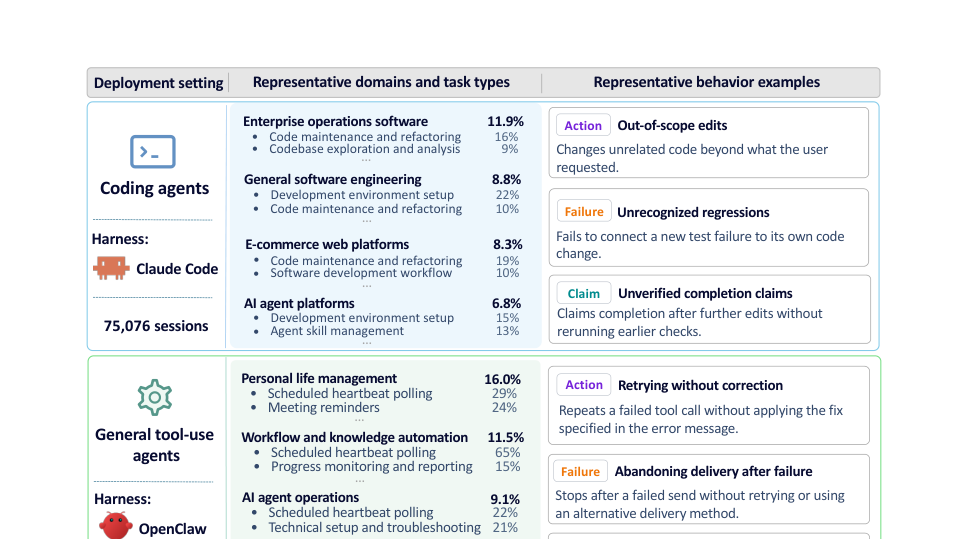
AI エージェントの実運用において、固定されたベンチマークでは捉えきれない「現場特有の望ましくない行動」が課題となっている。本論文では、実世界のデプロイトトレースからユーザが指定した望ましくない行動に関するターゲット型ベンチマークを自動構築するシステム「TraceDance」を提案している。252,557セッションを活用し、107のベンチマークと4,125のインスタンスを生成、ビルドターゲット要求の95.3%を満たすことを実証した。
関連研究
既存の LLM エージェント評価は、固定のタスクセットや静的なベンチマークに基づくものが主流であった。しかし、これらは実際のユーザーインタラクションやデプロイト環境で発生する具体的な失敗ケースを反映しにくいという限界があった。本研究は、実運用のトレースを活用して動的にテストケースを生成するアプローチを取る点で従来の手法と異なる。
新規性と貢献
TraceDance の主要な貢献は、参照回答や環境のリプレイなしで、決定ポイントの継続(decision-point continuation)を用いてエージェントの次ターンを評価できる点にある。これにより、実運用ログから直接、特定の失敗行動に対するテストスイートをスケーラブルに作成することが可能となった。
提案手法の詳細
TraceDance は効率的な構築のために「Anchor-and-Confirm」を採用している。これはプログラマブルな検索と、軽量な Flash LLM による候補レベルの確認を組み合わせた設計である。さらに「Anchor Synthesis Loop」がカスタム行動の仕様を生成および修正する。この設計により、膨大な運用トレースから高精度にターゲットの行動パターンを抽出できる。
評価・考察
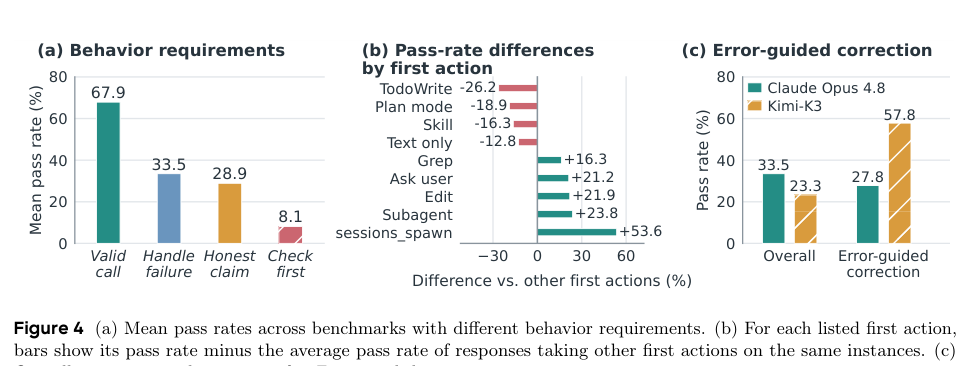
コーディングおよび一般ツール使用の実験において、人間のアノテーターはサンプリングされたインスタンスの84%で要求された行動を確認した。また、自動グレーダーの正誤判定の一致率はアノテーター間の一致率と同等レベルに達している。9つのフロンティア LLM を評価した結果、平均正解率はわずか26.7%にとどまり、現在の先端モデルでも記録された決定ポイントで適切に応答するのが困難である実態が明らかになった。
応用例と今後の展望
本手法は、再帰的自己改善(RSI: Recursive Self-Improvement)ループの主要コンポーネントとしての活用が期待される。日本のソフトウェア開発や自律型エージェントを導入するテック企業(例: クラウドサービス運用や自動コード生成分野)においては、社内ログから固有のエラーパターンのベンチマークを自動生成し、モデルの弱点を継続的に修正するパイプラインの実装に直結する。
結論
TraceDance は、実運用トレースからターゲット型の行動ベンチマークを自動構築することで、固定ベンチマークの限界を突破するシステムである。実験により、現行のフロンティアモデルのエージェントとしての行動上の脆弱性を浮き彫りにし、実用的な改善ループの基盤を提供した。
注釈
- 決定ポイントの継続(Decision-point continuation): エージェントが特定の決定を下した過去の記録地点から、その後の挙動を評価する仕組み。