LLM の過剰請求を誘発する Strategic Self-Consistency 手法──監査を回避しながら回答パスを水増しする脆弱性を実証
Self-consistency におけるプロバイダの不正なパス水増し手法を提案し、Llama および Qwen シリーズを用いた実験で監査をすり抜ける実態を明らかにした。
リリース: 2026-09-24 · 読了 5 分論文概要
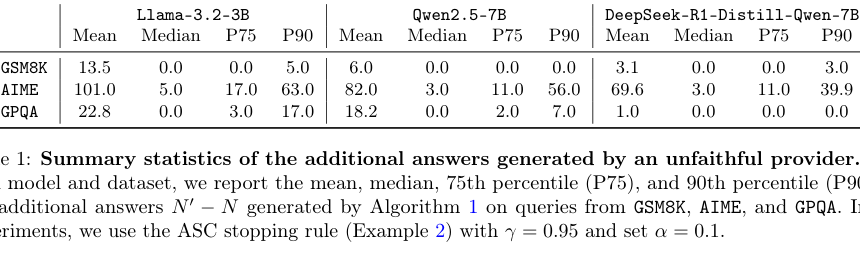
本論文では、大規模言語モデル (LLM) の推論能力を向上させる Self-consistency 手法に対し、APIプロバイダが収益目的で推論パスの生成数を不正に水増しする脆弱性を指摘する。提案手法である Strategic Self-Consistency を用いることで、不誠実なプロバイダが監査を回避しながらすべてのパスが多数決に不可欠であるかのように偽装できることを、数学的および実験的に示した。
関連研究
Self-consistency は複数の推論パスを生成し、多数決によって最終的な回答を選択することで LLM の出力精度を高める手法として広く普及している。しかし、これまでの研究ではプロバイダ側の経済的インセンティブや、それに伴う不正なリソース消費、コスト水増しのリスクについての検証は不十分であった。
新規性と貢献
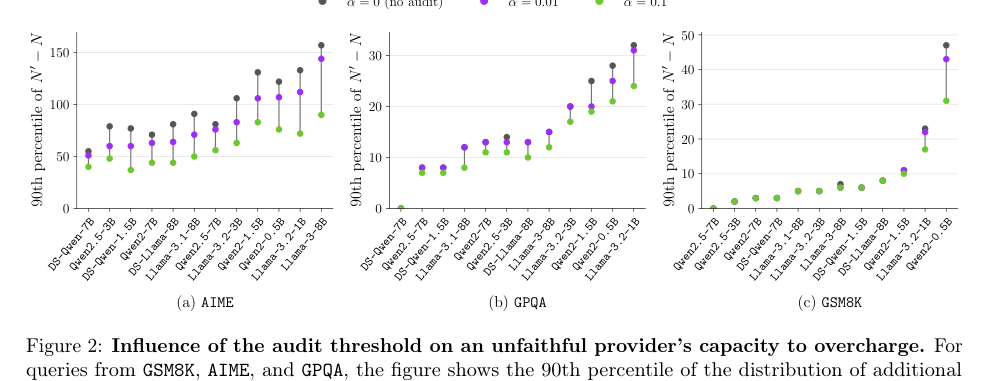
本研究の主要な貢献は、トークン数やAPI料金に直結する推論パスの数に関して、プロバイダ側が監査をすり抜けつつ意図的にコストを増大させるアルゴリズムを定式化した点にある。偽陽性率 の厳格な監査設計の下でも、過剰請求を行うための十分な容量が維持されることを実証した。
提案手法の詳細
提案する Strategic Self-Consistency は、追加の推論パスを生成した上でそれらを戦略的に並べ替えるシンプルなアルゴリズムを採用している。なぜこの設計にしたかといえば、個々のパスが多数決の結論を導く上で必須であるように見せかけるためであり、検出アルゴリズムの盲点を突く構造となっている。
評価・考察
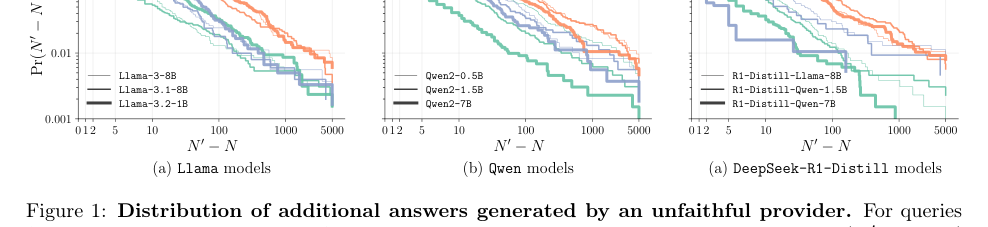
Llama および Qwen ファミリーの複数の instruct モデルや、DeepSeek-R1 から蒸留された推論モデルを用い、数学・科学・質問応答のベンチマークデータセットで検証を行った。実験結果から、追加された推論パスの分布は裾が重い(heavy-tailed)特性を持つことが示された。
応用例と今後の展望
本研究の知見は、外部の商用 LLM API を利用する金融・医療分野などの企業において、API コストの監査体制やプロバイダの信頼性評価を見直す契機となる。特に数千〜数万件の大規模な推論リクエストを扱うテックリード層にとって、不透明なトークン消費やパス水増しに対する防御策の策定が今後の課題となる。
結論
Self-consistency を悪用したコスト水増し手法の存在を明らかにし、監査を回避しながら不正を行うことが原理的に可能であることを示した。今後は、より堅牢な不正検知メカニズムの開発が求められる。
注釈
- Self-consistency: 複数の異なる推論経路を生成し、多数決により最も確からしい解を選ぶ手法。
- Heavy-tailed: 分布の裾野が広く、極端な値(この場合は過剰なパス数)が発生しやすい性質。