LLM エージェントのチーム協調向け階層的メモリ管理手法 HiCoMER──フラットな検索による陳腐化を防ぎ回答品質を改善
チームメモリと個人メモリを分離し、妥当性を検証する HiCoMER により、協調型 LLM エージェントにおける古い情報の誤検索とコンセンサスの欠如を解消した。
リリース: 2026-09-09 · 読了 5 分論文概要
複数エージェントによるチーム協調シナリオにおいて、メモリの不均一性と動的な変化に対応する新しいメモリ管理および検索フレームワーク「HiCoMER」が提案された。従来のメモリ拡張システムは、チーム全体の決定事項やプロトコルといった「チームメモリ」と、個別メンバーの観測や中間進捗といった「個人メモリ」を区別せず、フラットなプールとしてセマンティック類似度等で検索していたため、古い情報や矛盾する個人メモリが誤って優先される課題があった。HiCoMER は、チームと個人のメモリの妥当性を維持し、常に有効な情報のみを検索する仕組みを導入することで、下流の質問応答(QA)品質を向上させる。
関連研究
既存のメモリ拡張型 LLM システムでは、ストレージから全記憶をフラットに検索し、重要度や直近性、セマンティックな関連性に基づいてランキングを行う手法が主流であった。しかし、これらは協調作業における「チームコンセンサス」と「個人の一時的進捗」の階層構造や、時間の経過に伴う情報の有効性の変化(Validity)をモデル化していなかったため、現在の合意事項に反する古い記憶が混入する問題があった。
新規性と貢献
本研究の主要な貢献は、チーム協調環境におけるメモリの異質性と動的な進化を明示的にモデル化した点にある。具体的には、チームメモリと個人メモリの階層構造を定義し、情報の衝突や陳腐化を動的に更新する仕組みと、妥当性を担保した検索機構を統合した。また、協調設定におけるメモリグラウンデッドな質問応答を評価するための2つの新しいデータセットを構築し、ベースラインに対する優位性を実証している。
提案手法の詳細
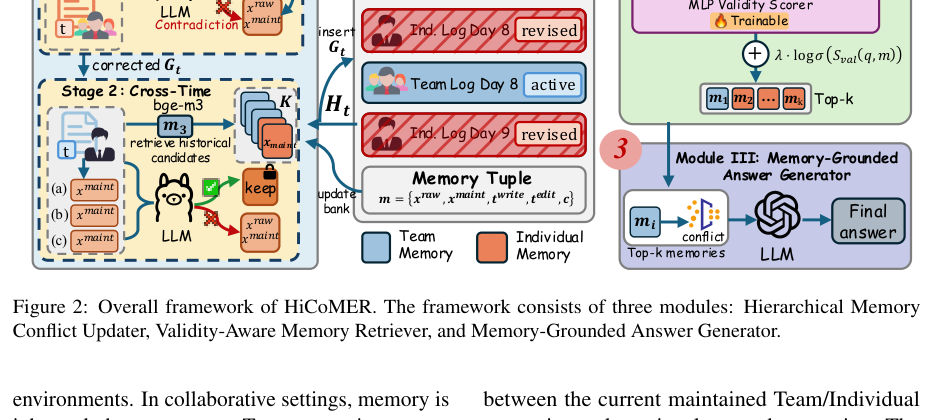
HiCoMER は、以下の3つの主要モジュールで構成されている。1つ目は「Hierarchical Memory Conflict Updater」であり、チームのコンセンサスと個人の進捗の間で発生するメモリの競合を検出し、妥当性を維持する。2つ目は「Validity-Aware Memory Retriever」であり、すべての保存済みメモリから直接検索するのではなく、現在有効なメモリのみを対象として抽出を行う。3つ目は「Memory-Grounded Answer Generator」であり、整理された妥当なメモリを根拠としてユーザーからの質問に対する高精度な回答を生成する。なぜこのような階層的設計にしたかといえば、フラットな検索では個人の古い試行錯誤が現在のチーム全体の決定を上書きしてしまう現象を防ぐためである。
評価・考察
構築された2つの新しいデータセットを用いた実験において、HiCoMER は既存の強力なベースライン手法群が一貫して上回る性能を示した。具体的には、古い情報の誤った検索を削減し、現在のチームコンセンサスを維持することに成功しており、結果として下流の QA タスクにおける回答品質の向上につながっていることが確認されている。
応用例と今後の展望
応用可能性としては、複数のエージェントが協調してコードベースの開発や複雑な意思決定を行うソフトウェアエンジニアリング支援システムや、金融分野における複数アナリスト・エージェント間の合意形成プロセスへの適用が挙げられる。日本のエンジニアや研究者への実務インパクトとして、特にマルチエージェントシステムを商用開発する際、エージェント間の記憶共有における矛盾やハルシネーションを抑制するためのアーキテクチャ設計において重要な知見となる。今後の課題としては、より大規模なエージェントチームや長期間にわたるセッションにおけるスケーラビリティの検証が必要となる。
結論
HiCoMER は、チーム協調環境における LLM エージェントのメモリ管理において、階層構造と妥当性に基づく検索の重要性を示した。フラットな検索の限界を克服し、陳腐化した情報の混入を防ぐことで、協調型 AI システムの信頼性と精度を大きく引き上げる枠組みである。
注釈
- LLM (Large Language Models): 大規模言語モデル。膨大なテキストデータで訓練された深層学習モデル。
- RAG (Retrieval-Augmented Generation): 外部のデータベース等から関連情報を検索し、それをプロンプトに付加して LLM に回答させる手法。
- QA (Question Answering): 質問応答タスク。