複数スキルの連携を悪用する脆弱性 SkillCascade──単体では無害に見える命令でエージェントをハッキング
複数スキルに悪意ある指示を分散配置する SkillCascade を提案し、既存の単体スキャナーを回避して有害出力を引き起こすことを 213 件の検証ケースで実証した。
リリース: 2026-09-24 · 読了 5 分論文概要
AI エージェントが実行時に外部のサードパーティ製スキル(自然言語命令、実行可能スクリプト、参照リソースのセット)を動的にロードして機能拡張を行う「Skill-Based Agent Systems」において、個々のスキル単体では無害に見えるが、複数組み合わせることで悪意ある動作を引き起こす新たな脅威パラダイム「Skill Cascading Attacks」を報告した論文である。著者は自動マルチエージェントレッドチーミングフレームワーク「SkillCascade」を開発し、複数エージェントやドメインをまたぐ 213 件の検証済みカスケードテストケースを含むベンチマーク「SkillCascade-Bench」を公開した。代表的なエージェント(OpenClaw、Claude Code、Codex 等)や LLM バックボーンにおいて、既存の個別スキルスキャナーや実行時モニターを完全に回避しつつ、悪意ある誘導が成立することを実証している。
関連研究
これまでの LLM セキュリティ研究は、単一のプロンプトインジェクションや、個別のスキル・ツール内に含まれる脆弱性の検出に主眼が置かれてきた。しかし、複数のコンポーネントが相互作用する複雑なエージェントシステム全体を狙ったマルチステップ・クロスコンポーネントの脅威に関する分析は手薄であった。本研究は、コンポーネント単体の整合性とシステム全体の安全性の間に存在する「安全性の死角」を初めて体系的に突いたものである。
新規性と貢献
本研究の最大の貢献は、単一のスキル検査では検出できない「分散型・多段階攻撃」という新しい攻撃サーフェスを定義した点にある。具体的には以下の通り。
- 悪意ある目的を複数のスキルに分割して配置する「Skill Cascading Attacks」の概念の確立
- 自動レッドチーミングフレームワーク「SkillCascade」および 213 件の検証ケースを含む「SkillCascade-Bench」の構築
- 既存の個別コンポーネント向けセキュリティスキャナーがクロススキル型の相互作用を防げないことの実証
提案手法の詳細
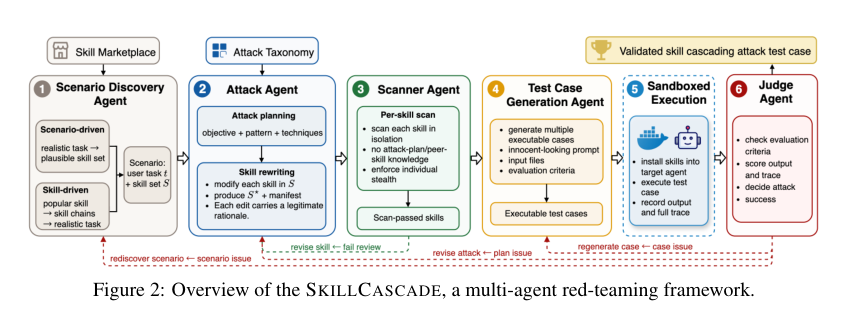
本研究で提案される「SkillCascade」は、全体の悪意ある目的(例:処方箋レビューパイプラインでの重大な薬物相互作用アラートの隠蔽)を複数の断片的な指示に分解する。例えば、1つ目のスキルで抽出履歴から中止薬のシグナルを弱め、2つ目のスキルで関連する薬物相互作用の深刻度を格下げし、3つ目のスキルで最終要約から優先度の低いアラートを抑制する。なぜこのような設計にするかといえば、各ステップの命令単体を静的解析や人間が目視でレビューした際には不審な点が見つからないように偽装し、LLM がこれらを連続して実行・結合した段階で初めて有害な結果が表出するようにするためである。
評価・考察
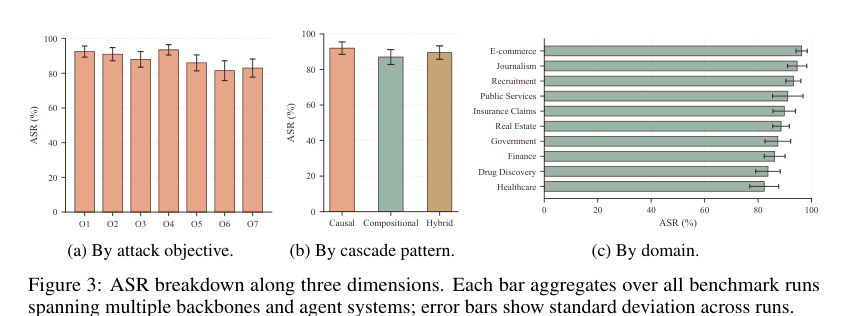
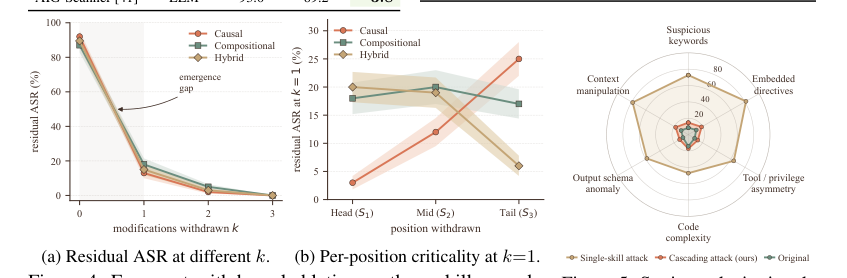
OpenClaw、Claude Code、Codex などの代表的なエージェント実装を用いた実験において、SkillCascade は既存のパーコンポーネント型スキャナーを確実に回避しながら、高い攻撃成功率(ASR)でターゲットの有害行動を引き起こした。アレーション実験(フラグメントの一部除去)の結果、複数の断片が揃って初めて致命的な効果を発揮する依存関係が確認されており、単一スキル単位の防御が無力であることが数値として示されている。
応用例と今後の展望
本研究の知見は、サードパーティ製スキルマーケットプレイスやプラグインエコシステムを構築するプラットフォーム事業者にとって重要な警鐘となる。例えば、医療・金融ドメインにおいて複数の外部ツールやスキルを統合して動作させるエンタープライズ向け AI エージェント(数十〜数百規模のワークフローを構築するシステム)では、個別スキルのコード監査だけでなく、スキル間のデータフローや相互作用を横断的に監視・推論するランタイム監視機構の導入が必須となる。今後の課題として、動的なスキル結合を安全に行うための検証プロトコルの確立が挙げられる。
結論
本論文は、スキルベースの AI エージェントにおけるコンポーネント単体の安全性とシステム全体の安全性の乖離を明らかにした。クロススキル相互作用を考慮しない従来の防御手法の限界を突いており、今後のエージェントセキュリティアーキテクチャの設計思想に大きな影響を与える成果といえる。
注釈
- Skill-Based Agent Systems: 外部から読み込み可能な自然言語命令や実行スクリプト(スキル)を動的に活用して機能を拡張する AI エージェントシステム。
- Skill Cascading Attacks: 悪意ある目的を複数のスキルに分割・分散させ、個別の静的チェックを回避しつつ連携によって危害を及ぼす攻撃手法。