エージェント型 AI の実運用評価手法 CARGO──動的エンティティの参照乖離を解消し識別指数を 0.58 に改善
実運用におけるエージェント評価の参照乖離を防ぐ CARGO フレームワークにより、識別指数 DI を 0.58 に引き上げつつ誤検知をゼロに抑えた。
リリース: 2026-09-24 · 読了 5 分論文概要
動的エンティティを操作する実運用型エージェント AI(Agentic AI)の評価において、従来の参照ベースの LLM-as-a-judge 手法が抱える構造的課題を解決するフレームワーク「CARGO」が提案された。動的エンティティ(サポート案件や資産、アカウント等)を扱うシステムでは、利用可能な参照データが異なるエンティティに対する正しい手順を適用しているため、従来のジャッジは識別子や日付、ステータスを誤りやハルシネーションとしてペナルティを課してしまう。これを「参照インスタンス乖離(Reference-Instance Divergence: RID)」と定義し、CARGO は事実判定をライブインスタンスの観測コンテキストに根拠づけることでこの問題を克服する。246項目、2つのジャッジモデル、7,872件の評価を用いた診断スイート CARGO-Bench において、標準的な参照ベースジャッジは正しい回答の 100% に対して誤ったペナルティを課し、識別指数(Discrimination Index: DI)がほぼ 0 であったのに対し、CARGO は誤ペナルティを 0 件に抑えつつ、矛盾の検出において高水準の再現率を維持し、DI を 0.58 に引き上げた。
関連研究
LLM の出力評価において、GPT-4 などの強力なモデルをジャッジとして利用するアプローチ(LLM-as-a-judge)が一般化している。しかし、静的なベンチマークや固定された参照回答を前提とするものが多く、実運用環境(Production)における動的なコンテキスト変化や、異なるエンティティ識別子を伴うエージェントの出力に対する評価の歪みについては十分に検討されていなかった。本研究は、実運用環境特有のデータ乖離に着目した初めての体系的な評価フレームワークの提案である。
新規性と貢献
本研究の主要な貢献は以下の 3 点である。
- 動的エンティティを伴うエージェント評価における失敗モード「参照インスタンス乖離(RID)」の定義。
- 参照を「手続きの手本」として扱い、事実判定をライブコンテキストに基盤づけることで誤ペナルティを排除する CARGO フレームワークの開発。
- 厳密な正解(Ground truth)を持つ摂動ベースの診断スイート CARGO-Bench の構築と、評価におけるトレードオフ(LENIENCY と PROCEDURAL CORRUPTION の検出漏れ)の特定。
提案手法の詳細
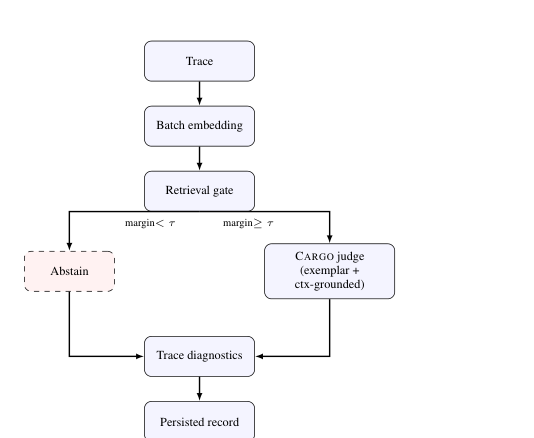
CARGO フレームワークは主に以下の 3 つのコンポーネントで構成されている。
- 手続きのエンプラ化: 取得した参照情報を、直接の正解ターゲットではなく「手続きの手本(プロセジューラル・エグザンプラー)」として扱う。
- 3 値ステータス割り当て: 各主張に対して「支持(supported)」「矛盾(contradicted)」「検証不能(unverifiable)」の 3 値ステータスを割り当て、ペナルティを明らかな矛盾のみに限定する。
- 信頼度ベースのゲート制御: 検索の信頼度によって評価をゲート制御し、プロダクション評価を選択的予測(Selective Prediction)の問題として再定式化する。
評価・考察
246項目のデータと 2 つのジャッジモデル、合計 7,872 件の判断を用いた CARGO-Bench の実験では、標準的な参照ベースジャッジがエンティティ移植された正しい回答の 100% を誤りとしてペナルティを課し、識別指数 DI がほぼ 0(DI ~ 0)であったことが示された。単にライブの事実を補うだけではこの問題は解決しない。これに対し CARGO は、誤ペナルティを 50 件中 0 件に削減しつつ、矛盾の再現率を 50/50 および 49/50 と維持し、DI を 0.48 から 0.68 の範囲(中央値 0.58)まで向上させた。一方で、エンティティの値を保護する寛容さが手続き上の破損(procedural corruptions)の検出を抑制してしまうというトレードオフ(再現率 20%)も露呈しており、事後修正でもこのギャップは完全に埋まらないことが確認されている。
応用例と今後の展望
本手法は、動的なデータベースや顧客情報をリアルタイムに参照して回答を生成するカスタマーサポート向けエージェントや、金融・医療分野の自動業務処理システムの運用監視において実用的なインパクトを持つ。特に数千件規模のトラフィックを処理する本番環境において、誤検知によるアラート疲れや不要なフォールバックを防ぐための自動評価基盤として活用できる。今後の課題としては、エンティティ値の保護と手続きの正確性の検証を両立させるための新たなジャッジ設計や、リスク・カバレッジを考慮したコスト最適化が挙げられる。
結論
CARGO は、実運用型エージェント評価における参照インスタンス乖離を解消し、誤ペナルティの発生を防ぐ有効なアプローチを示した。評価の信頼性を高める一方で、手法特有のトレードオフも明らかになっており、今後の実運用におけるエージェント監視システムの設計に重要な示唆を与える。
注釈
- Agentic AI: 単なるテキスト生成にとどまらず、自律的にツールや API を呼び出してタスクを遂行する AI システム。
- RID (Reference-Instance Divergence): 参照データの前提と、実運用時のライブインスタンスのコンテキスト間に生じる乖離。