onPanda:LLMとエージェント向けオンポリシーアライメントデータをトークン単位修正で効率化──アノテーション時間を52%削減
トークン単位の修正ループによりモデルのサンプリング分布を維持したまま、従来の手動後編集比で中央値アノテーション時間を52%削減した対話型アノテーション手法
リリース: 2026-09-21 · 読了 4 分論文概要
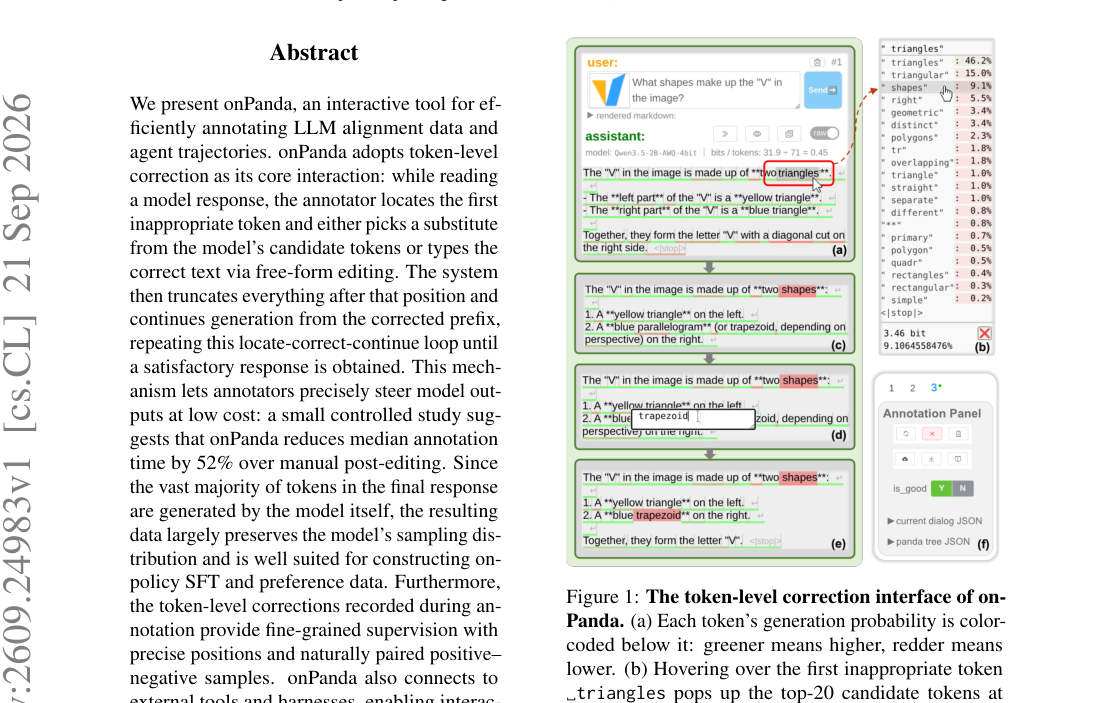
Lei YangらによるonPandaは、大規模言語モデル(LLM)およびAIエージェントのアライメントデータと軌跡(trajectory)の効率的なアノテーションを実現する対話型ツールである。従来の手動による事後編集や全生成やり直しに代わり、トークン単位の修正(token-level correction)を採用することで、モデルのサンプリング分布を維持した高品質なオンポリシーSFT(Supervised Fine-Tuning)および選好データの構築を可能にしている。制御された調査において、従来の中央値と比較してアノテーション時間を52%削減した。
関連研究
従来、LLMのアライメント調整には人間によるフィードバック(RLHF)や、静的なデータセットに対する手動での事後編集が広く用いられてきた。しかし、オフポリシー(off-policy)なデータ構築ではモデルが実際に生成する分布と乖離が生じやすく、またエージェント環境での動的な軌跡収集コストが極めて高いという課題があった。本研究は、生成プロセスへインタラクティブに介入する仕組みにより、この効率と分布のトレードオフを解消する。
新規性と貢献
本研究の最大の貢献は、トークン単位のインタラクションに基づく新しいアノテーションパラダイムの提示である。修正位置以降を切り捨てて再生成を行う「locate-correct-continue」ループにより、自然な形でモデルの生成能力を活用しながら正確な誘導を行う。さらに、注釈済みのデータセット「Panda-CVL」およびトークン単位修正のベンチマークを公開し、外部ツールと接続したエージェント環境での軌跡注釈もサポートする。
提案手法の詳細
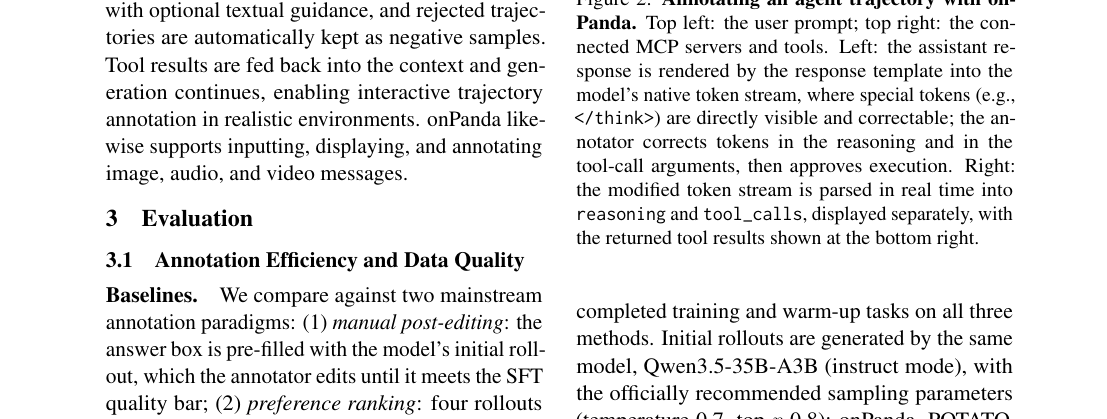
onPandaの核心は「locate-correct-continue」ループにある。アノテータはモデルの応答を読み進める中で、不適切な最初のトークンを特定し、モデルの候補トークンからの選択または自由記述による置換を行う。システムはその位置以降の出力を自動で切り捨て、修正されたプレフィックスから生成を継続する。この仕組みにより、応答の大部分がモデル自身によって生成されるため、サンプリング分布が保持され、精度の高い選好データ(ポジティブ・ネガティブペア)やスーパービジョンが自然に取得できる。
評価・考察
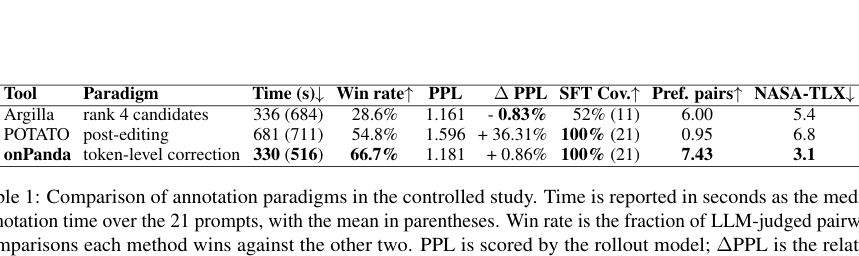
制御された実験において、onPandaは従来の手動事後編集手法と比較して、中央値アノテーション時間を52%短縮することに成功した。最終的な応答トークンの大部分をモデル自身が生成しているため、得られたデータはオンポリシー学習に適した特性を維持している。また、記録されたトークン単位の修正履歴は、正確な位置情報を持った微細な教師信号として機能する。
応用例と今後の展望
本手法は、カスタムLLMや自律型AIエージェントの開発において、アライメントデータのコスト削減と品質向上の両立を迫られている開発現場に直結する。特に、金融や医療といったドメイン特化型エージェント開発において、人間の意図を精密に反映したオンポリシーデータを効率的に収集する基盤として活用可能である。今後の課題としては、より複雑なマルチモーダル環境や長文脈エージェントへのスケーラビリティ検証が挙げられる。
結論
onPandaは、トークン単位の対話型修正ループを通じてLLMおよびエージェントのオンポリシーデータアノテーションを効率化する手法である。アノテーション時間を大幅に削減しつつ、モデルのサンプリング分布を維持した高品質な学習データ構築を実現している。
注釈
- オンポリシー (On-policy): 現在最適化中のモデル自身が生成したデータや方策に基づいて学習を行うアプローチ。
- SFT (Supervised Fine-Tuning): 教師あり微調整。正解ペアデータを用いてモデルのパラメータを調整するプロセス。