Flash-dLLM: 拡散 LLM の高速化を実現する I/O 認識型 KV キャッシュと並列デコード手法──GSM8K で 5.1 倍の高速化を達成
Diffusion LLM におけるメモリ I/O ボトルネックを解消する融合カーネルと、補助モデル不要の draft-and-verify デコードにより、既存手法比で大幅な高速化とメモリ効率化を両立。
リリース: 2026-09-22 · 読了 5 分論文概要
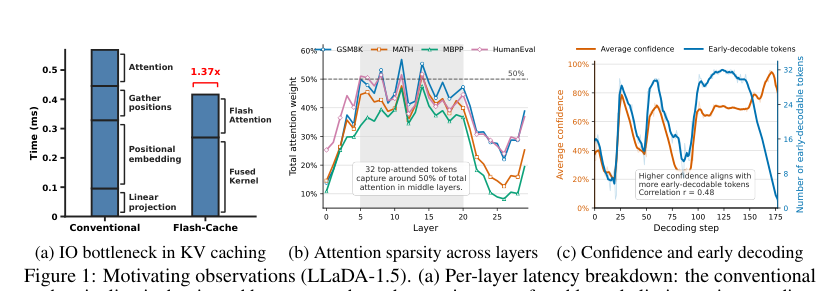
Diffusion Large Language Models (dLLMs) は、非自己回帰的なテキスト生成を可能にするアプローチとして注目されているが、効率的な Key-Value (KV) キャッシュや並列デコード機構の欠如により、推論コストが高いという課題を抱えていた。本論文では、トレーニング不要で高速かつメモリ効率の高い推論アクセラレーションフレームワーク「Flash-dLLM」を提案する。Flash-dLLM は、GPU メモリ I/O が最大のボトルネックであることを見出し、I/O 認識型の融合 KV キャッシュカーネルと、補助モデルを必要としない独自の draft-and-verify デコード戦略を統合することで、生成品質を維持したまま大幅な高速化とスケーラビリティの向上を実現している。GSM8K および HumanEval ベンチマークにおいて、既存の最強ベースラインである Elastic-Cache と比較してそれぞれ 5.1 倍、11.0 倍の高速化を達成した。
関連研究
dLLM の推論高速化において、KV キャッシュの再利用と並列トークン検証はこれまで個別に研究されることが多く、両者を同時に適用した際に生じるメモリ I/O ボトルネックは見過ごされてきた。また、従来の自己回帰モデル向け加速手法をそのまま適用することは、非自己回帰的生成の特性上困難であった。
新規性と貢献
本研究の最大の貢献は、dLLM におけるメモリ I/O ボトルネックを初めて体系的に分析し、それを解決する I/O 認識型 KV キャッシュと、モデル単体で動作する draft-and-verify デコード戦略を統一的なフレームワークとして設計した点にある。外部の補助モデルを不要としながら、数学推論やコード生成タスクにおいて既存の SOTA(State-of-the-Art)手法を圧倒する数値を示している。
提案手法の詳細
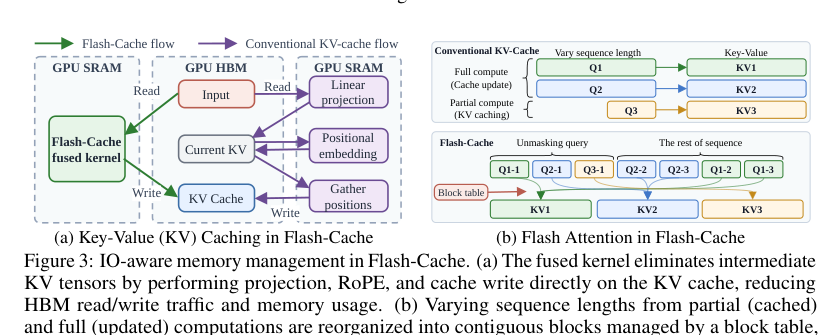
Flash-dLLM は、重複するメモリ移動を削減する I/O 認識型融合 KV キャッシュカーネルを導入している。これにより、GPU メモリ帯域の圧迫を抑えつつキャッシュの効率的な再利用を可能にしている。さらに、この最適化されたキャッシュ機構を基盤として、dLLM 自身がドラフター(生成側)とベリファイアー(検証側)の両方の役割を兼ねる KV キャッシュ駆動型の draft-and-verify デコード戦略を構築した。追加の軽量モデルをロードする必要がないため、メモリフットプリントを最小限に抑えながら並列デコードの恩恵を受けられる設計となっている。
評価・考察
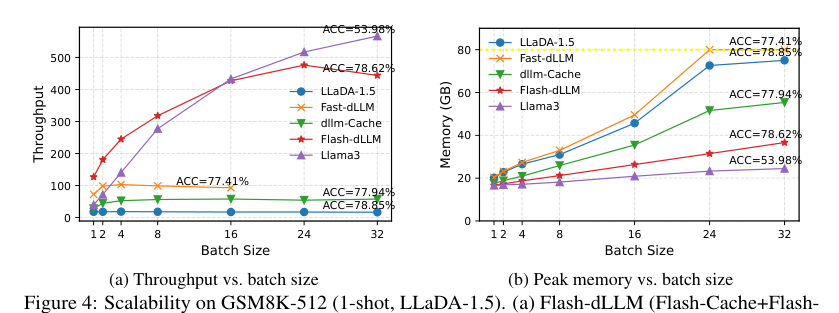
数学的推論(GSM8K)およびコード生成(HumanEval)のベンチマーク評価において、Flash-dLLM は既存の最強ベースラインである Elastic-Cache に対し、GSM8K で 5.1 倍、HumanEval で 11.0 倍という劇的なスピードアップを記録した。長文脈や大規模バッチサイズにおけるスケーラビリティの検証でも、ピークメモリ使用量を抑えつつ安定した高スループットを維持できることが示されている。
応用例と今後の展望
非自己回帰型 LLM を実プロダクトやリアルタイム応答システムに導入する際最大の障壁であった推論遅延とメモリ消費量を大幅に削減する。国内の生成 AI アプリケーション開発企業やクラウドインフラ運用者において、大規模なバッチ処理やコード生成支援ツールのコスト効率を改善するための実装候補となり得る。今後は、より多様なタスクやマルチモーダル設定への拡張が期待される。
結論
Flash-dLLM は、dLLM の推論における根本的なメモリ I/O のボトルネックを解消し、トレーニング不要で実用的な高速化をもたらす画期的なフレームワークである。品質を損なわず大幅なスピードアップを実証したことで、非自己回帰モデルの実用化を加速させる基盤技術となる。
注釈
- Diffusion Large Language Model (dLLM): 拡散モデルの枠組みをテキスト生成に応用し、非自己回帰的にトークンを生成する言語モデル。
- Draft-and-Verify: 軽量なモデルや手法で候補トークン(ドラフト)を高速に生成し、本命のモデルで一括検証して効率化を図るデコード手法。