Ovis-Embedding: テキスト・画像・動画・音声を統合するオムニモーダル埋め込みモデル──MMEBやMVEBでSOTAを達成
共有マルチモーダルバックボーンと均質ソースサンプリングにより、テキストから音声まで任意のモダリティを単一の表現空間に統合し、主要なマルチモーダル検索ベンチマークで最高性能を更新した。
リリース: 2026-09-21 · 読了 5 分論文概要
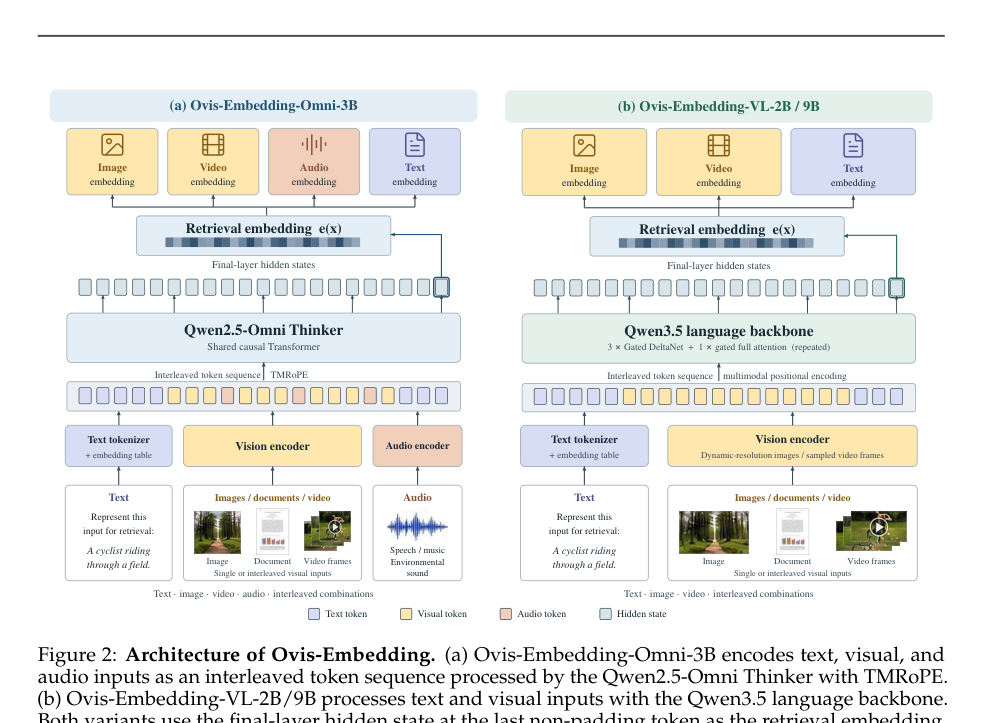
Ovis-Embeddingチームは、テキスト、画像、動画、音声をネイティブに統合した最先端のオムニモーダル埋め込みモデルファミリー「Ovis-Embedding」を発表した。従来のモダリティごとに独立したタワーを構築するアプローチとは異なり、共有マルチモーダルバックボーンを採用することで、あらゆるモダリティを同一の表現空間にエンコードする。これにより、MMEB-v3、MMEB-v2、MVEB、MAEB、RTEBなどの主要なベンチマークにおいて既存の最高性能を更新し、any-to-any検索の基盤としての有効性を実証した。
関連研究
これまでのマルチモーダル表現学習では、テキストや画像、音声ごとに専用のエンコーダ(タワー)を用意し、それらを後段で整合させる手法が主流であった。しかし、この方式ではモダリティ間のフラグメンテーション(断片化)が課題となり、複雑なクロスモーダル検索や任意の組み合わせによる統合処理においてスケーラビリティの限界があった。本研究は、事前学習済みの統合モデルをバックボーンに利用することで、モダリティ間の壁を取り払うアプローチをとっている。
新規性と貢献
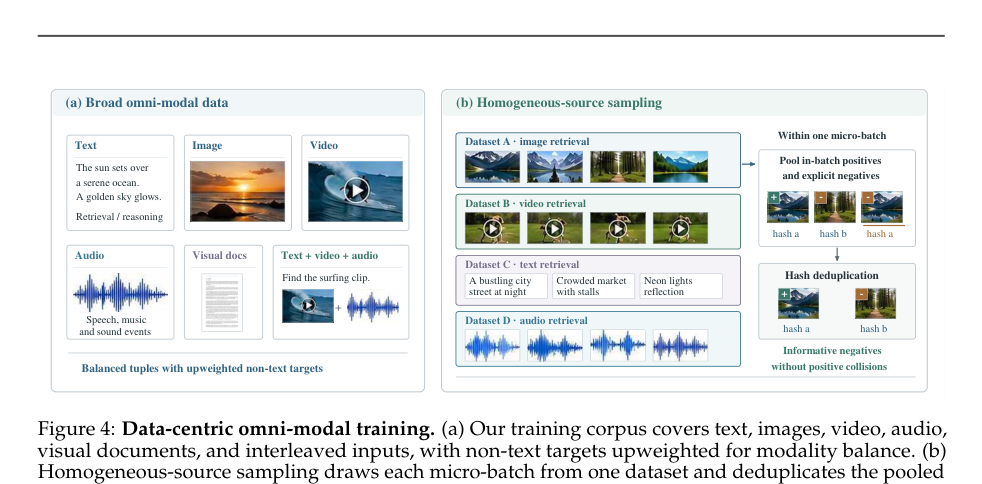
本研究の主要な貢献は、ネイティブなオムニモーダル初期化、データ中心の訓練戦略、および埋め込み特化型の最適化という3つの技術的進歩にある。これにより、異なるモダリティ間での意味的な乖離を最小限に抑えつつ、多様なデータソースから効率的に高品質な共通表現を獲得できる点が学術的・実用的な新規性である。
提案手法の詳細
提案手法のアーキテクチャと学習・推論の最適化は以下の3つの要素で構成されている。
- ネイティブオムニモーダル初期化: 事前学習済みのQwen-omniモデルを埋め込みバックボーンとして採用し、低ランク初期化を伴うコントラスティブ学習(対照学習)を通じて適応させる。
- データ中心のオムニモーダル訓練: テキスト、画像、動画、音声、およびインターリーブ形式のマルチモーダルデータを含む大規模で高品質なコーパスを構築する。データ効率を向上させるため、タスク一貫性のあるバッチを形成する「均質ソースサンプリング(homogeneous-source sampling)」を導入し、有益なインバッチネガティブを活用する。
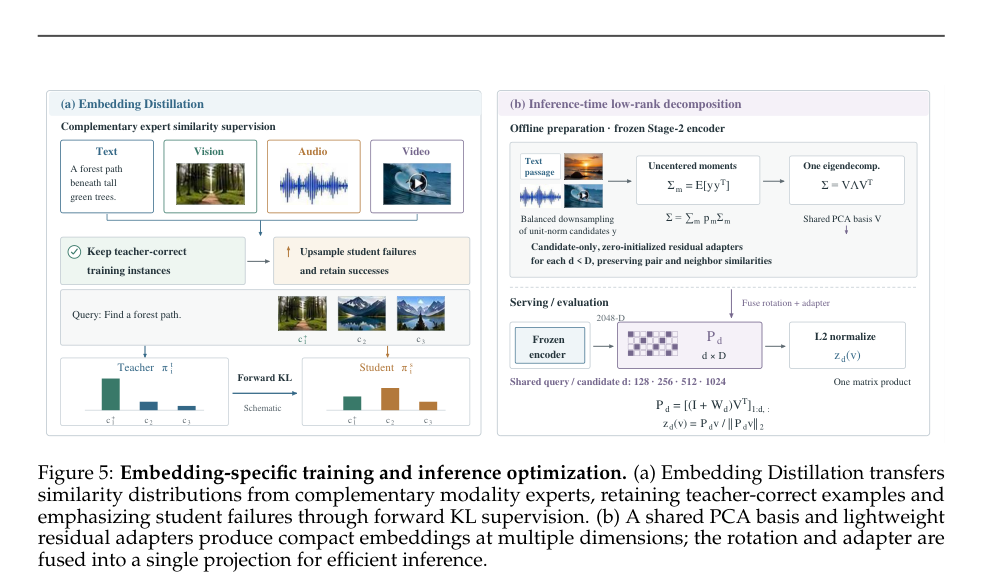
- 埋め込み特化の訓練と推論最適化: フォーカルロス(focal loss)を用いて困難なサンプル(hard examples)に焦点を当て、類似度ベースの埋め込み蒸留(Embedding Distillation)によって補完的なエキスパートからきめ細かい類似度構造を転写する。推論時には、低ランク特徴分解により、最小限の性能劣化で柔軟な次元数を持つコンパクトな埋め込みを実現する。
評価・考察
実証評価において、Ovis-Embeddingファミリーは MMEB-v3、MMEB-v2、MVEB、MAEB、および RTEB の各ベンチマークで最先端(SOTA)のパフォーマンスを達成した。テキスト、画像、動画、音声の全モダリティにわたって一貫して高い性能を示しており、統一されたオムニモーダル訓練がモダリティの断片化を克服するために極めて有効であることが示されている。
応用例と今後の展望
あらゆるモダリティ間のクロスモーダル検索や、マルチメディアデータを統合的に扱うエンタープライズ検索基盤への応用が期待される。日本のAI研究開発・エンジニアリング現場においては、例えば動画・音声・テキストが混在するコールセンターのアーカイブ解析や、製造業におけるマニュアル(テキスト・画像)と作業動画の統合検索システムの実装において、複数モデルを組み合わせるパイプラインを単一モデルに置き換えるための有力な選択肢となる。
結論
Ovis-Embeddingは、共有マルチモーダルバックボーンと独自のエンドツーエンド最適化により、任意のモダリティ間での高精度な検索と表現学習を実現した。モダリティの垣根を越えたユニバーサルな埋め込みモデルの新たな標準を示すものである。
注釈
- オムニモーダル: テキスト、画像、動画、音声など、あらゆる種類のモダリティを区別なく統合して処理する性質のこと。
- コントラスティブ学習: 類似したデータ同士の表現を近づけ、異なるデータ同士の表現を遠ざけるようにモデルを訓練する機械学習の手法。