LLM は 2 つの思考を同時に処理可能──線形重ね合わせ仮説の検証と同時生成手法
Transformer における入力の線形結合と次トークン分布の重ね合わせを実証し、軽量なファインチューニングで線形性を復元する guided decoding 手法を提案。
リリース: 2026-09-24 · 読了 5 分論文概要
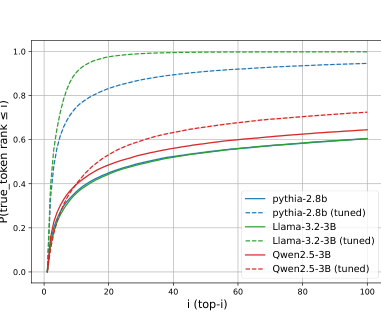
Large Language Models (LLM) は非線形なコンポーネントを多数抱えているにもかかわらず、異なるテキストストリームの入力を線形結合した際に、モデルが出力として個別の次トークン分布の重ね合わせを返すというファンダメンタルな線形性を持つことを本研究は証明した。著者らはこれを「Superposition Linearity Hypothesis(重ね合わせ線形性仮説)」と命名している。
関連研究
従来、Transformer の内部機構における線形性や重ね合わせ現象については主に特徴量レベルでの圧縮や解釈性の観点から研究されてきた。本論文では、モデルの入力レベルでの線形結合に対する出力挙動に着目し、アーキテクチャの根本的な性質としてこれが存在することを明らかにしている。
新規性と貢献
本研究の主要な貢献は、Transformer アーキテクチャが本質的に線形重ね合わせの特性を有していることを示した点にある。特筆すべきは、この線形性は学習の過程で獲得される emergent なものではなくアーキテクチャ自体の本質的性質であり、プレトレーニングが進むにつれてむしろ減衰することを発見したことである。さらに、軽量なファインチューニングによってこの線形性を大幅に復元できることを示し、単一のフォワードパスで複数の文脈を同時に処理・生成する guided decoding 手法を実証した。
提案手法の詳細
本研究では、入力の線形結合に対する次トークン分布の divergence を最小化する軽量なファインチューニング手法を導入している。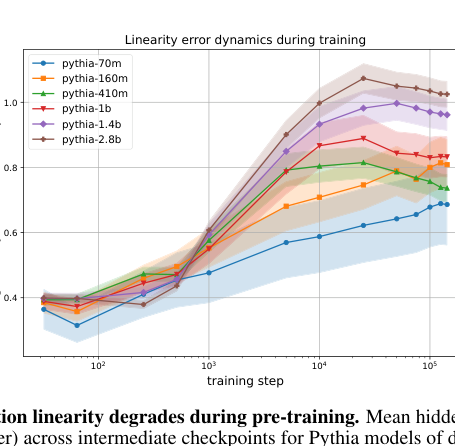 また、モデル内部で混ざり合った出力を分離し、1回のフォワードパスから2つのコヒーレントな継続テキストを同時に生成する guided decoding 手法を設計した。これにより、計算コストを抑えながら複数ストリームの並行処理を実現している。
評価・考察
評価実験により、通常のプレトレーニングが進んだモデルでは線形性が低下する一方で、提案する軽量ファインチューニング適用モデルでは予測される次トークン分布と個別の次トークン分布の平均との間の divergence が大幅に縮小することが確認された。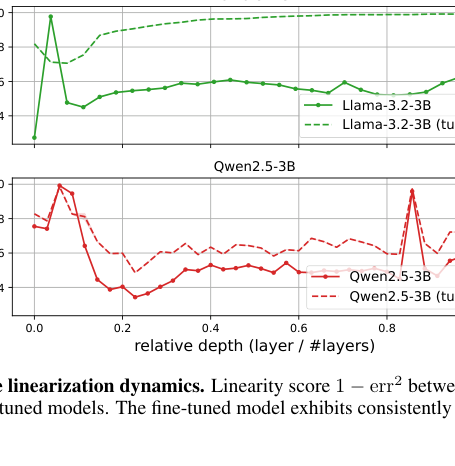 これにより、理論上の仮説が実用的なデコード手法へと結びつくことが示されている。
応用例と今後の展望
本手法は、マルチタスク推論や対話システムにおいて、単一のモデル実行で複数のコンテキストや仮説を同時に評価・生成する基盤技術としての応用が期待される。特に、日本の金融・医療分野における複数文書のクロスドキュメント分析やリアルタイム対話システムの推論スループット改善において、計算リソースを半減させる実務インパクトを持つ可能性が未確認ながら示唆される。
結論
本論文は、LLM が入力の線形結合に対して次トークン分布の重ね合わせを出力するという「Superposition Linearity Hypothesis」を提唱・検証した。プレトレーニングによる線形性の減衰と、軽量ファインチューニングによるその復元、さらに guided decoding による同時生成の実現は、Transformer アーキテクチャの新たな利用可能性を切り拓くものである。
注釈
- Superposition Linearity Hypothesis: Transformer が複数の入力を線形結合した際、その出力が個別の入力に対する出力の重ね合わせになるという仮説。
- Guided Decoding: モデルの出力過程において、特定の制約や誘導を適用して目的のテキスト生成をコントロールする手法。