GLM-4.5-Air-Base ベースの 8 段階オープンポストトレーニング手法 Rufus-Air 公開──公式モデル超えを達成
GLM-4.5-Air-Base を起点とした 8 段階のシリアルパイプラインによるポストトレーニング手法を提案し、公式リリースモデルを上回る性能を実証した。
リリース: 2026-09-24 · 読了 5 分論文概要
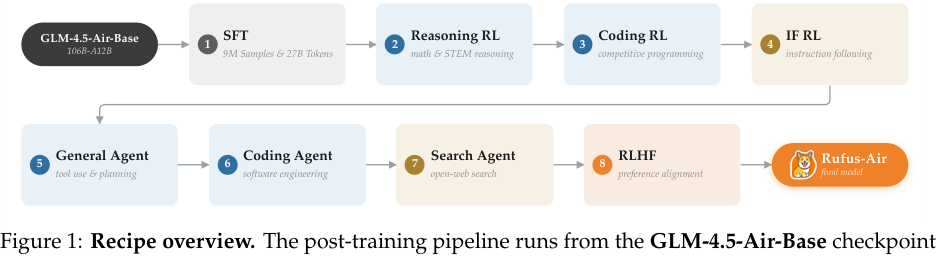
本論文では、大規模言語モデル(LLM)のオープンで再現可能なポストトレーニング手法である「Rufus-Air」を提案する。GLM-4.5-Air-Base(106B-A12B)をベースモデルとし、SFT、Reasoning RL、Coding RL、Instruction-Following RL、General Agent、Coding Agent、Search Agent、そして RLHF からなる 8 段階のシリアルパイプラインを通じてモデルを強化する。新規の人間によるアノテーションや社内の蒸留用教師モデルを用いず、オープンソースのコンポーネントと公開データのみで構築されている点が特徴である。評価の結果、公式の GLM-4.5-Air ポストトレーニング済みリリースを上回り、同等サイズのオープンモデルと競合する性能を持つことが示された。
関連研究
LLM のポストトレーニング領域では、SFT や強化学習(RL)の最適な順序やデータ構成に関する体系的な知見が不足していた。従来の手法はクローズドなデータや独自のインフラストラクチャに依存することが多く、コミュニティ全体での再現性が低いという課題があった。本研究は、オープンなコンポーネントとパブリックデータのみを用いて、大規模 MoE(Mixture of Experts)モデルにおける全 8 段階のトレーニングレシピを完全に文書化し、再現性を提供点で先行研究と一線を画す。
新規性と貢献
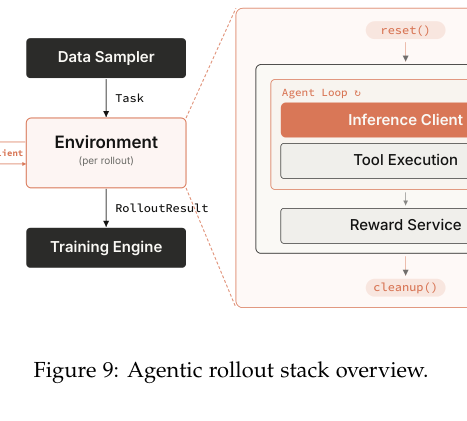
本研究の最大の貢献は、106B パラメータ規模の MoE モデルに対する完全なオープンポストトレーニングレシピの公開である。主な知見として、(i) 多様で高品質な SFT が強力な能力のフロアを確立すること、(ii) 難易度フィルタリングによって強化学習(RL)のプロンプトを生産的な学習範囲に維持できること、(iii) 報酬の信頼性がステージの順序付けの原則となること、(iv) インフラストラクチャの設計自体がレシピの一部であること、が挙げられる。
提案手法の詳細
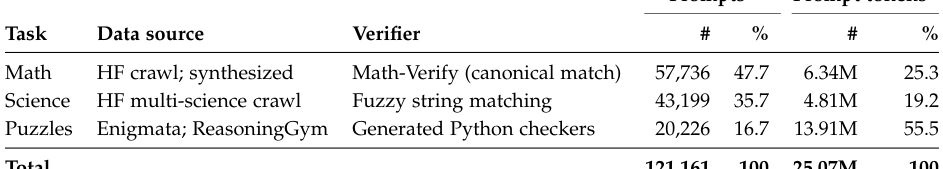
Rufus-Air は、基本的な能力から高度な能力へと段階的に移行する 8 段階のパイプラインを採用している。学習が進むにつれて、ハードで検証可能な報酬から、よりソフトなジャッジベースのシグナルへと移行する設計になっている。ステージの順序は、報酬の信頼性に基づいて慎重に設計されており、モデルが段階的かつ安定して複雑なエージェント能力や推論能力を獲得できるように最適化されている。
評価・考察
評価では、公式の GLM-4.5-Air リリースモデルとの比較が行われた。Rufus-Air は公式のポストトレーニング済みリリースを上回る性能を達成し、同等サイズの他のオープンモデル群とも肩を並べる結果を示した。特に、難易度フィルタリングや報酬信頼性に基づくステージ順序付けが、トレーニングの安定性と最終的なモデル性能の向上に直結していることが確認された。
応用例と今後の展望
本手法は、大規模なオープン LLM を自社インフラや国内の商用・研究環境において独自にポストトレーニングする際の標準的なレシピとして活用できる。特に、国内の AI ベンダーや研究機関(例: 100B パラメータ規模の MoE モデルを扱う自然言語処理研究室やエンタープライズ企業)において、オープンデータを活用した高精度な推論・エージェントモデル開発コストを大幅に削減する実務インパクトを持つ。今後の課題としては、さらに多様なドメインへの拡張や、計算効率の最適化が挙げられる。
結論
Rufus-Air は、GLM-4.5-Air-Base をベースにした 8 段階のオープンなポストトレーニングレシピを提示し、公式モデルを超える性能を実証した。公開されたデータ、報酬設計、インフラストラクチャの知見は、今後のオープン LLM 開発における重要な基盤となる。
注釈
- MoE (Mixture of Experts): 入力ごとに異なる少数のパラメータ(エキスパート)を選択して処理を行うことで、計算量を抑えつつモデル容量を拡大するアーキテクチャ。
- SFT (Supervised Fine-Tuning): 教師あり微調整。人間または高品質なモデルが作成した入出力ペアを用いてモデルを学習させるプロセス。