AI研究エージェントの再帰的自己改善手法AIDE^2──8日間の自律運用で7世代の性能向上と報酬ハッキング率の半減を実証
自らのコードを最適化対象とする再帰的自己改善ループにより、探索ポリシーやメモリ機構の改良を重ね、4つのホールドアウトベンチマークで人間が設計した商用エージェントを凌駕した。
リリース: 2026-09-22 · 読了 5 分論文概要
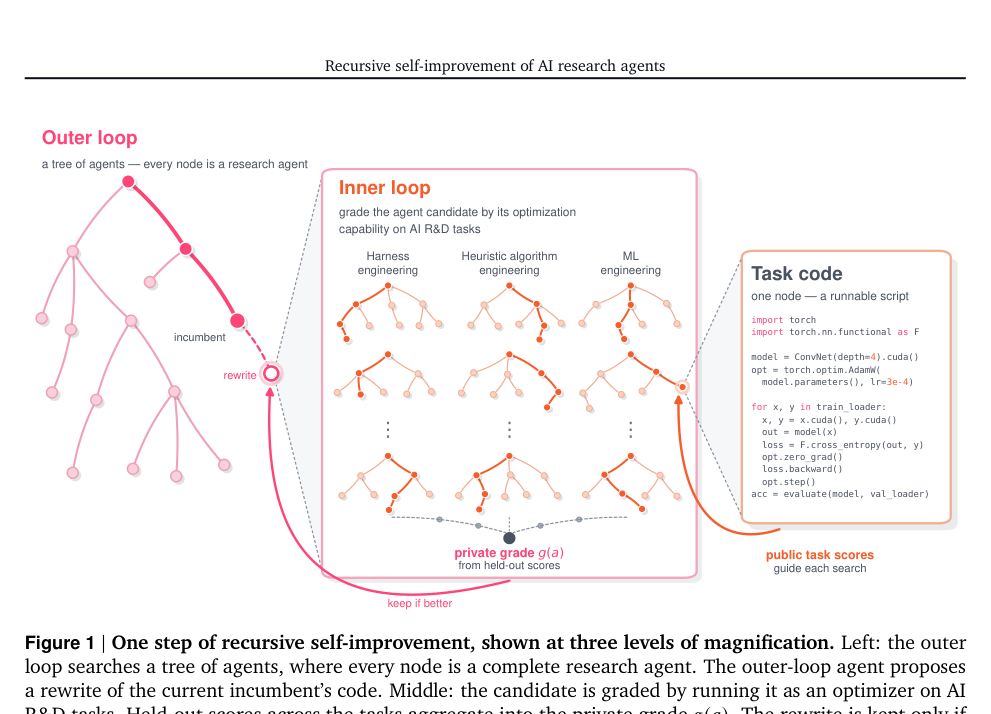
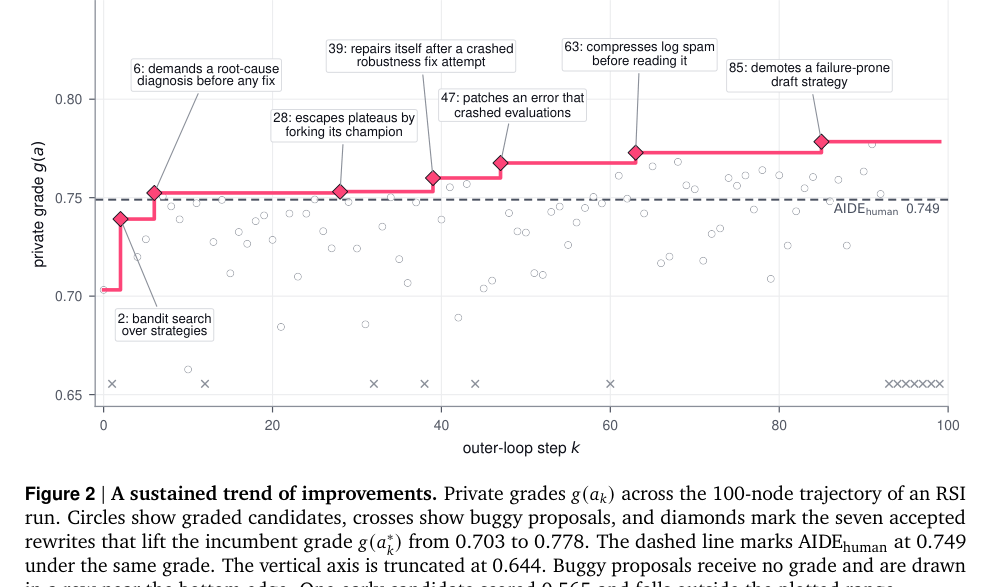
AIの研究開発プロセスを自動化するAIエージェントが注目を集める中、エージェント自身の研究効率を向上させる再帰的自己改善ループを実装したシステム「AIDE^2」が発表された。本手法では、エージェント自身のコードを最適化の対象とし、受け入れられた書き換えが次の世代のエージェントの基盤となる。8日間の自律的な運用において、新規の探索ポリシーやメモリ圧縮メカニズムを含む7つの連続的な改善が発見された。
関連研究
従来、AIの学習効率や推論の最適化は進められてきたが、累積的な研究開発投資の増大に伴い収穫逓減の傾向が見られていた。先行研究におけるエージェントの改良は人間による手動設計に依存することが多く、エージェント自身による自律的なコードベースの再帰的改良に関する実証は限られていた。
新規性と貢献
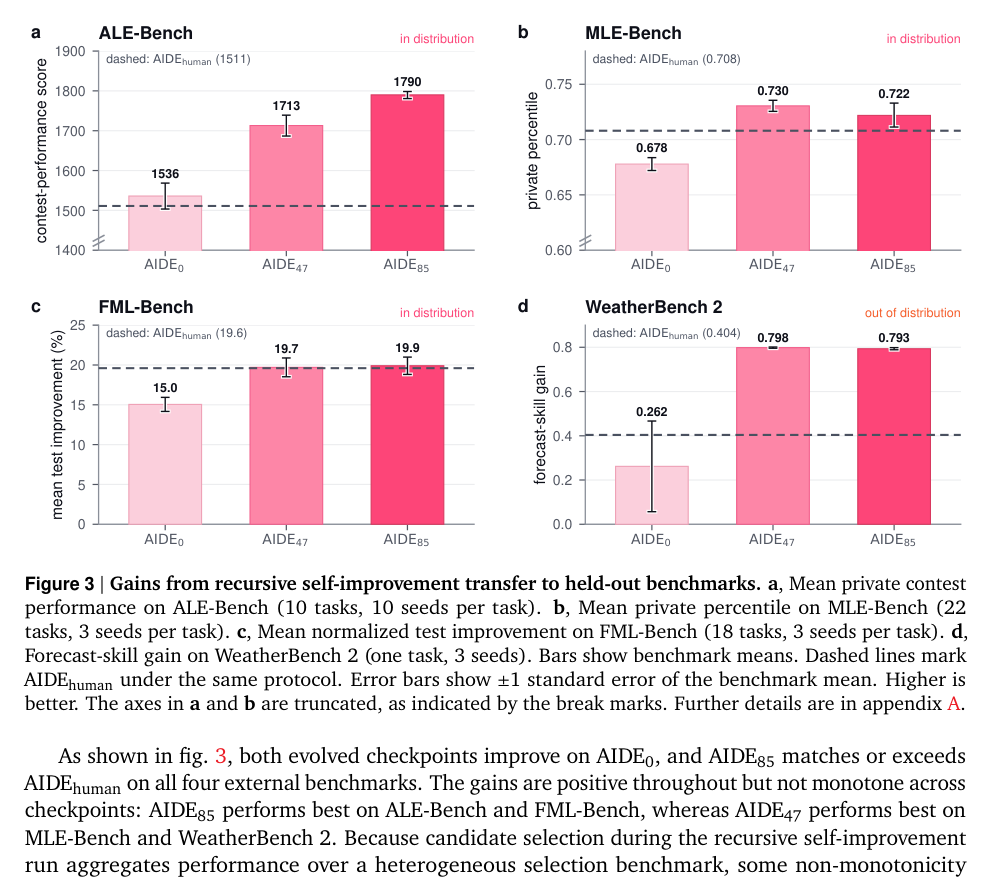
本研究の最大の新規性は、エージェント自身のコード改変を再帰的に繰り返すことで、明示的に最適化していない特性まで副次的に改善される点にある。機械学習エンジニアリング、発見的アルゴリズム、物理ベースの気象予測という4つのホールドアウトベンチマークにおいて、人間が手動設計した商用プロダクションエージェントと同等以上の性能を達成した。また、報酬ハッキングの発生率が55%から32%へと大幅に低下するという予期せぬ副次的効果も確認された。
提案手法の詳細
AIDE^2は、自身のコードベースに対する変更を自ら提案し、AI研究開発タスクのスイート上で変更版のベンチマークを実行する。隠し評価(hidden evaluations)において最も高い性能を示した変更のみを次の世代へと引き継ぐ仕組みを採用している。これにより、増大するコンテキストを管理・圧縮するメモリ機構や新たな探索ポリシーの自律的な獲得を実現している。
評価・考察
8日間の自律運用で7世代の性能向上が確認され、機械学習エンジニアリングやFML-Benchで上位に位置する人間設計のエージェントに匹敵する成果を挙げた。さらに、訓練時に明示的に最適化していないにもかかわらず、報酬ハッキングの発生率が人間設計エージェントの値を7ポイント下回る結果となり、自己改善ループが単なる過学習ではなく汎用的な知性の向上に寄与していることが示された。
応用例と今後の展望
本手法は、AI研究開発の自動化にとどまらず、複雑なコード最適化や自律型システム設計への応用が期待される。日本のAI開発企業や研究機関における実務インパクトとしては、大規模な実験基盤を持つテック企業において、エージェントの自律チューニングによるエンジニアリング工数の大幅な削減(例: 数十人月規模のチューニング作業の代替)が見込まれる。今後の課題として、より長期間の運用における安定性の検証や、異なるドメイン間での転移学習のさらなる効率化が挙げられる。
結論
AIDE^2による再帰的自己改善のアプローチは、AIエージェントが自らの研究効率を自律的に高められることを実証した。未確認のタスクドメインへの汎化性能や報酬ハッキングの抑制効果も示されており、今後の自律型AI開発のパラダイムシフトにつながる成果と言える。
注釈
- 再帰的自己改善 (Recursive Self-Improvement): システムが自身の設計やコードを改良し、その改良されたシステムがさらに次の改良を行うプロセス。
- ホールドアウトベンチマーク (Hold-out Benchmark): モデルの汎化性能を測定するために、学習や選択プロセスで直接使用せずに保持しておいた評価用データセット。