Tencent Hunyuan Team、総パラメータ数 80B で推論時活性化 13B の MoE 言語モデル Hunyuan-A13B を公開
20T トークンでの事前学習とデュアルモード CoT により、大規模モデルに匹敵する推論能力と高いスループットを両立させたオープンソース LLM。
リリース: 2026-09-23 · 読了 5 分論文概要
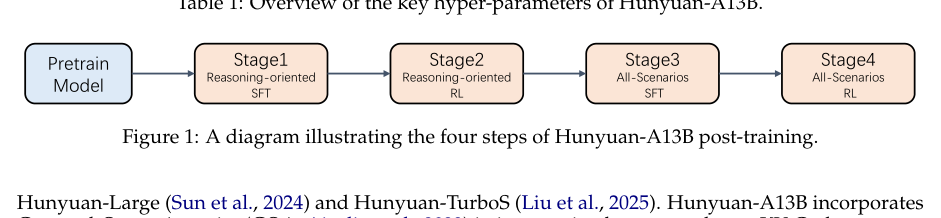
Tencent Hunyuan Team が公開した「Hunar-A13B」は、総パラメータ数 80B、推論時活性化パラメータ数 13B を採用した Mixture-of-Experts (MoE) 構造のオープンソース大規模言語モデルである。20T トークンにおよぶ厳格にフィルタリングされたコーパス(STEM データの強化を含む)を用いて事前学習が行われており、その後高品質な教師あり微調整 (SFT) と大規模な強化学習 (RL) を経て構築されている。数学、科学、プログラミング、一般言語理解、エージェントタスクにおいて、より大規模なモデルに匹敵する性能を発揮する。
関連研究
従来のオープンソース LLM において、推論コストの削減と性能の維持は長年の課題であった。高密度モデル(Dense Model)や標準的な MoE モデルでは、パラメータ規模の拡大に伴い推論時のメモリ帯域やスループットがボトルネックとなる傾向があった。本研究は、総パラメータ数 80B に対し活性化パラメータを 13B に絞り込むことで、デプロイコストを抑えつつ高いモデル能力を維持するアプローチをとる。
新規性と貢献
最大の新規性は、総パラメータ数を大きく取りながら推論時の活性化数を抑えた効率的な MoE 構造と、タスクの複雑さに応じて推論深度を適応させる「デュアルモード Chain-of-Thought (CoT) フレームワーク」の統合にある。事前学習段階での 20T トークン(STEM 特化データのキュレーション含む)の投入により、事実の信頼性と推論能力の底上げが図られている点が学術的・実用的な貢献である。
提案手法の詳細
Hunar-A13B の設計における核心は、MoE アーキテクチャによるパラメータ効率化と、新しく導入されたデュアルモード CoT フレームワークにある。日常的なクエリに対しては「ファスト・シンキング(高速処理)」を適用し、複雑な多段階の問題に対しては「スロー・シンキング(深層推論)」へと切り替えることで、レイテンシと精度のトレードオフを動的に最適化している。これにより、レイテンシに敏感なアプリケーション環境でも実用的なスループットを維持する設計となっている。
評価・考察
数学、プログラミング、科学などのベンチマーク評価において、Hunar-A13B は既存の同等サイズモデルを凌駕し、より大規模なモデルに迫るスコアを記録している。特に、推論時のスループットの高さと複雑なクエリにおけるデュアルモード CoT の連動により、実運用における応答速度と精度の両面で優位性が確認されている。
応用例と今後の展望
実務インパクトとして、国内の金融機関や製造業におけるオンプレミス環境での高度な自然言語処理システムの構築が挙げられる。特に、数理的推論やプログラミング補助を必要とする開発支援ツールや、高いスループットが求められるカスタマーサポートのエージェントシステムにおいて、総パラメータ数 80B 規模の性能を 13B 相当の推論コストで運用できる点は、ハードウェア投資コストの抑制において極めて実用的である。今後は、より多様なマルチモーダルタスクへの拡張や、エッジデバイス向けへのさらなる最適化が課題となる。
結論
Hunar-A13B は、80B/13B の MoE 構造、20T トークンの高品質な事前学習データ、およびデュアルモード CoT を組み合わせることで、オープンソース LLM のコストパフォーマンスと推論能力の水準を引き上げることに成功した。
注釈
- Mixture-of-Experts (MoE): 入力トークンに応じてモデルの一部(エキスパート)のみを動的に活性化させることで、総パラメータ数を増やしながら計算コストを抑えるアーキテクチャ。
- Chain-of-Thought (CoT): 言語モデルに段階的な思考プロセスを出力させることで、複雑な推論タスクの精度を向上させる手法。