LLM のハルシネーション検出・訂正に向けた幾何学的不確実性評価フレームワーク
回答埋め込み空間上でプロンプト条件付きセマンティック分布を幾何学的にモデル化し、医療データセット等で従来手法を上回るハルシネーション検出・訂正性能を実証。
リリース: 2025-09-17 · 読了 5 分論文概要
大規模言語モデル (LLM) の出力におけるハルシネーション(もっともらしい嘘の生成)を検出し、訂正するための新しい幾何学的フレームワークが提案された。本手法はブラックボックスかつサンプリングベースであり、プロンプトごとに複数の回答を生成した上で、回答埋め込み空間におけるプロンプト条件付きセマンティック分布を明示的にモデル化する。ショートフォームの質問応答データセットおよび、ハルシネーションのリスクが特にクリティカルな医療データセットを用いた実験において、従来手法と同等以上の性能を達成している。
関連研究
従来、LLM の不確実性定量化(Uncertainty Quantification)はハルシネーションを検知するアプローチとして広く提案されてきた。しかし、既存の手法にはプロンプトレベルと回答(アンサー)レベルの双方における信頼性を統一的な枠組みで評価する基盤が不足していた。本研究は、埋め込み空間での幾何学的分布を捉えることで、このギャップを埋めることを目的としている。
新規性と貢献
本研究の最大の新規性は、プロンプトレベルと個別回答レベルの不確実性を統合的に評価する幾何学的フレームワークの導入にある。アーキテパル分析(Archetypal Analysis)を用いて回答分布の幾何学的サポートを推定し、プロンプトレベルでは分布のエントロピーを近似、個別回答レベルではバッチ内での非典型性(Atypicality)を評価する。これにより、ハルシネーションの検出だけでなく、最も信頼性の高い回答の選択による自動訂正までを単一のフレームワークで実現した。
提案手法の詳細
提案手法は完全にブラックボックスとして動作し、内部のモデル重みにアクセスする必要がない。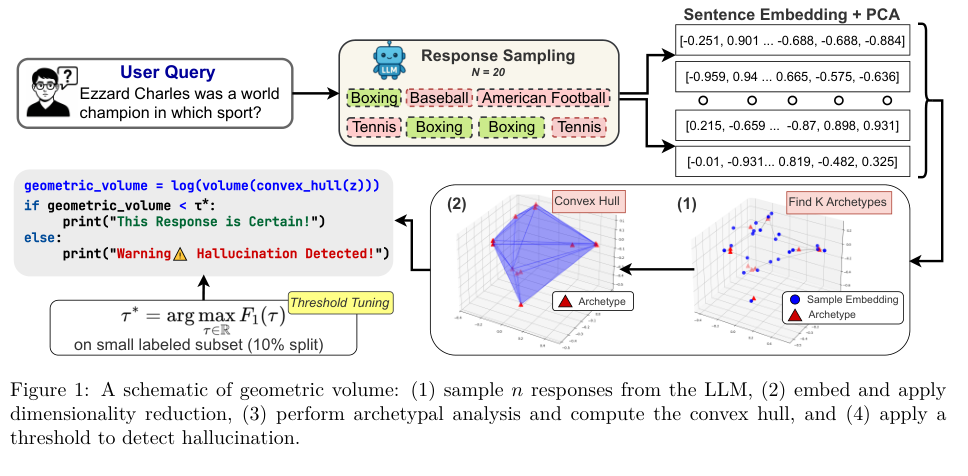 プロンプトからサンプリングされた複数の回答埋め込みに対し、幾何学的な広がりや分布の偏りを計算することで、モデルがどの程度その出力を確信しているかを定量化する。
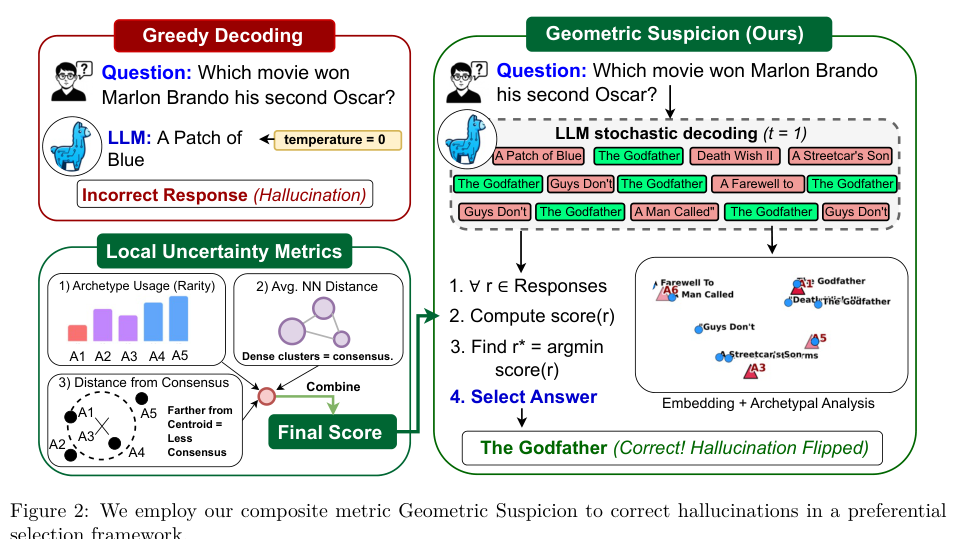 なぜこの設計にしたかといえば、テキストの表層的な確率だけでなく、意味空間上のクラスタリングや幾何学的体積を直接測る方が、セマンティックな意味での「迷い」を正確に捉えられるという直感に基づいている。
評価・考察
評価実験では、一般的なショートフォーム質問応答データセットに加え、誤情報のリスクが致命的となる医療ドメインのデータセットが使用された。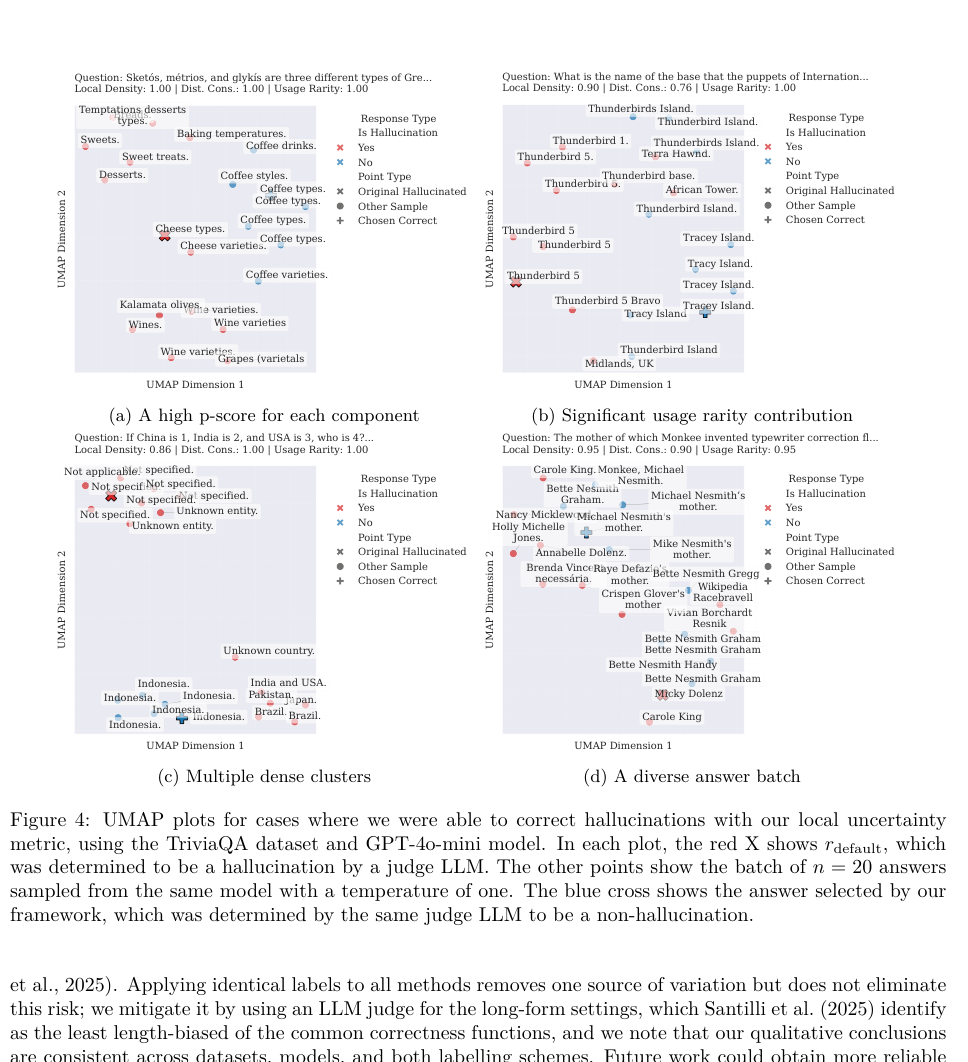 結果として、ベースラインとなる従来手法と比較して同等以上の精度を維持しつつ、特にリスクの高い医療データセットにおいて優れた検出・訂正性能を発揮することが示された。理論的な裏付けとしても、セマンティック分布が LLM の不確実性研究における有用なオブジェクトであることが示唆されている。
応用例と今後の展望
医療分野や金融分野など、ハルシネーションが重大な実害を及ぼすドメインでの大規模言語モデル実運用において、ブラックボックス性を保ったまま安全性を高めるガードレールとして直ちに適用可能である。国内の医療情報システムや製薬・臨床研究の現場における AI アシスタント開発において、モデルのブラックボックス性を維持したまま出力の信頼性を担保する実務インパクトを持つ。今後の課題としては、多重サンプリングに伴う推論コストの増大に対する最適化などが挙げられる。
結論
本論文は、LLM の埋め込み空間におけるセマンティック分布を幾何学的にモデル化することで、プロンプトおよび回答レベルの不確実性を統一的に評価する手法を確立した。医療分野をはじめとする高リスク領域でのハルシネーション対策として強力なアプローチを提供している。
注釈
- ハルシネーション: 大規模言語モデルが事実とは異なる、あるいは文脈に合致しない不正確な情報を自信を持って生成する現象。
- アーキテパル分析: データ空間の境界(極限パターン)を特定し、データを少数の典型例の組合せとして表現する多変量解析手法。