LLM の不確実性を軽量蒸留する Semantic Self-Distillation──サンプリング不要でハルシネーションを予測
大規模言語モデルのセマンティック分布を軽量な学生モデルに蒸留し、サンプリングを伴わずにプロンプトレベルの不確実性と回答の信頼性を高効率に評価する手法を提案する。
リリース: 2026-02-04 · 読了 5 分論文概要
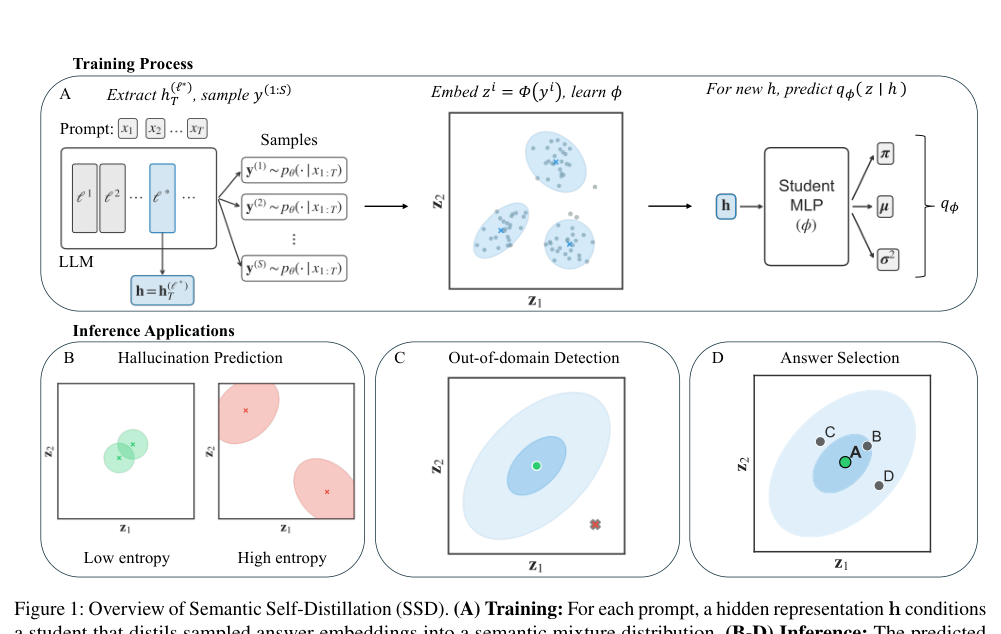
大規模言語モデル(LLM)における不確実性の定量化は、モデルの複雑さと出力の多様性から困難が伴う。従来は複数サンプリングの意味的分散(Semantic dispersion)を用いる手法が提案されていたが、計算コストが高くレイテンシがシビアなアプリケーションへの適用は困難であった。本論文では、サンプリングされたセマンティック分布を軽量な学生モデルに蒸留する「Semantic Self-Distillation (SSD)」を提案する。SSDはトークン生成前にプロンプト条件付きの密度を推定し、ハルシネーション予測やドメイン外(OOD)検出において教員モデルと同等の性能を維持しつつ、高効率な不確実性評価を実現している。
関連研究
LLMの不確実性評価においては、複数の出力をサンプリングしてその意味的な揺らぎを測定するアプローチが一般的である。しかし、これらは推論時のフォワードパスの増加を招き、実時間システムでのボトルネックとなっていた。本研究は、事前計算やサンプリングの繰り返しを回避するため、予測される分布そのものを軽量な学生モデルへ直接蒸留する点が先行研究と異なる。
新規性と貢献
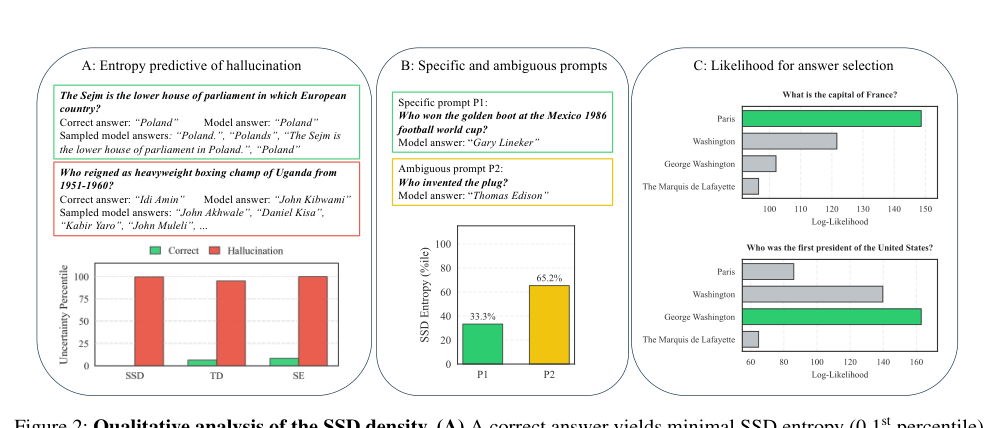
最大の新規性は、教師モデルの持つ複雑なセマンティック分布を軽量な学生モデルへ「自己蒸留」し、生成トークンに依存せずプロンプトの段階で不確実性や信頼性を定量化できる点にある。TriviaQAやMMLUを用いた実験により、ハルシネーション予測タスクにおいて教員モデルのサンプリング手法と同等レベルの競争力を示しながら、OOD検出や選択式問題への適用など多様な不確実性プリミティブを提供できることが示された。
提案手法の詳細
提案手法である Semantic Self-Distillation (SSD) では、教師モデルから得られたサンプリング済みセマンティック分布を、事前に入力プロンプトから直接予測する学生モデルを学習させる。学生モデルは考えられる回答に対するセマンティック分布を出力し、その分布の「エントロピー」がプロンプトレベルの不確実性シグナルとして機能する。また、確率密度によって回答レベルの信頼性評価も可能となる。
評価・考察
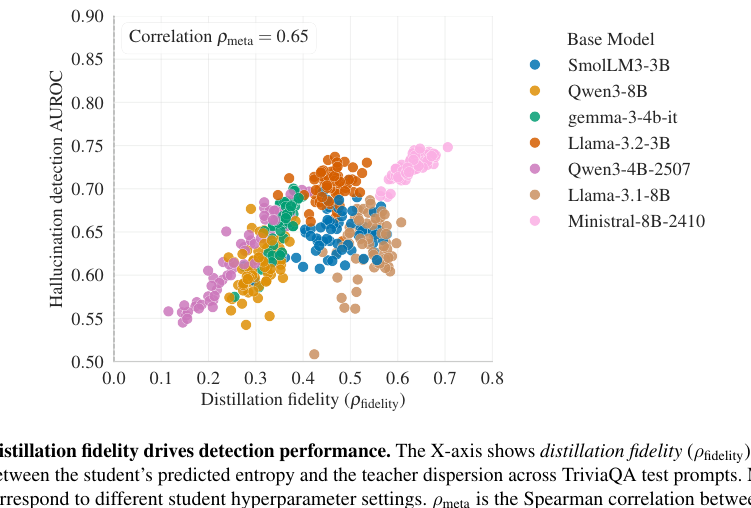
TriviaQAおよびMMLUのベンチマークを用いた検証において、SSDを用いた学生モデルはハルシネーション予測タスクにおいて、教師モデルが持つサンプリングベースのセマンティック分散と同等の性能を発揮した。また、蒸留の忠実度がハルシネーション検出のAUROC性能に直接影響を与えることがグラフによって示されている。
応用例と今後の展望
本手法は、レイテンシが厳しく制限される金融や医療などのリアルタイムチャットボット・自動応答システムにおいて、生成前のリスク検知やハルシネーション防止策としての実務インパクトを持つ。特に数千リクエスト/秒を処理する大規模システムや、医療・法務分野のエンタープライズAI運用において、サンプリング処理を省略しつつ信頼性を担保する基盤技術として期待される。今後の課題としては、言語以外の複雑な出力空間への拡張検証が挙げられる。
結論
本論文では、LLMの出力における不確実性評価の計算コスト問題を解決するため、Semantic Self-Distillation (SSD) を提案した。軽量な学生モデルによるセマンティック分布の直接予測により、サンプリングを伴わずにハルシネーション予測やOOD検出を高効率で実行可能であることを実証した。
注釈
- Semantic dispersion: 生成された複数の出力回答の間における、意味的な内容のばらつきや多様性のこと。
- OOD検出 (Out-of-Domain Detection): モデルが学習時に想定していない未知の入力やデータ分布を検知する技術。