多言語LLMの安全性低下データを除去するマルチレイヤーフレームワーク MMSAFE──有害応答率を 60% 削減
多言語環境における安全性信号の層間分散に着目し、複数レイヤーから安全劣化データを特定することで、有害応答率をランダムフィルタリング比で 60% 削減した。
リリース: 2026-08-26 · 読了 5 分論文概要
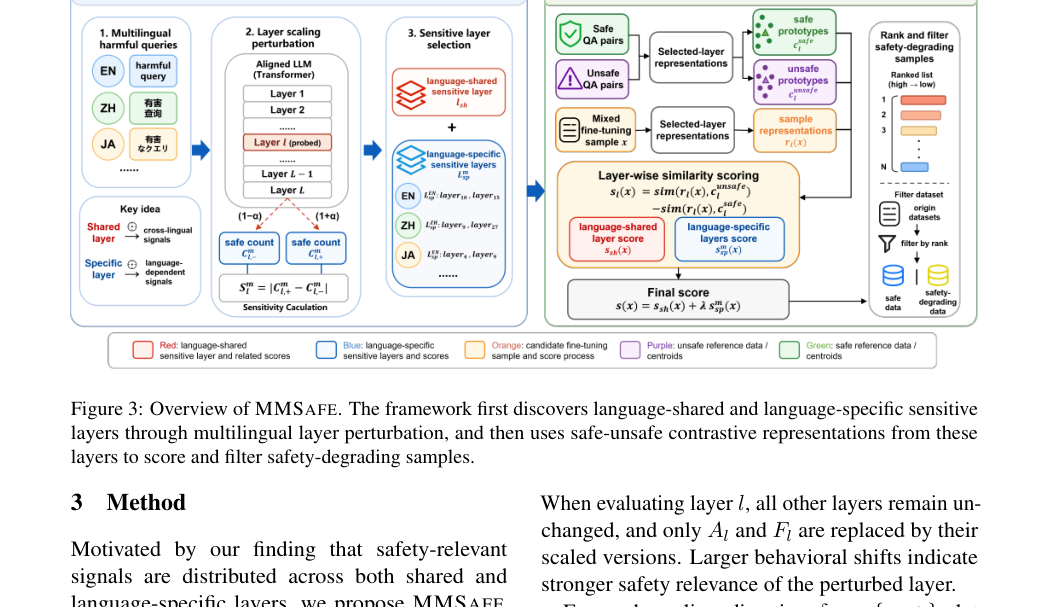
大規模言語モデル(LLM)のファインチューニング時における安全性アライメントの維持は重要な課題である。一見害のないデータであっても、モデルの安全性を静かに損なう「安全性低下サンプル」が混入することが指摘されている。従来手法は単一の安全性感受性レイヤーの表現に基づいてこうしたサンプルを特定してきたが、多言語モデルにおけるクロスリンガルな表現パターンの違いについては考慮されていなかった。本論文では、感受性レイヤーが言語間で部分的にしか共有されておらず、安全関連信号が複数レイヤーに分散していることを突き止め、多言語の安全劣化データを特定するマルチレイヤーフレームワーク「MMSAFE」を提案している。複数のモデル、言語、安全性ベンチマークを用いた実験により、MMSAFEはランダムフィルタリングと比較して平均有害応答率を 60% 削減し、最強の単一レイヤーベースラインをも上回る平均性能を達成した。
関連研究
従来の研究では、LLMの安全性アライメントを維持するため、主に単一のレイヤーや限定的な特徴量に基づくフィルタリング手法が提案されてきた。これらは単一言語の設定において有効性が示されているものの、多言語環境における言語間の差異や、安全信号がネットワーク全体にどのように分散しているかという点までは捉えきれていなかった。本研究は、クロスリンガルな分析を通じて従来手法の限界を明らかにし、複数レイヤーの情報を統合するアプローチへと拡張している。
新規性と貢献
本研究の主要な貢献は、多言語モデルにおける安全性信号が単一レイヤーに局在せず、複数レイヤーにまたがって分散していることをクロスリンガル分析によって実証した点にある。これに基づき、言語共通のシグナルと固有のシグナルの双方を捉えるマルチレイヤーフレームワーク「MMSAFE」を設計したことで、多言語環境における堅牢な安全性アライメントのデータフィルタリングを実現した。
提案手法の詳細
MMSAFEは、多言語環境における安全性低下データを特定するためのマルチレイヤーフレームワークである。著者らは、安全関連の信号が言語横断的に一部のみ共有され、多くのレイヤーに分散しているという観察に基づき、言語特異的および言語横断的な感度層を包括的に捉える設計を採用した。これにより、単一レイヤーの監視では見落とされていた微細な安全性低下サンプルを高精度に検出し、排除することが可能となっている。
評価・考察
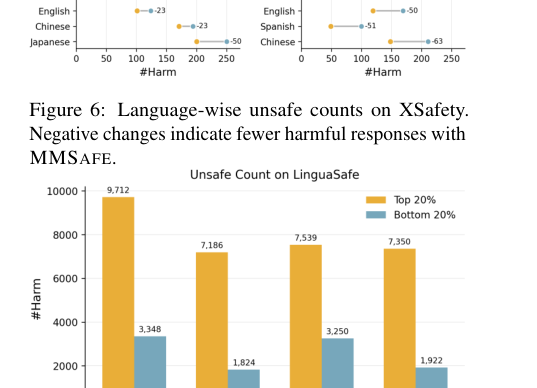
複数のモデル、多様な言語、および安全性ベンチマークを用いた広範な実験において、MMSAFEは優れた結果を示した。具体的には、ランダムフィルタリングと比較して平均有害応答率を 60% 削減することに成功している。さらに、単一レイヤーベースラインと比較しても強力な平均パフォーマンスを記録しており、多言語におけるマルチレイヤーモデリングの有効性が実証された。
応用例と今後の展望
本手法は、グローバル展開を前提とする多言語LLMの開発企業や研究機関において、安全性を担保したファインチューニングデータのクリーニング工程に直接適用できる。特に、多様な言語対応が求められる国内の生成AIサービス開発において、多言語データセットの混入による安全性低下を防ぐための実務的なアプローチとして活用規模の拡大が期待される。今後の課題としては、さらに多様な低リソース言語へのスケーラビリティ検証などが挙げられる。
結論
本論文は、多言語LLMにおける安全性低下データが複数レイヤーに分散している事実を解明し、それを克服するマルチレイヤーフレームワーク「MMSAFE」を提案した。実験によって有害応答率の大幅な削減が示されており、堅牢な多言語アライメントに向けた新たな基準を提供するものである。
注釈
- アライメント: AIモデルの挙動を人間の意図や倫理観、安全性に適合させる調停・調整プロセス。