長期文脈広告エージェントの学習における SFT と RL の最適配分手法──非一律適用で 7 スキル平均デルタを +3.57 に向上
SFT と強化学習を無分別に適用するのではなく、教師データの信頼性と報酬観測性に基づいて適応的に配分し、計算コストを 43% 削減しつつ性能を向上させた。
リリース: 2026-08-29 · 読了 5 分論文概要
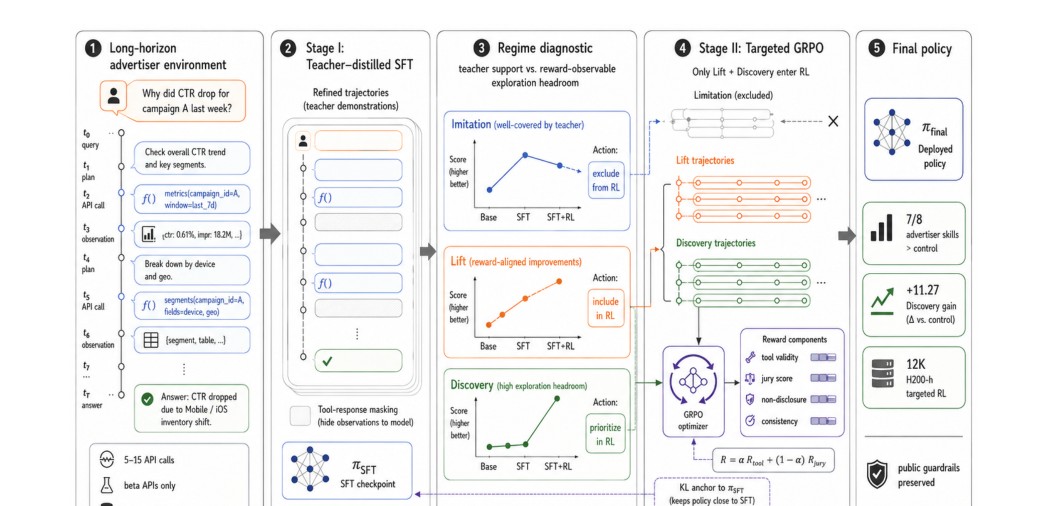
本論文では、分散ビジネスデータ上の長期文脈ツール使用問題を解決するエンタープライズ分析エージェントにおいて、Supervised Fine-Tuning(SFT)と Reinforcement Learning(RL)のバランスをどのように取るべきかを検証している。従来の一律適用手法では、すでに較正されたスキルが外乱を受けるという問題があった。著者らは、教師データの信頼性と報酬観測性に基づくターゲティング型ポストトレーニングパイプラインを提案し、GPT-OSS 120B を用いた実験で 7 つの広告主スキルの平均デルタを +3.57 に向上させつつ、追加の RL 計算コストを 43% 削減した。
関連研究
エージェントの能力向上において、SFT はツール構文や教師のサポートに基づく挙動の較正に有効であり、RL はデモンストレーションの範囲外にある報酬支持型の挙動を探索するために用いられてきた。しかし、両者を均等に適用することの弊害や、どのフェーズでどちらの手法を適用すべきかという系統的な切り分けについての検証はこれまで不十分であった。
新規性と貢献
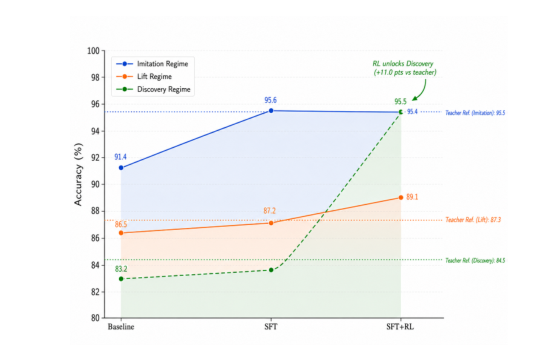
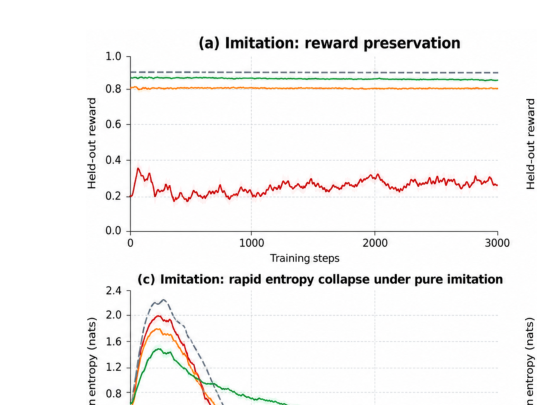
本研究の主要な貢献は、チェックポイントの軌跡を「Imitation」「Lift」「Discovery」の 3 つのレジメに分類した点にある。これにより、どの機能に対して SFT のみを適用し、どの機能に SFT と RL の両方を適用すべきかを予測する診断手法を構築した。18 の特徴量固有の実験のうち 15 で軌跡の予測に成功しており、実務上のポストトレーニング戦略の設計指針を提供する。
提案手法の詳細
提案手法では、教師データのサポート範囲と報酬観測可能なヘッドルームを評価し、機能ごとに「SFT のみ」「SFT のちに RL」「RL 割り当ての増加」「環境のさらなる開発」へとルーティングする。これにより、すでに正常に動作しているスキルへの無駄な RL による劣化を防ぎ、探索が必要な領域にリソースを集中させる設計となっている。
評価・考察
GPT-OSS 120B を用いた検証において、ターゲティング型 SFT + RL はフロンティアの Control と比較して 8 つの広告主スキルのうち 7 つで正のポイント推定値を記録した。5 つの利得は 95% 信頼区間に 0 を含まず、最大の利得は非開示項目における +11.27 ポイント(95% CI [+9.72, +12.82])であった。また、SFT と比較して標準的な情報漏洩を 11.8% から 2.9% に、敵対的情報漏洩を 22.9% から 6.8% に削減しつつ、アクション性を維持(86.2% から 85.7%)できることが SME(Subject Matter Expert)監査によって確認された。
応用例と今後の展望
本手法は、アドテク分野や複雑な API 呼び出し・データ取得を伴うエンタープライズ向けエージェント開発に直接適用可能である。日本の広告運用システムやマーケティング自動化プラットフォームの分野において、開発チームが大規模言語モデルのポストトレーニングコストを最適化しつつ安全性を高めるための実務的な設計図となる。今後はより多様なビジネスドメインへの拡張が期待される。
結論
長期文脈ツール使用エージェントの学習において、SFT と RL を一律に適用するのではなく、レジメに応じたターゲティング適用を行うことで、計算コストを抑えながら精度と安全性を大幅に向上させることが可能である。
注釈
- Supervised Fine-Tuning(SFT): 教師データを用いてモデルの出力を直接学習させる手法。
- Reinforcement Learning(RL): 試行錯誤を通じて得られる報酬を最大化するようにモデルを最適化する手法。
- SME: Subject Matter Expert(各分野の専門家)。