長文脈 LLM のコンテキスト汚染を解明──注意機構の極値干渉と必要マージンを数式で導出
長文脈 LLM における注意機構の極値干渉を定式化し、精度維持には証拠マージンが有効妨害数 N に対して $\Omega(\sqrt{\log N})$ でスケーリングする必要があることを有限標本上界として導出した。
リリース: 2026-08-12 · 読了 5 分論文概要
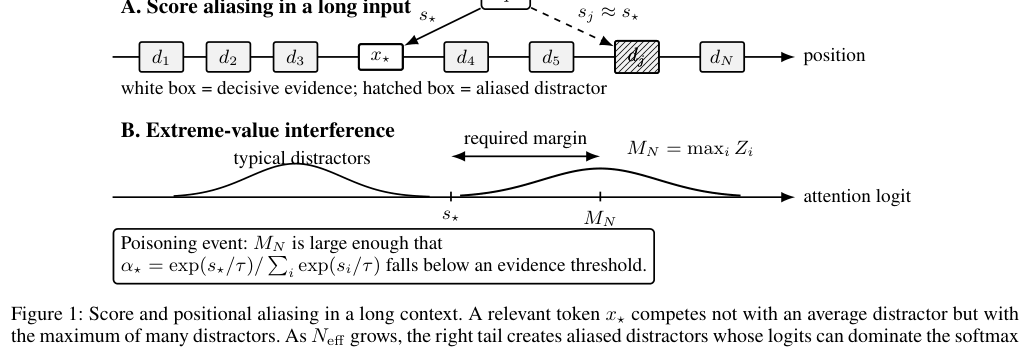
Large Language Models (LLM) のコンテキスト長が拡張される一方で、無関係な情報や紛らわしい文脈が追加された際に重要な証拠を発見・利用する能力が劣化する現象を、本論文では「コンテキスト汚染 (context poisoning)」と定義し、注意機構における極値干渉 (extreme-value interference) として理論的に分析している。著者らは、決定的な証拠のスコアが上限を持つ一方で、有効な妨害要素の最大スコアがその数に応じて増加することを示し、softmax 検索抽象化の下で有限標本上界を導出した。
関連研究
先行研究では長文脈処理におけるモデルの性能低下が多数報告されてきたが、その多くは経験的な評価にとどまっていた。本研究は、注意機構のスコア飽和やエイリアシングの観点から理論的な上界を導出した点で、これまでの実験的アプローチとは一線を画す。
新規性と貢献
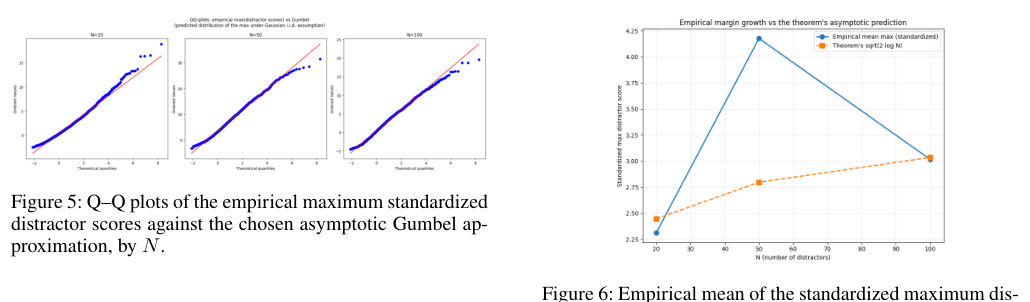
本研究の最大の新規性は、コンテキスト汚染を「極値干渉」として数理的に定式化した点にある。ベースライン以上の精度を維持するために必要な証拠マージンが、文脈の総長ではなく実効的な妨害要素の数 に対して でスケールしなければならないことを示したことは、今後の長文脈アーキテクチャの設計において重要な指針を与える。
提案手法の詳細
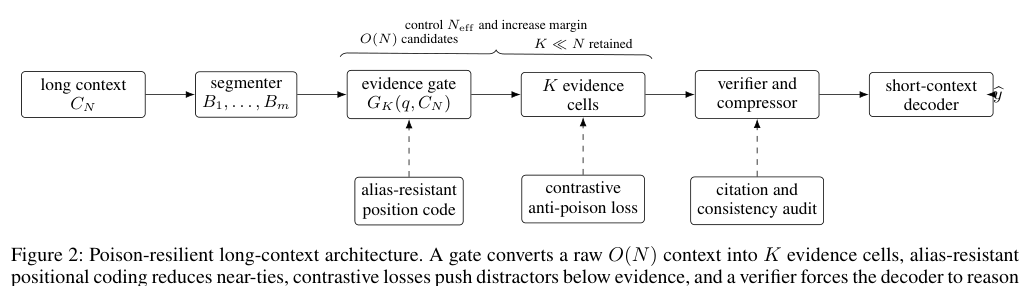
分析の結果、長文脈の劣化はスコア・エイリアシング、位置的エイリアシング、softmax 希釈に起因することが示されている。これに対処するため、著者らは証拠のボトルネック化、エイリアス耐性を持つ表現、検索・推論分離型(retrieve-then-reason)アーキテクチャ、検証者媒介型メモリ、および対照的アンチ・ポイズン学習の導入を動機づける。
評価・考察
制御された実験により、埋め込まれたハードネガティブが存在する場合、全コンテキストの成長に伴って検索精度が低下することが確認された。また、固定されたコンテキスト長において、同フォーマット条件の妨害構築が最も大きな精度低下を引き起こすことが示されている。検索ゲーティングは証拠の利用を改善しうるが、その正味の利益は証拠の再現率(recall)の維持に依存するというトレードオフが明らかにされた。
応用例と今後の展望
本研究の知見は、長大なコードベースの解析や数万トークンにおよぶ医療カルテの横断検索を行うシステム開発において、単にコンテキスト窓を広げるだけでは検索精度が担保されないという実務上の設計指針を提供する。特に国内の金融・法務分野におけるドキュメント検索システム開発において、ハルシネーションや情報迷子の原因を理論的に検証する際の基盤となる。今後の課題としては、提案されたアーキテクチャの具体的な実装と大規模モデルにおける検証が挙げられる。
結論
本論文は、長文脈 LLM におけるコンテキスト汚染を注意機構の極値干渉として数理モデル化し、必要となる証拠マージンのスケーリング則を導出した。長文脈処理における根本的な限界と、それを突破するためのアーキテクチャ上の方向性を明確にした点で意義深い。
注釈
- Softmax 希釈: 注意機構において、トークン数が増加することで softmax の分母が大きくなり、特定の重要トークンへの重みが相対的に薄まる現象。