MoE のルーティングとアテンションを結合する Attention-Aware Routing──GSM8K で +3.37 pp 向上
隠れ状態に依存していた MoE のルーターにアテンション重みの時系列・スペクトル特徴を統合し、ベースモデルを凍結したまま数学的推論精度を向上させた。
リリース: 2026-09-17 · 読了 4 分論文概要
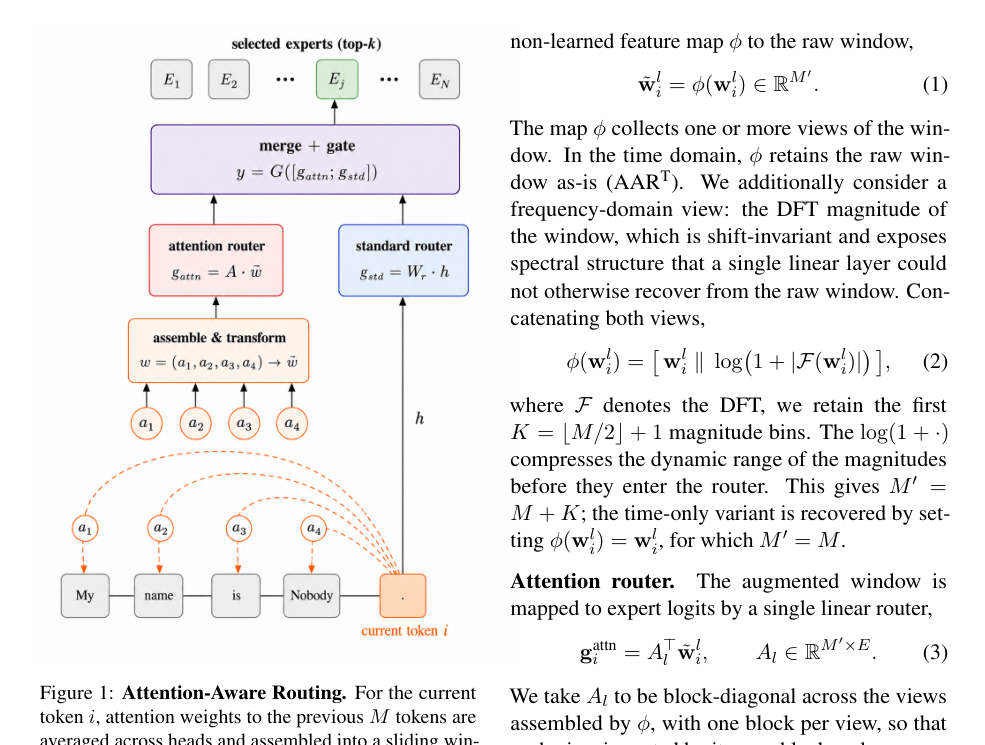
Mixture-of-Experts (MoE) 言語モデルにおいて、従来のルーターはトークンの隠れ状態のみに基づいて限定的なコンテキスト情報から専門家 (Expert) を選択・重み付けしていた。本論文では、モデルの文脈状態の要約であるアテンション重みのスライディングウィンドウから抽出した時系列・スペクトル特徴をルーターに拡張する手法「Attention-Aware Routing (AAR)」を提案する。ベースとなる Transformer の重みを完全に凍結したままルーティングパラメータのみを学習させることで、OLMoE において GSM8K ベンチマークの精度をルーティングのみの SFT ベースラインと比較して +3.37 pp 向上させた。
関連研究
これまでの MoE モデルのルーティング改善手法は、主にトークンの隠れ状態の表現力を高めることや、ロードバランシングの損失関数を調整することに主眼が置かれてきた。しかし、アテンション機構自体が持つ動的な文脈情報や長期的依存関係の構造をルーターの入力として直接活用する試みは十分に探索されていなかった。本研究は、アテンション重みを時系列・スペクトル解析を通じてルーターに結合する点で先行研究と一線を画している。
新規性と貢献
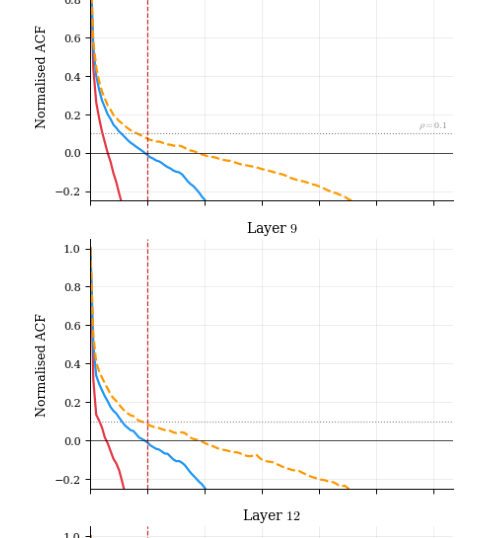
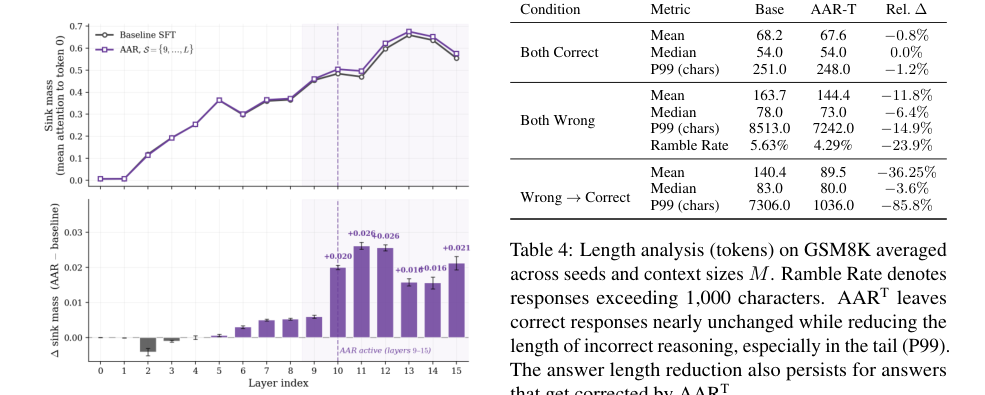
本研究の主要な学術的・実用的な貢献は、ルーティングとアテンション機構が「結合回路」を形成していることを実証した点にある。レイヤー におけるルーティングの変更は、残差ストリーム(residual stream)伝いに波及し、レイヤー のアテンション特異点を増幅させる。これにより、アテンション機構そのものを直接更新することなく、アテンションの挙動を再構築することが可能となる。
提案手法の詳細
AAR は、スライディングウィンドウ内のアテンション重みから時間的およびスペクトル的な特徴量を抽出し、これを従来の隠れ状態ベースのルーティング情報に結合する。なぜこの設計を採用したかというと、アテンション重みにはモデルが捉えている文脈の状態構造がダイレクトに反映されており、隠れ状態だけでは捉えきれないトークン間の動的な関係性をルーターに提供できるためである。
評価・考察
OLMoE を用いた実験において、AAR は GSM8K でベースライン比 +3.37 pp の精度向上を達成した。また、AAR は長い発散的生成(long diverging generation)を抑制し、誤った回答の長さを短くする一方で、正しい回答の長さは維持されることが確認された。さらに、AAR は層ごとの感度が強く、全層に一律に適用すると事実検索能力が低下する場合があることが示された。一方、ネットワークのより深い層に導入した場合は数学的推論の向上が持続する。この特性は、層によってアテンションが持つルーティング関連情報の性質が異なる「検索と推論のトレードオフ」を浮き彫りにしている。
応用例と今後の展望
金融分野や医療分野などの厳密な数学的推論・コード生成が求められるテキスト生成タスクにおいて、計算効率を落とさずに MoE の推論精度を引き上げる手法として実務上のインパクトが大きい。国内の金融テック企業や LLM 開発ベンダーにおいて、大規模な事前学習コストをかけずに数理推論能力をピンポイントで拡張する際の実装アプローチとして活用できる規模感にある。今後の課題としては、検索・推論のトレードオフを解消するための層選択的なハイパーパラメータの自動最適化が挙げられる。
結論
本論文は、MoE のルーティング機構と Transformer のアテンション重みを結合する AAR 手法を提案し、数学的推論能力の向上と生成の安定化を実証した。ベースモデルを凍結したまま効率的に精度を改善できる点で、今後の MoE アーキテクチャの設計に新たな指針を与えるものである。
注釈
- Mixture-of-Experts (MoE): 入力ごとに適切な少数のニューラルネットワーク(Expert)を選択して処理を行うことで、計算コストを抑えつつモデル容量を拡大する手法。
- GSM8K: 小学生レベルの多段階の文章題からなる数学的推論能力評価用ベンチマーク。