エンドツーエンドビジネスインテリジェンス自動化手法 BI-Agent──既存 LLM 比で精度を最大 40pt 向上
実世界データの BI ワークフローを自動化するベンチマーク BI-Bench とツール拡張エージェントを提案し、従来モデルで 50% 未満だった精度を大幅に改善した。
リリース: 2026-09-16 · 読了 5 分論文概要
ビジネスインテリジェンス(BI)ワークフローの自動化を目的とした新手法「BI-Agent」および新ベンチマーク「BI-Bench」を提案する論文である。従来の BI タスクでは、ユーザーが手動で関連テーブルの特定、データ変換、結合関係の構築を行う必要があった。本研究では、実際のパブリックな BI プロジェクトから収集した実世界データに基づき、エンドツーエンドの BI 質問応答能力を体系的に評価する BI-Bench を構築した。評価の結果、最先端のフロンティア LLM でも精度は 50% 未満と低いことが判明した。これに対処するため、構造化データのサブタスクを分解・実行するツール拡張型 BI-Agent と、事後学習フレームワークを開発し、既存手法と比較して最大 40 パーセントポイントの精度向上を実証した。
関連研究
従来の大規模言語モデルを用いたデータ分析やテキスト読み込み型 RAG は、単一のクエリや単純なテーブル抽出を前提としていることが多く、複数ステップにわたる複雑なデータ前処理やリレーショナル結合を含むエンドツーエンドの BI プロジェクト全体を対象とした評価・自動化は十分に行われていなかった。本研究は、実際のユーザーダッシュボードから導出された実データをベースラインとすることで、実務環境により近い形での評価を実現している。
新規性と貢献
本研究の主要な貢献は、エンドツーエンドの BI ワークフローに特化した初の体系的ベンチマークである BI-Bench の公開と、ツール拡張および事後学習(SFT・強化学習)を組み合わせた BI-Agent の提案にある。これにより、単体では困難であった複雑なデータ結合や変換を伴う分析タスクにおいて、大幅な精度向上の道筋を示した。
提案手法の詳細
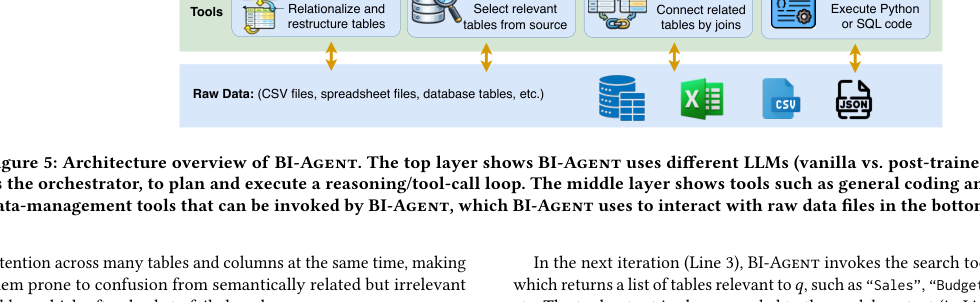
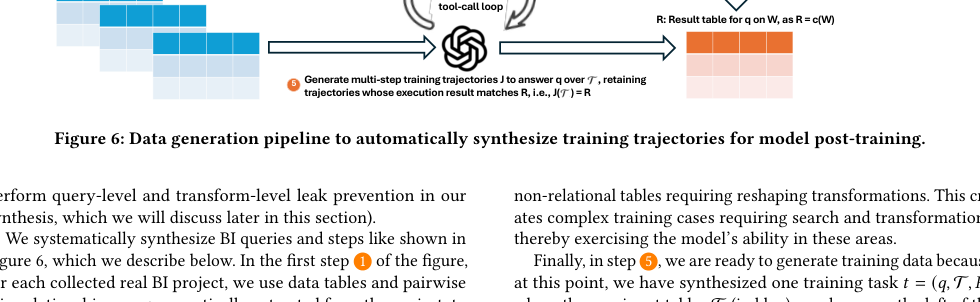
BI-Agent は、BI ワークフローを「検索」「結合」「変換」などの構造化データ上のサブタスクに分割し、それぞれの段階に応じた専門的なデータ管理手法をオーケストレーションする設計になっている。なぜこの設計にしたかといえば、LLM 単体にすべての処理を暗黙的に行わせるよりも、データ操作の各フェーズに特化したツールと推論プロセスを明示的に組み合わせる方が、構造化データの誤りを最小限に抑えられるという直感に基づいている。さらに、実際の BI プロジェクトからトレーニング軌跡を自動合成し、教師あり微調整(SFT)と強化学習(RL)の両方を用いてエージェントを事後学習させるフレームワークを備える。
評価・考察
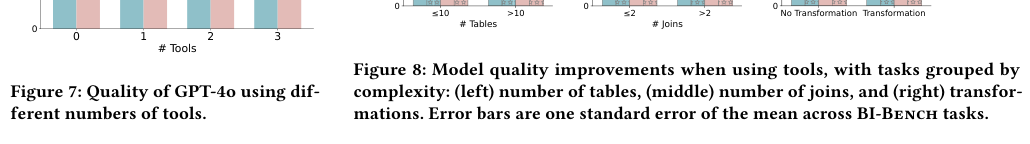
BI-Bench において、従来のバニラなフロンティア LLM は 50% 未満の精度にとどまった。しかし、提案する BI-Agent を導入することで、バニラ LLM と比較して最大 40 パーセントポイントの精度向上が達成された。また、提案された事後学習フレームワークを適用した BI-Agent でも、最大 30 パーセントポイントの利得が確認された。これらの結果は、ツール拡張型推論とドメイン特化型の事後学習を統合することが、複雑な BI ワークフローの性能担保において極めて重要であることを示している。
応用例と今後の展望
実務へのインパクトとして、国内の金融・小売り・製造業などのデータ分析部門やBIツール開発企業において、Power BIやTableauなどのツールと連携した自動レポート生成やダッシュボード構築の工数を大幅に削減できる可能性がある。今後の課題としては、より多様なデータソースや動的なスキーマ変動への対応、および実運用のデータ量におけるスケーラビリティの検証が挙げられる。
結論
本研究は、エンドツーエンドの BI タスク評価のための新ベンチマーク BI-Bench と、ツール拡張および事後学習を統合した BI-Agent を提案した。実験により、従来モデルの限界を大きく突破する精度向上が確認され、複雑なデータ処理を伴うエージェントシステムの新たな方向性を示している。
注釈
- Business Intelligence (BI): 企業の蓄積したデータを分析・活用して経営や意思決定を支援する手法やシステムの総称。
- SFT / RL: Supervised Fine-Tuning(教師あり微調整)と Reinforcement Learning(強化学習)の略称。