長文脈 LLM の Prefill を 20.65 倍に高速化する RBS-Attention──精度維持と効率を両立する二分岐スパース選択手法
KV キャッシュ等の事前処理における平均希釈問題に対し、半径適応型の二分岐選択によって精度劣化を抑えつつ H100 上で劇的な高速化を実証した。
リリース: 2026-09-17 · 読了 5 分論文概要
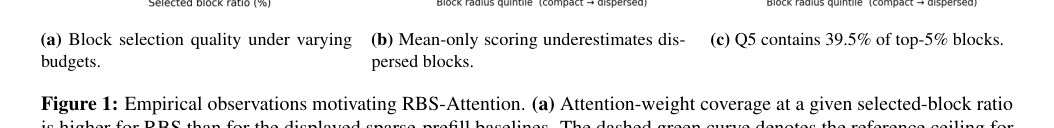
長文脈大規模言語モデル(LLM)の推論において、全プロンプトを処理するデンスアテンション(Dense Self-Attention)による Prefill(事前処理)フェーズがボトルネックとなっている。これに対し、スパースブロック選択手法を用いると計算コストを削減できるが、ブロック重心が多数の無関係なトークンの中に埋もれて重要なトークンを見落とす「平均希釈(Mean Dilution)」という失敗モードが存在する。本論文では、トレーニング不要のスパース Prefill 手法である「RBS-Attention」を提案し、H100 GPU を用いた 128K 長文脈の検証において、スタンドアロンの Prefill アテンションで 20.65 倍、vLLM の Prefill アテンションで 11.92 倍、エンドツーエンドの Time-to-First-Token(TTFT)で 5.97 倍の高速化を実証した。
関連研究
従来の長文脈 LLM 向け高速化手法としては、KV キャッシュの圧縮や、効率的なブロック選択に基づくスパースアテンション機構が広く研究されてきた。しかし既存の多くのスパース選択手法は、ブロックの代表値(重心)のみに依存するため、重要な局所的トークンの情報が隠蔽されるという課題を抱えていた。本研究は、この平均希釈問題を解決するために、最大キーブロック半径を活用した新しい二分岐選択アプローチを導入する点で先行研究と異なる。
新規性と貢献
本研究の主要な貢献は、トレーニング不要で導入可能な二分岐スパース選択機構「RBS-Attention」の提案にある。重心ベースの枝と、キーブロックの最大半径に基づく救済枝を独立してなし崩し的になし、それらのマスクを組み合わせることで、FlashAttention の実行効率を維持しながら過小評価リスクのあるブロックを正確に回収できる点に学術的・実用的な新規性がある。
提案手法の詳細
RBS-Attention は、2 つの相補的な選択分岐を備えている。重心ベース分岐が平均的な関連性を捉える一方、救済枝(Rescue Branch)は最大キーブロック半径と、プロンプト・レイヤー・ヘッド依存の分布を利用して過小評価リスクのあるブロックを特定する。これら 2 つの分岐を独立して閾値処理し、それぞれのマスクを結合することで、通常のブロック・スパースな FlashAttention の実行構造を崩すことなく、救済ブロックの寄与を制御する。
評価・考察
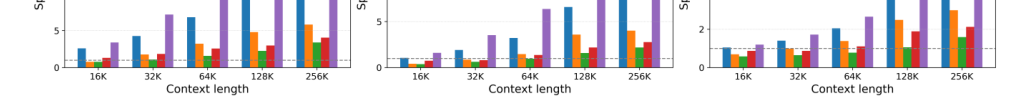
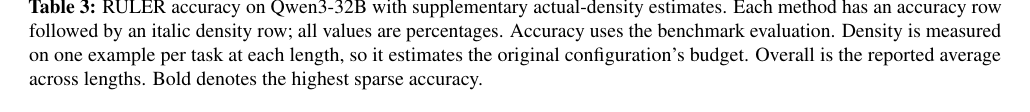
H100 GPU を用いた Qwen3-30B-A3B-Instruct-2507-FP8 モデルの 128K コンテキスト長における実験では、スタンドアロン Prefill アテンションで 20.65×、vLLM Prefill アテンションで 11.92×、エンドツーエンドの TTFT で 5.97× の高速化を達成した。また、デンスな Qwen3-32B モデルにおける RULER ベンチマークでは、デンスアテンションの 89.52 に対して 88.65 というほぼ同等の全体精度を維持している。加えて、LongBench-v2、InfiniteBench、Video-MME においても追加の評価が実施されており、実質的な保持率やメモリ挙動の特性が詳細に分析されている。
応用例と今後の展望
本手法は、数万トークンを超える長文脈プロンプトを扱う対話型 AI サービスや動画理解(Video-MME などのマルチモーダルタスク)において、初回応答遅延(TTFT)を劇的に短縮する実用的な基盤技術となる。国内のクラウドインフラ事業者や生成 AI アプリケーション開発企業(特に数千〜数万トークンの業務文書解析や長文コード補完を扱うテックリード層)にとって、モデルの再学習なしに推論コストとレイテンシを最適化するための実装選択肢を提供する。今後の課題としては、さらに多様なアーキテクチャや動的ワークロードにおけるスケーラビリティの検証が挙げられる。
結論
RBS-Attention は、半径適応型の二分岐選択により、長文脈 Prefill における平均希釈の課題を克服する。トレーニング不要かつ FlashAttention 互換の設計でありながら、大規模モデルにおいて精度劣化を最小限に抑えつつ大幅な高速化を実現できることを実証した。
注釈
- Prefill: 大規模言語モデルに入力されたプロンプトを最初に一括処理し、KV キャッシュを生成するフェーズ。
- Mean Dilution(平均希釈): スパースブロック選択において、ブロックの平均値や重心を用いることで、その内部にある重要な少数トークンの影響が薄まってしまう現象。
- TTFT (Time-to-First-Token): プロンプト入力完了から最初の出力トークンが生成されるまでの遅延時間。