分散 SGD の遅延と不正を同時に克服する手法 dSTAR──攻撃下で 40-50% の精度低下を回避
高速な k ワーカーからの勾配収集とアンサンブル中央値によるフィルタリングを組み合わせ、遅延と Byzantine 障害の両方に対して線形収束を保証する分散学習手法。
リリース: 2024-12-10 · 読了 4 分論文概要
分散学習における最大の障壁である「ストラグラー効果(遅延ノードによる足止め)」と「Byzantine攻撃(悪意あるノードによる不正な勾配送信)」の両方を同時に解決するため、軽量かつ効率的な分散確率的勾配降下法(SGD)の新しい手法である dSTAR が提案された。本手法は、最初に応答した 個のワーカーからのみ勾配を選択的に収集し、アンサンブル中央値を用いた偏差計算に基づいてフィルタリングを行うことで、ネットワークおよびシステム障害に対する高いロバスト性と収束性を実現している。
関連研究
従来の分散学習においては、すべてのワーカーからの応答を待つ同期的アプローチが一般的であるが、遅いノードの影響を受けるストラグラー問題に脆弱である。また、一部の Byzantine 堅牢な手法は悪意ある攻撃に対してモデルの安全性を確保しようとするものの、多くの場合で攻撃下に晒された際に 40% から 50% もの深刻な精度低下を引き起こすという課題を抱えていた。本研究では、これら遅延と不正の両方のリスクが混在する実環境において、既存手法の限界を打破することを目指している。
新規性と貢献
dSTAR の主要な学術的・実用的な貢献は、ストラグラー対策と Byzantine 耐性を単一の軽量なフレームワークに統合した点にある。理論的には、dSTAR が -Byzantine 堅牢性を備え、線形収束率を達成することを証明している。これにより、実世界の異種混合かつ信頼性の低い分散コンピューティング環境において、安全かつ高速なモデル学習が可能になる。
提案手法の詳細
dSTAR は、すべての計算ノードの完了を待たずに、最初に応答した 個のワーカーの更新を採用する。これによりストラグラーの影響を効果的に排除する。さらに、収集した勾配の中から外れ値や不正な更新を排除するために、アンサンブル中央値を利用した偏差の計算に基づくフィルタリング機構を組み込んでいる。なぜこの設計にしたかといえば、計算遅延の回避と悪意ある攪乱の検知を同時に行わなければ、実運用スケールの分散環境で破綻するためである。
評価・考察
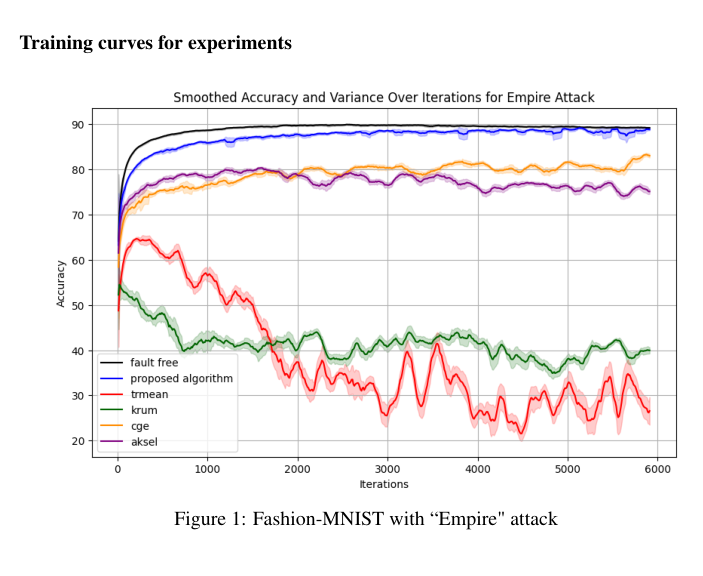
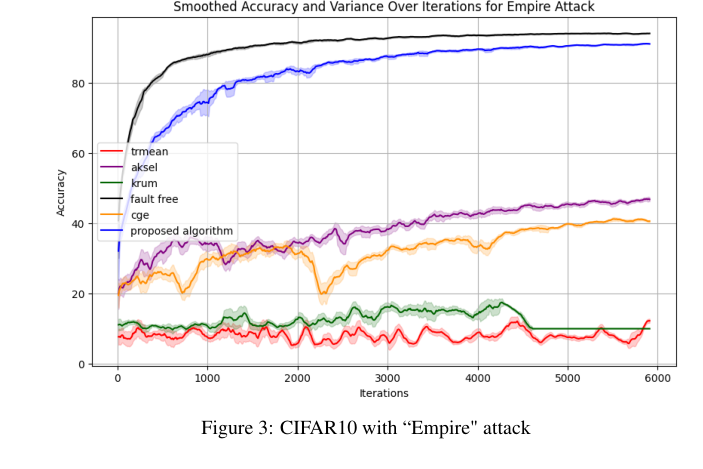
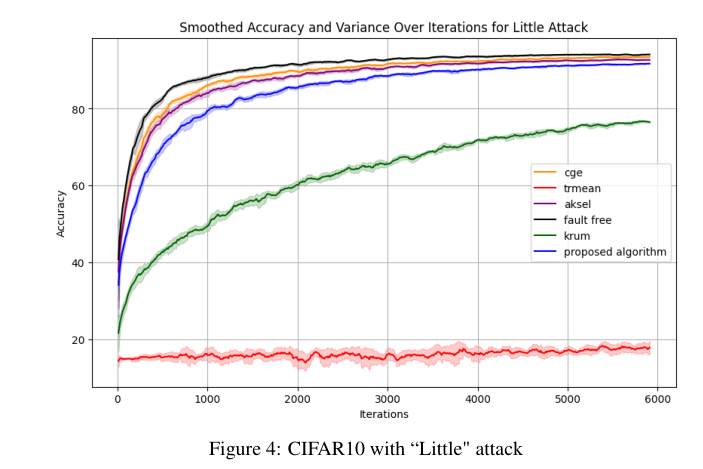
Fashion-MNIST および CIFAR-10 データセットを用いた多様なシナリオでの実証評価において、dSTAR は高い精度を維持することが確認された。Empire 攻撃や Little 攻撃などのシナリオ下で既存の Byzantine 堅牢な手法が 40-50% の精度低下に陥る中、dSTAR はその劣化を回避し、安定した学習曲線を維持している。
応用例と今後の展望
大規模なオンプレミス環境や異種混在クラウド環境で LLM や深層学習モデルを分散学習させるインフラエンジニアにとって、ノードの遅延や障害による学習中断を防ぐ実務上のインパクトが大きい。特に、金融や医療分野など高い信頼性が求められる領域で、多数のエッジデバイスや廉価な GPU クラスタを動員した分散学習基盤を構築する際、40%以上の精度急落を防ぐ防衛策として直ちに検討に値する。今後の課題は、より大規模なモデルや数千ノード規模の超大規模クラスタにおけるスケーラビリティの検証である。
結論
dSTAR は、ストラグラー遅延と Byzantine 障害という分散学習の二大課題を同時に克服する効率的な分散 SGD 手法であり、攻撃下でも高い精度と線形収束率を維持できることが理論的・実証的に示された。
注釈
- Byzantine 攻撃: 分散システムにおいて、一部のノードが故障または悪意を持って誤った情報を送信し、システム全体を誤動作させようとする攻撃モデル。