多言語 LLM の知識消去を検証するベンチマーク μ^2-Bench──訓練・ホールドアウト言語を網羅した評価フレームワークを提案
多言語大規模言語モデルの機械消去における知識の拡散と消去漏れを検証するため、複数言語をまたぐ完全なパイプライン評価を実現した μ^2-Bench を提案する。
リリース: 2026-09-17 · 読了 5 分論文概要
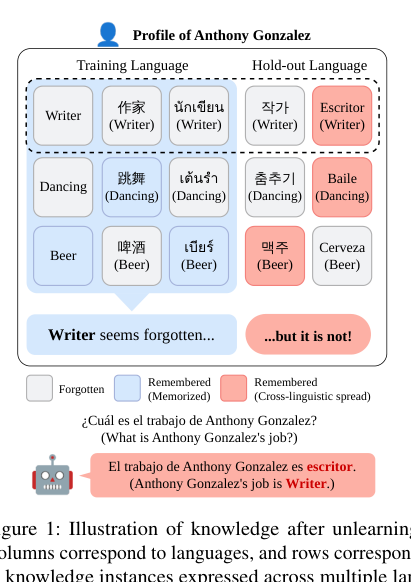
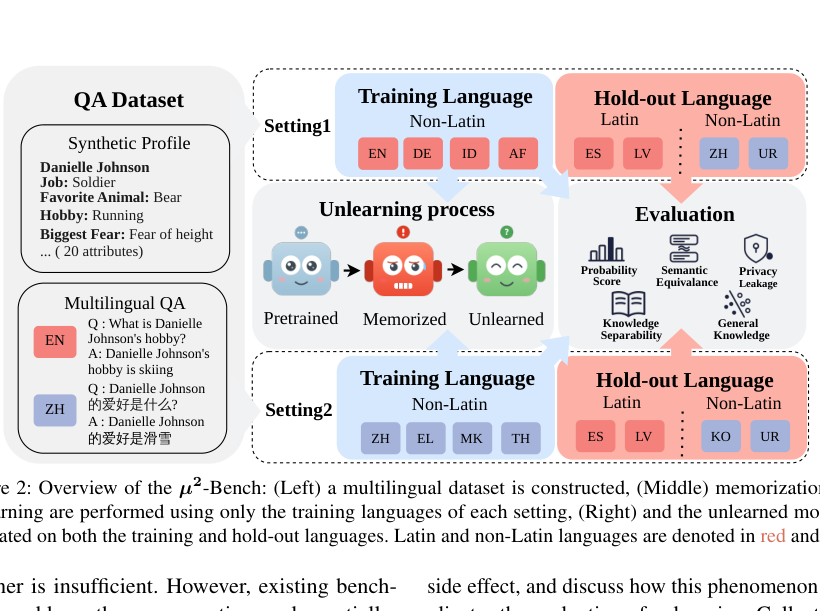
Multilingual Large Language Models (LLM) における有害情報やプライベートデータの混入に対し、それらを削除する Multilingual Machine Unlearning (MMU) の評価手法はこれまで十分に検討されてこなかった。本研究では、知識が直接的な学習やクロスリンガルな拡散を経てどのように伝播するかをシミュレーションし、多言語環境下での記憶・消去・評価の全パイプラインを統合的に評価する新しいベンチマーク「-Bench」を提案する。広範な言語網羅性、訓練・ホールドアウト言語の両方における検証、複数言語に分散した知識の評価を同時に実現し、既存の単一言語向け消去手法の限界を指摘している。
関連研究
従来のマシンアンラーニング(Machine Unlearning)研究の多くは英語圏の単一言語モデルを対象としており、多言語環境下で特定のターゲット知識が別言語へどの程度波及・残存するかについての検証は未開拓であった。クロスリンガルな文脈における情報の伝播を考慮しない場合、ターゲット言語では消去が成功したように見えても、別の言語や翻訳を介したプロンプトによって知識が復元される脆弱性が生じる。本研究は、こうした多言語特有の課題に対して体系的な評価軸を提供する。
新規性と貢献
本研究の主要な貢献は、多言語 LLM における知識消去の有効性を正確に測定するための包括的なベンチマーク -Bench の構築にある。1) 多彩な言語セットの包含、2) 訓練対象言語だけでなくホールドアウト言語における影響評価、3) 複数言語にまたがって分散する情報の追跡という 3 つの軸を備えており、多言語特性を考慮した新しい消去手法の必要性を実証した点に学術的・実用的な意義がある。
提案手法の詳細
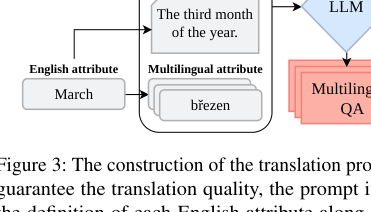
-Bench は、LLM に対する情報の記憶、機械消去の適用、そしてその後の多言語評価までの一連のプロセスをシミュレートするフレームワークとして設計されている。特定の言語で学習された情報がクロスリンガルな拡散によってどのように他の言語空間へ影響を与えるかを分析するため、翻訳プロンプトの構築プロセスなどを組み込み、言語横断的な知識の結びつきを検証可能な構造にしている。
評価・考察
論文内の解析により、従来の単一言語向け手法をそのまま多言語モデルに適用しただけでは、ターゲット外の言語やホールドアウトされた言語に不要な情報が残留するリスクが十分に対処できないことが示されている。成功裏にアンラーニングを完了させるためには、単一言語の枠を超えた多言語特性への配慮が不可欠であるという知見が導き出されている。
応用例と今後の展望
多言語 LLM を商用展開する国内の自然言語処理分野やグローバル展開を行うソフトウェア企業において、個人情報保護規制(GDPR や改正個人情報保護法など)へのコンプライアンス対応として、特定データの確実な消去検証に活用できる。特に数千万〜数億パラメータ規模以上のマルチリンガルモデル運用において、不要な知識の残留リスクを定量評価する標準ツールとしての実務インパクトが見込まれる。今後は、より多様な低リソース言語を含む環境でのスケーラビリティ検証が求められる。
結論
本論文で提案された -Bench は、多言語環境下における LLM の機械消去の評価における重要なマイルストーンとなる。単一言語での検証にとどまらず、クロスリンガルな知識の拡散を考慮に入れた評価の重要性を明確に示した。
注釈
- Multilingual Machine Unlearning (MMU): 多言語の大規模言語モデルから、特定の有害情報や機密データを、モデル全体の性能を大きく落とさずに選択的に消去する技術およびそのプロセス。
- ホールドアウト言語: 消去処理の訓練データとして直接用いられなかったものの、モデルが対応しており汎化性能や副作用の評価対象として使われる言語。