KV キャッシュをスパース化する長文脈推論手法 Elastic Threshold Attention──デコード速度最大 2.5 倍を実証
動的な文脈しきい値予測と乗算型ロジット抑制により、1.45B モデルで密注意力と同等の品質を維持しつつアクティブデコード密度 38% を達成。
リリース: 2026-09-16 · 読了 5 分論文概要
長文脈デコードにおける巨大な KV キャッシュはメモリ帯域幅のボトルネックを引き起こす。本論文では、クエリ表現から動的かつ文脈に応じたしきい値を直接予測するエンドツーエンドの学習可能アーキテクチャ「Elastic Threshold Attention (ETA)」を提案する。1.45B の事前学習済み ETA モデルは、言語モデリング、常識推論、最大 512K トークンの長文脈ニードル検索において、約 85% の訓練スパース性と約 38% のアクティブデコード密度で密注意力(Dense Attention)と競合する精度を維持している。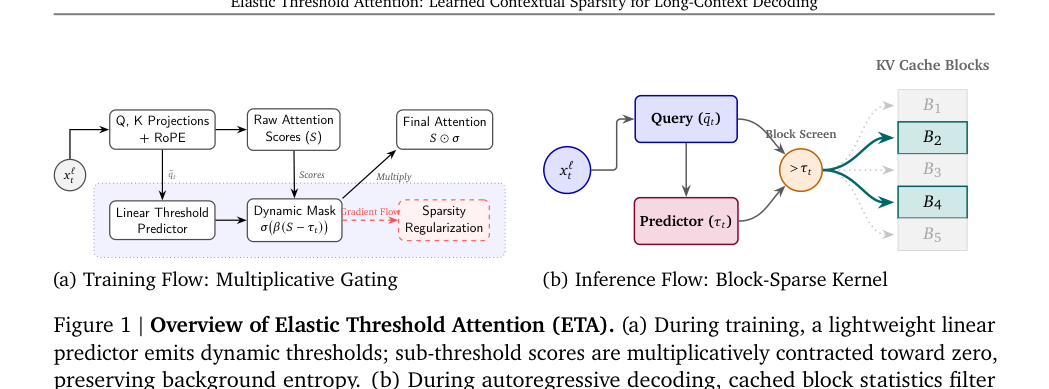
関連研究
従来のスパースアテンション手法は、選択的ローディングによってメモリ帯域の課題を緩和してきたが、固定的なヒューリスティックに依存しているため必要な文脈がドロップされ、品質の劣化を招いていた。本研究は、ハードウェアで高速化されたデコード速度を維持しつつ、密モデルの品質を犠牲にしない動的なしきい値選択メカニズムによってこれらの限界を克服する。
新規性と貢献
主要な貢献は、訓練時にサブしきい値のロジットをゼロに直接削除するのではなく乗算的に抑制する「マルチプリカティブ・サプレッション」の導入にある。これにより表現崩壊を起こさずにポリシーをゼロから学習でき、初期トークンにおける局所的アテンション・シンクを消失させる。さらに、Triton によるカスタムデコードカーネルの実装により、FlashAttention-2 と比較して最大 2.5 倍の壁時計時間でのデコード高速化を実現した。
提案手法の詳細
ETA はクエリ表現から動的なしきい値を予測し、困難な検索や推論ステップには密な文脈を割り当てる一方、定型的なトークンをプルーニングする。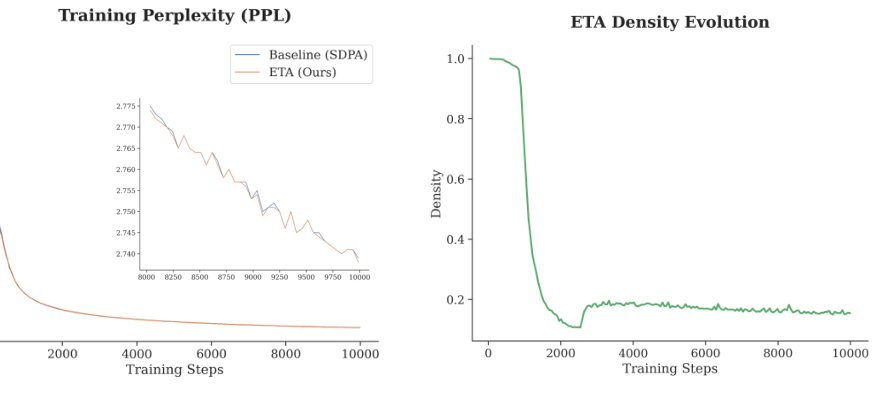 訓練中の滑らかな一様アテンションフロアに対する最適化は分散された確率リザーバーとして機能し、推論時には不必要な KV ブロックをハードプルーニングし、GPU の粗いブロック選択によって共取り込みされた偶発的トークンを吸収する。また、ドメイン特展開向けには、ヘッドごとの定数しきい値を凍結して予測器のオーバーヘッドを排除するオフラインキャリブレーションアルゴリズムにより、アテンション計算量をさらに 27% 削減する。
評価・考察
評価実験では、最大 512K トークンの長文脈ニードル検索において、1.45B ETA モデルが密注意力と同等の高精度を維持できることが示されている。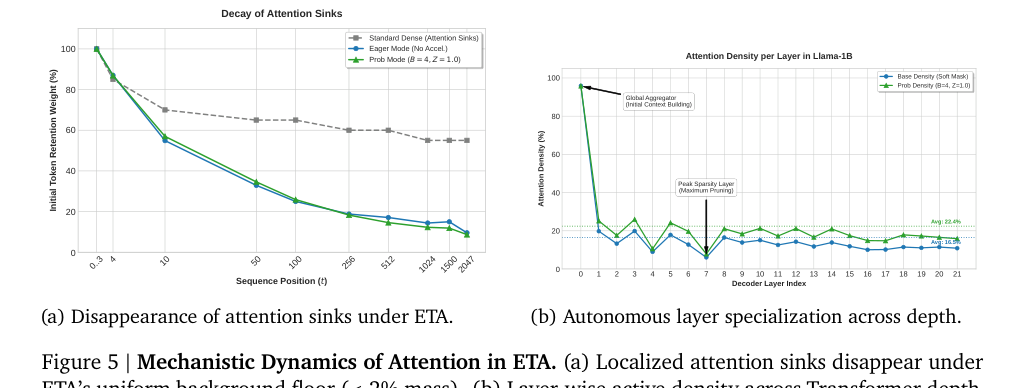 推論時においては、キャッシュされた幾何学的確率的境界を用いて 時間で KV ブロックをスクリーニングするカスタム Triton カーネルにより、FlashAttention-2 比で最大 2.5 倍の高速化を実証した。
応用例と今後の展望
金融や法務分野における超長文脈ドキュメントの RAG(Retrieval-Augmented Generation)システムや、数百万トークン規模のコードベース解析を行う国内の AI 開発企業において、GPU メモリ使用量を削減しつつ推論スループットを劇的に改善する実務インパクトを持つ。今後の課題としては、より大規模なパラメータを持つモデル群へのスケーラビリティの検証および動的なしきい値予測のオーバーヘッドのさらなる最適化が挙げられる。
結論
Elastic Threshold Attention は、動的かつ文脈に即したスパース化手法により、長文脈デコードにおけるメモリ帯域幅のボトルネックを解消する。訓練時の乗算型ロジット抑制と推論時の スクリーニングを組み合わせることで、品質の劣化なしに最大 2.5 倍の高速化と 38% のアクティブデコード密度を実現した。
注釈
- KV キャッシュ: Transformer の自己注意機構において、過去のトークンの Key と Value のテンソルを保持し、デコード時の再計算を防ぐ仕組み。
- スパースアテンション: すべてのトークン間のアテンション計算を行わず、重要とみなされる一部のトークンのみを選択的に計算する効率化手法。