科学的コードベースをエージェント学習環境化する基盤 ScienceIDE と PhAI-IDE モデル群の提案
科学的リポジトリをプログラム可能な環境に変換する ScienceIDE 基盤を構築し、それを用いて訓練した PhAI-IDE モデル群で科学的コード修復や汎用ベンチマークの性能向上を実証した。
リリース: 2026-09-16 · 読了 5 分論文概要
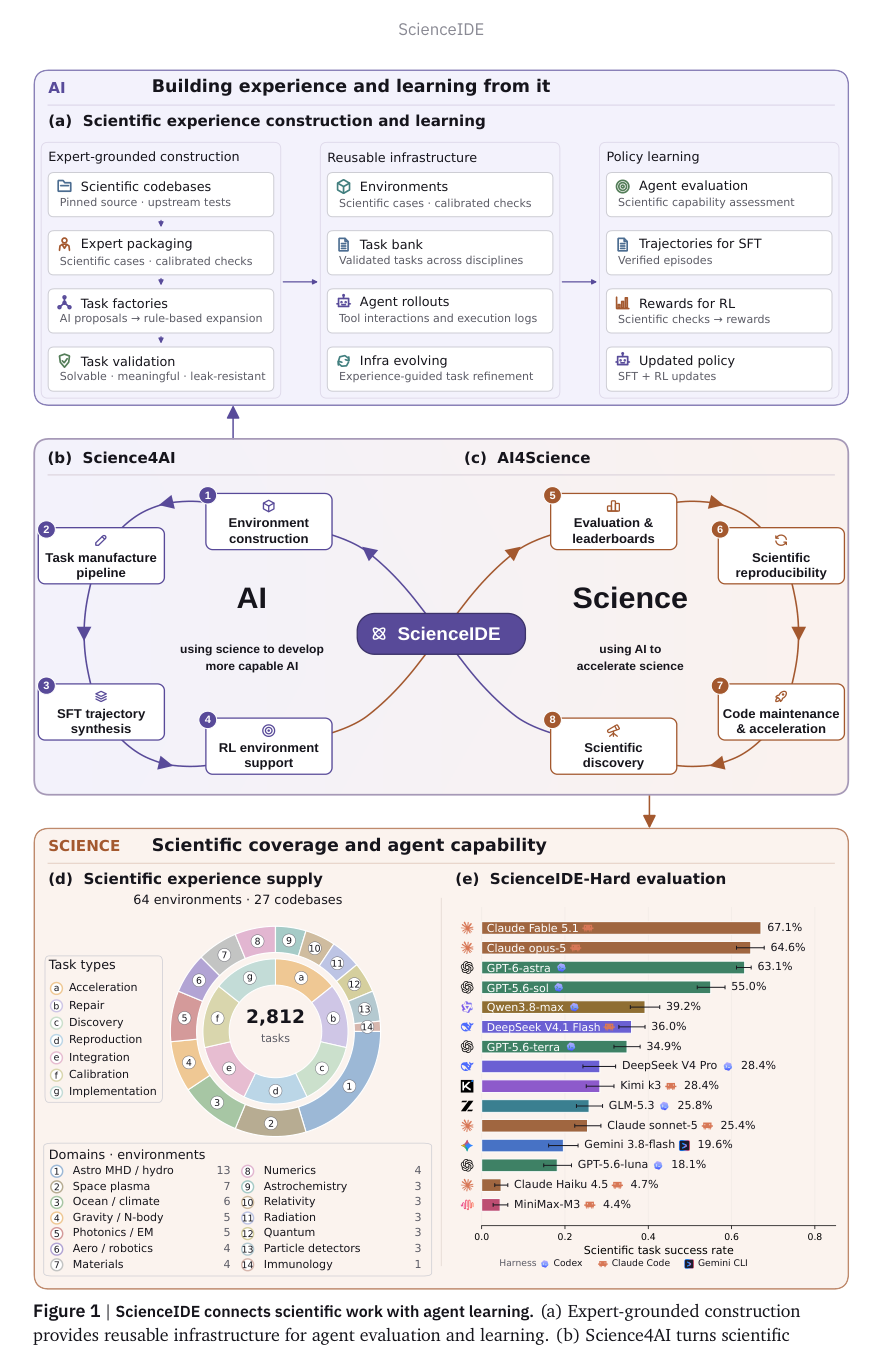
科学的なコードリポジトリには、数十年に及ぶ人間の知識が実行可能なモデル・手法・ツールとして蓄積されている。しかし、ツールチェーンの断片化、暗黙的なドメイン規約、特殊な正当性検証基準などの課題があり、この知識を信頼性の高い学習経験に変換することは困難であった。本研究ではこの課題を「科学的経験のボトルネック(scientific experience bottleneck)」と定義し、世界の科学的コードをプログラミング可能な環境へと変換するインフラストラクチャ「ScienceIDE」を提案する。
関連研究
従来の大規模言語モデル(LLM)およびコード生成エージェントの多くは、汎用的なソフトウェア開発や標準的な競技プログラミングの環境(例:SWE-bench等)を中心に発展してきた。しかし、科学技術計算やドメイン特化型のコードベースにおいては、独自の依存関係や複雑な数値検証プロセスが存在するため、既存の環境構築手法をそのまま適用することが困難であるという背景がある。
新規性と貢献
ScienceIDE は、専門家が定義した科学的事例と合致基準に導かれ、エージェントがリポジトリを実行可能な環境へと自動変換する仕組みを提供する。これにより、タスク生成、実行、科学的検証のすべてをサポートし、教師あり微調整(SFT)や強化学習(RL)、評価のための共通基盤を確立した点が最大の新規性である。また、検証済みの対話軌跡を用いて訓練された PhAI-IDE(72B、9B、4B)モデル群において、科学的コードの修復能力だけでなく、コード、推論、知識に関する汎用ベンチマーク全体での性能向上(ポジティブ・トランスファー)を実証した。
提案手法の詳細
ScienceIDE は、フラグメント化したツールチェーンや暗黙の規約を統合し、科学的コードベースをエージェントが自律的に学習・試行錯誤できる環境へと昇華させる。専門家が定めた合致基準に基づくタスク生成および科学的検証メカニズムを組み込むことで、エージェントが生成したコードの正確性を厳密に評価できる構造を採用している。これにより、単なる静的なコード補完にとどまらず、動的な検証ループを持ったエージェント学習サイクルの構築を可能にしている。
評価・考察
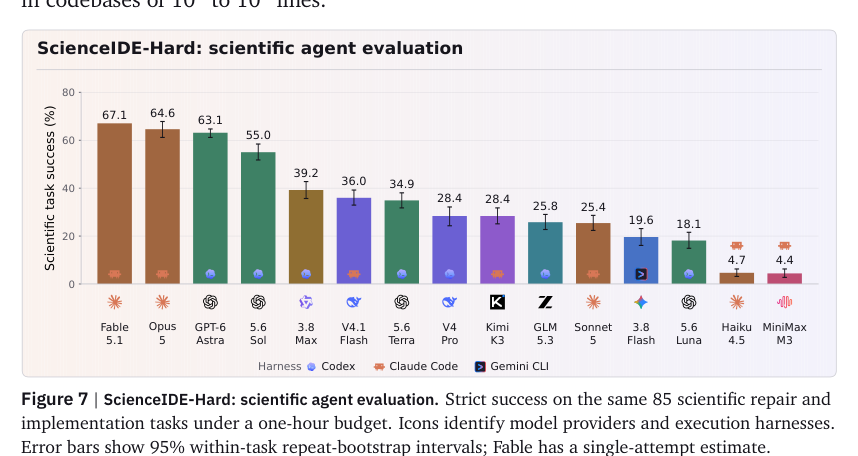
検証済みの相互作用軌跡(Scientific-trajectory)を用いて SFT を実施した結果、PhAI-IDE モデル群(PhAI-IDE-72B、PhAI-IDE-9B、PhAI-IDE-4B)は、未見の科学的コード修復タスクにおいて優れた性能を示した。
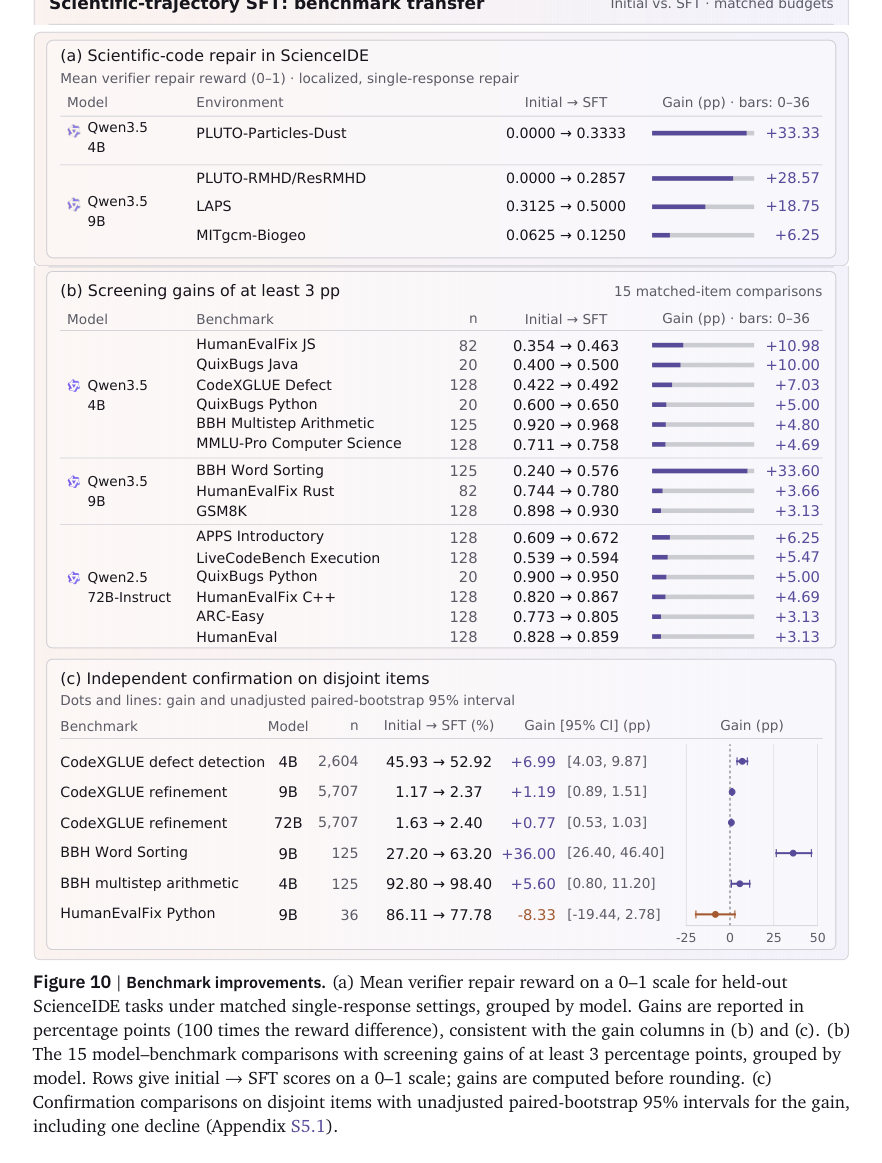 さらに、科学的ドメインでの経験が、コード生成や推論、知識を問う外部の汎用ベンチマークに対してもポジティブな転移効果をもたらすことが確認されており、ドメイン特化型の学習が汎用能力の向上にも寄与することが示されている。
応用例と今後の展望
創薬、材料科学、数値シミュレーションなどの学術・産業分野において、複雑な科学的コードの検証や実験自動化を加速させる基盤として活用できる。日本の製薬企業や化学メーカー、あるいは先端研究機関における計算科学・マテリアルズ・インフォマティクス領域(数名〜数十名規模の研究開発チーム)において、独自の研究用コードベースを活用したドメイン特化型エージェントの訓練・評価基盤への実務適用が期待される。
結論
ScienceIDE は、世界の科学的ソフトウェアを科学的知能開発のための共通基盤へと変える統合ワークスペースの礎を築いた。環境構築から検証、エージェント訓練までのエコシステムを提供することで、科学技術分野におけるエージェント学習の新たな可能性を切り拓いている。
注釈
- SFT (Supervised Fine-Tuning): 教師あり微調整。あらかじめ用意された高品質な入出力ペアを用いてモデルの重みを最適化する学習手法。
- POSITIVE TRANSFER: 正の転移。あるタスクやドメインで得た学習効果が、別のタスクやドメインの性能向上にも寄与する現象。