インタラクティブな Web アプリの機能要件を検証するコーディングエージェント向けベンチマーク ProgramDistill の公開
動作する参照アプリケーションから 1,975 件の検証済み挙動を自動抽出するベンチマーク ProgramDistill を提案し、フロンティアモデルの長文脈・インタラクション性能を評価した。
リリース: 2026-09-16 · 読了 5 分論文概要
ソフトウェア工学(SWE)におけるコーディングエージェントの評価は、従来、課題記述や指示に基づくものが主流であった。しかし、実際の Web 開発においては、エージェントが動作するソフトウェア(リファレンスアプリケーション)から自ら仕様を推論し、不完全なアプリケーションに実装を統合する能力が求められる。本論文では、完全に機能する参照アプリケーションとのインタラクションを通じて発見された機能に基づき、コーディングエージェントを評価する新しいベンチマーク ProgramDistill を提案する。
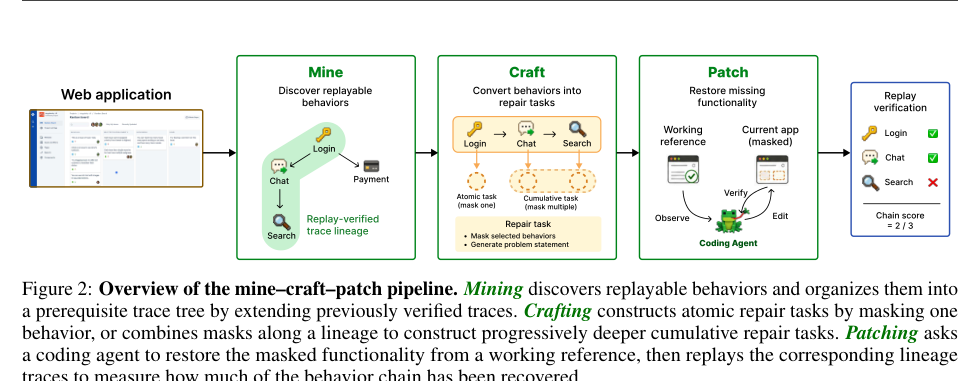
著者らは、アプリケーションを異なる粒度の機能に因数分解し、それぞれにゴールドパッチ(正解パッチ)で実行可能なリプレイ可能な挙動を関連付ける自動パイプライン mine-craft-patch を構築した。これにより、人間による介入なしに 26 のアプリケーションから 1,975 件のリプレイ検証済み挙動を発見し、4,063 件のタスクを構築している。
関連研究
これまでの SWE ベンチマーク(例: SWE-bench など)は、既存の GitHub の issue 記述や単体テストの通過を目的とするものが多かった。しかし、これらはテキストベースの静的な指示に依存しており、実行中のアプリケーションの状態や動的な振る舞い、あるいは GUI / インタラクティブな操作を介した仕様の逆算を評価する枠組みとしては不十分であった。本研究は、動作するソフトウェアそのものを仕様のソースとすることで、より実務的な開発環境に近い評価軸を提供する点で先行研究と一線を画している。
新規性と貢献
本研究の主要な貢献は以下の 3 点にある。
- インタラクティブな要件推論ベンチマークの構築: テキストの指示ではなく、完全な参照アプリケーションとのインタラクションから挙動を推論するタスク群の確立。
- 完全自動化されたマイニングパイプライン:
mine-craft-patchにより、人間による手動のアノテーションを一切行わずに 4,063 件の検証済みタスクを生成。 - フロンティアモデルの定量評価: 9 つの最先端コーディングエージェントを対象に網羅的な実験を行い、現在のモデルにおける長文脈および段階的復元での性能限界を明らかにた。
提案手法の詳細
ProgramDistill の核心は、動的な Web アプリケーションから検証可能なタスクを自動抽出する mine-craft-patch パイプラインにある。
- 因数分解: アプリケーションを複数の機能粒度に分割する。
- 挙動のリプレイ検証: 各機能に対応する操作と期待される差分(パッチ)を組み合わせ、実行環境で正しく動作するかをプログラム的に検証する。
- タスクの自動構築: 人間の介入を排除し、再現性の高いベンチマーク環境としてパッケージ化する。
これにより、エージェントが「動くコードの模倣・統合」や「段階的な機能復元」をどの程度正確に行えるかを制御された難易度で測定できる。
評価・考察
9 つのフロンティアコーディングエージェントを用いた評価実験の結果、モデルの現在地と課題が浮き彫りになった。
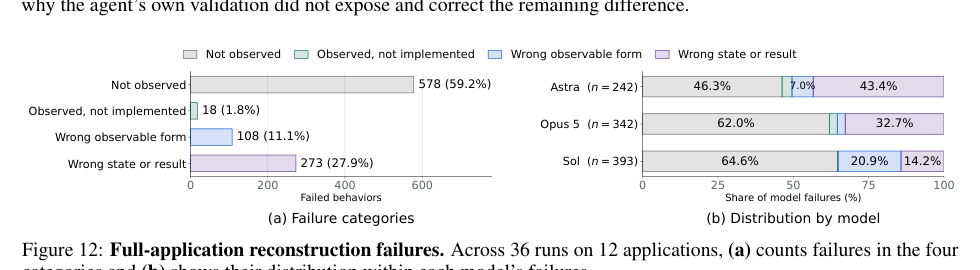
- フルアプリケーション再構築: GPT-6 Astra が 49.2%、Claude Opus 5 が 28.8% の累積ワークフロー成功率を記録した。
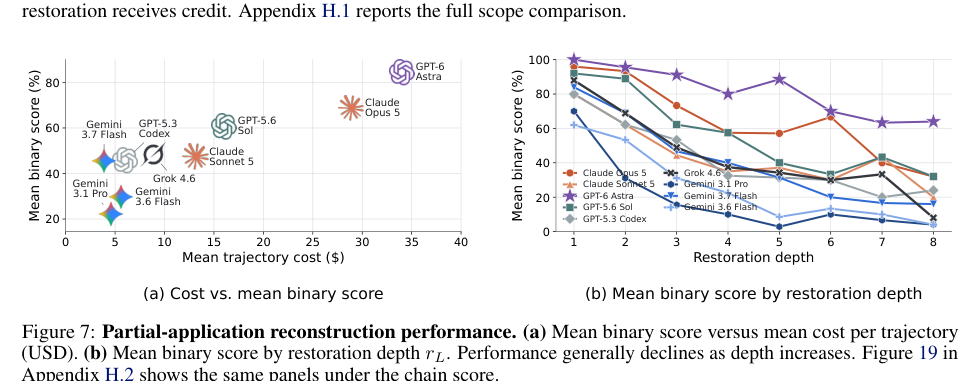
- 部分アプリケーション再構築: 復元深度(restoration depth)が 1 から 8 に増加するにつれて、成功率は 100% から 64.0%(GPT-6 Astra 系等の動向)および 96% から 32% へと急激に低下した。
この結果は、現在の最高峰モデルであっても、文脈の深さや段階的な依存関係が複雑化するにつれて、正しく機能を再構築する能力が大きく劣化することを示している。
応用例と今後の展望
ProgramDistill は、単なる静的なベンチマークにとどまらず、コーディングエージェントの**カリキュラム学習(Curriculum-based training)**の自然な基盤を提供する。段階的な難易度調整が可能なため、エージェントの強化学習におけるステップバイステップのトレーニング環境としての活用が見込まれる。
日本のソフトウェア開発企業やテックリードにとっても、自社内の大規模なレガシーコードベースやインタラクティブな Web アプリケーションの改修・機能追加において、AI エージェントをどの程度の複雑さまで信頼して任せられるかを診断するための定量的な指針となる。特に金融や医療などの厳格な Web フロントエンド・バックエンド統合開発領域において、段階的復元タスクを通じたエージェントの信頼性検証への応用が期待される。
結論
本論文では、動作する参照アプリケーションから検証可能なタスクを自動生成するベンチマーク ProgramDistill を提案した。実験により、現在のフロンティアモデルにおける長文脈・段階的機能復元の限界が数値として示され、今後のコーディングエージェントの訓練および評価における重要な道標が提示された。
注釈
- SWE (Software Engineering): ソフトウェア工学。自動プログラミングやコード生成エージェントの評価領域を指す。
- フロンティアモデル: 現時点で最高水準の性能を持つ大規模言語モデルおよびそのエージェントシステム。