リアルタイム音声対話モデル StepAudio 3 Realtime──遅延ゼロの並列推論で MMSU 90.6 を達成
連続的な聴取・対話・思考・行動ループを構築し、Think-While-Speaking による並列推論で遅延を抑えつつ MMSU 90.6 や Artificial Analysis Full-Duplex Bench 98.9 を達成した音声言語基盤モデル。
リリース: 2026-09-12 · 読了 5 分論文概要
Bin Lin らが発表した「StepAudio 3 Realtime」は、リアルタイム音声対話において深く高度な推論、低遅延な応答、滑らかなターンテーキングを同時に実現する音声言語基盤モデルである。本研究の核となるのは、連続的な「聴取・対話・思考・行動(listen-converse-think-act)」ループの構築であり、特に発話と同時に非公開の思考プロセスを実行する「Think-While-Speaking」メカニズムの導入にある。これにより、従来の音声モデルでトレードオフ関係にあった「深部推論」と「低遅延なリアルタイム応答」を両立させ、MMSUベンチマークで90.6、Artificial Analysis Full-Duplex Benchで98.9 Overallという極めて高いスコアを記録した。
関連研究
従来の音声対話システムや音声言語モデル(Speech-Language Models)では、音声入力をテキストに変換してからLLMで処理するか、あるいはエンドツーエンドの音声モデルとして動作していた。しかし、これらは無音区間の検出ミスによる不自然な割り込みや、推論に時間を要することによる応答遅延、さらには複雑な質問に対する推論能力の不足という課題を抱えていた。本研究は、全二重(Full-Duplex)による自然なストリーム処理と、LLM特有の高度な推論機能を統合することで、これらの制限を直接克服するアプローチをとっている。
新規性と貢献
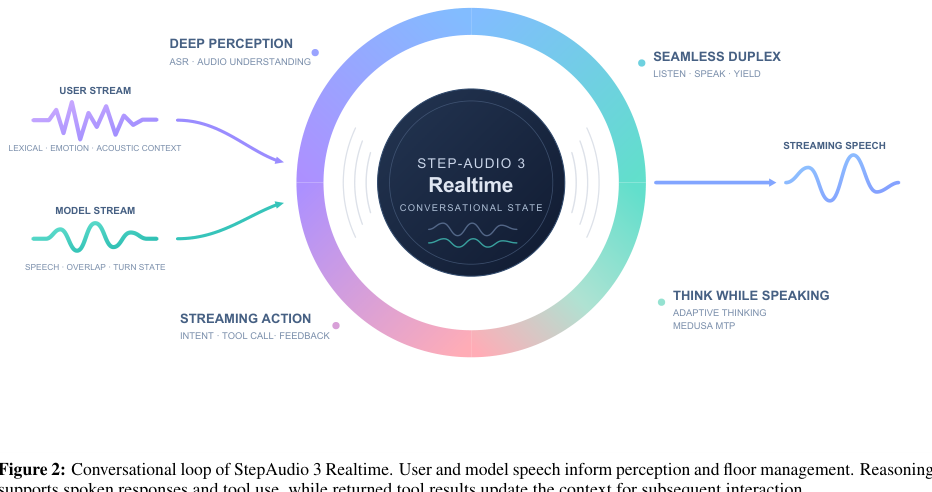
本研究の最大の貢献は、ディープ・パーセプション(Deep Perception)によるリッチな音響的手がかりの抽出、シームレス・デュプレックス(Seamless Duplex)による同期された音声ストリーム管理、そして「Think-While-Speaking」による並列推論の3つを統合した点にある。これにより、専用の推論モデルに匹敵する対話および推論性能を維持しながら、リアルタイムな音声出力を遅延なく実行可能にした。
提案手法の詳細
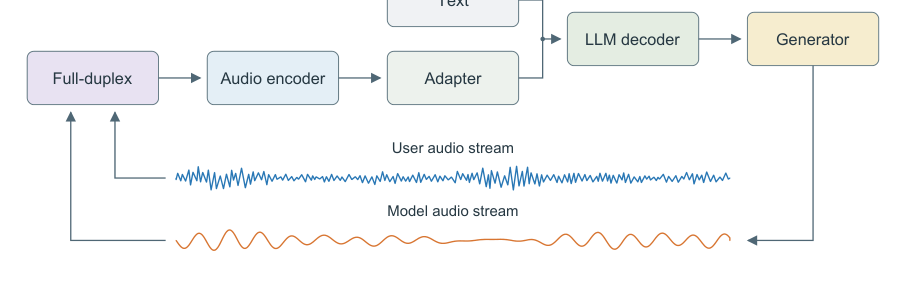
StepAudio 3 Realtimeのアーキテクチャは、いくつかの重要なコンポーネントで構成されている。
- Deep Perception: ユーザーの意図を正確に解釈するために、多様な音響的キューを捉える音響認識機構。
- Seamless Duplex: ユーザーとモデルの双方向オーディオストリームを同期させ、一時停止、バックチャネル(相槌)、割り込みを自然に処理するモジュール。
- Think-While-Speaking: 発話の出力を継続しつつ、バックグラウンドでプライベートな推論プロセスを並列実行する機構。推論の深さと応答速度のトレードオフを解消するために設計された。
- Voice Agent: ダイアログフローを阻害することなく、非同期でのツール実行を管理する統合エージェント。
評価・考察
論文では複数の標準ベンチマークを用いて徹底的な評価が行われている。
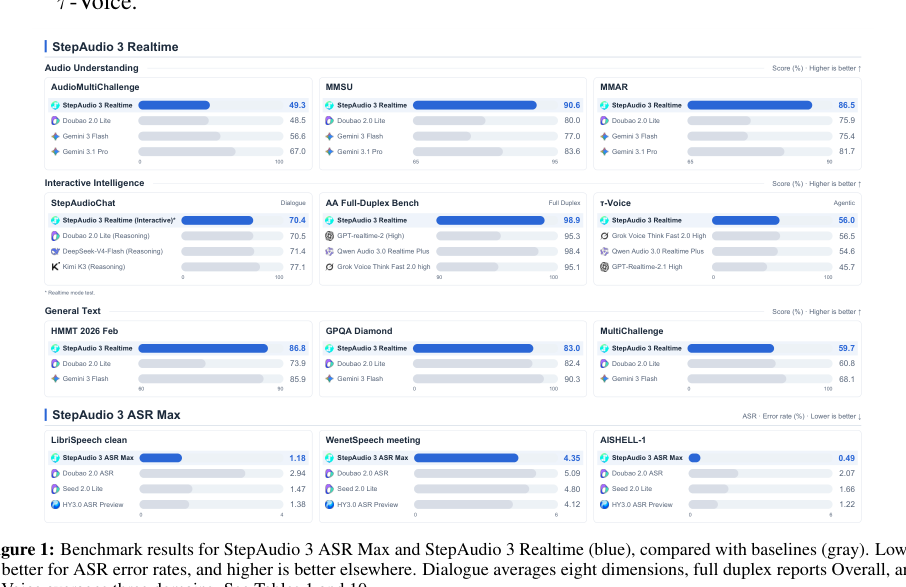
- MMSU: 90.6のスコアを記録し、トップクラスの性能を証明。
- Artificial Analysis Full-Duplex Bench: 98.9 Overallを達成し、全二重対話における卓越した追従性を示した。
- StepAudioChat: 推論モードにおいて73.0のマクロ平均を達成。
- -Voice: 56.0%のマクロタスク成功率を記録。
応用例と今後の展望
音声対話エージェントやカスタマーサポート分野において、顧客からの割り込みや複雑なバックエンド処理(非同期ツール実行)を伴うリアルタイム応答システムへの実装が可能となる。日本のエンジニア・研究者にとって、コールセンター自動化や組込み音声アシスタント開発において、遅延の少ない全二重音声モデルを設計する際の重要な参照アーキテクチャとなる。今後は、さらなる処理の軽量化と、多言語環境におけるロバスト性の検証が課題となる。
結論
StepAudio 3 Realtimeは、連続的な対話ループとThink-While-Speakingによる並列推論を組み合わせることで、音声対話における応答遅延と推論精度の壁を打破した。各種ベンチマークにおける圧倒的な数値は、次世代の音声基盤モデルの方向性を示すものである。
注釈
- Think-While-Speaking: 音声を出力している最中に、内部で次の展開や推論を並列に計算する機構。
- 全二重 (Full-Duplex): 送信と受信を同時に行うことができる通信方式。音声対話においては、モデルが話している最中にユーザーが割り込んで話すことを可能にする。