構造化データ向け基盤モデル LimiX-2──因果機構の同時学習で TabArena や TALENT の性能を更新
Contextual Mechanism Networks と合成データ事前学習により、既存の表形式基盤モデルを上回る予測性能と因果スキーマ復元を実現。
リリース: 2026-09-15 · 読了 5 分論文概要
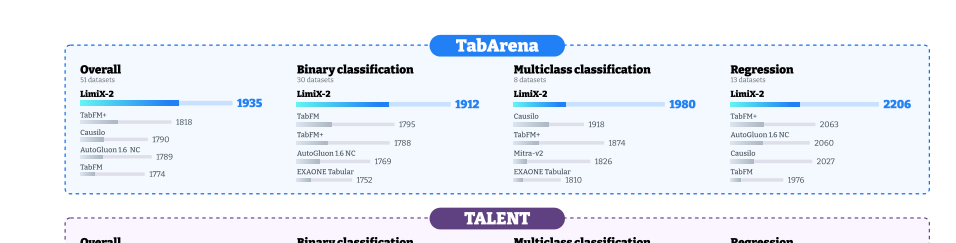
LimiX-2 は、モデルおよびデータのスケーリング則に基づいて開発された、構造化データ(表形式データ)向けの新しい基盤モデルである。従来の表形式 Prior-Data Fitted Networks (PFNs) がターゲット中心の予測に偏っていたのに対し、本手法はデータ生成メカニズムの結合構造を捉えるアプローチを採用し、TabArena や TALENT、BCCO といった標準的なベンチマークで既存のデータセット特化型モデルや従来の表形式基盤モデルを上回る予測性能を記録している。
関連研究
これまでの表形式データ向け深層学習モデルや PFNs は、主に特定タスクにおけるターゲット変数 の条件付き確率 の予測に最適化されてきた。しかし、これらのアプローチはデータ背後の因果構造や変数間の複雑な関係性を十分に表現しきれないという課題があった。本研究では、この課題を克服するため因果構造の同時学習にアプローチを拡張している。
新規性と貢献
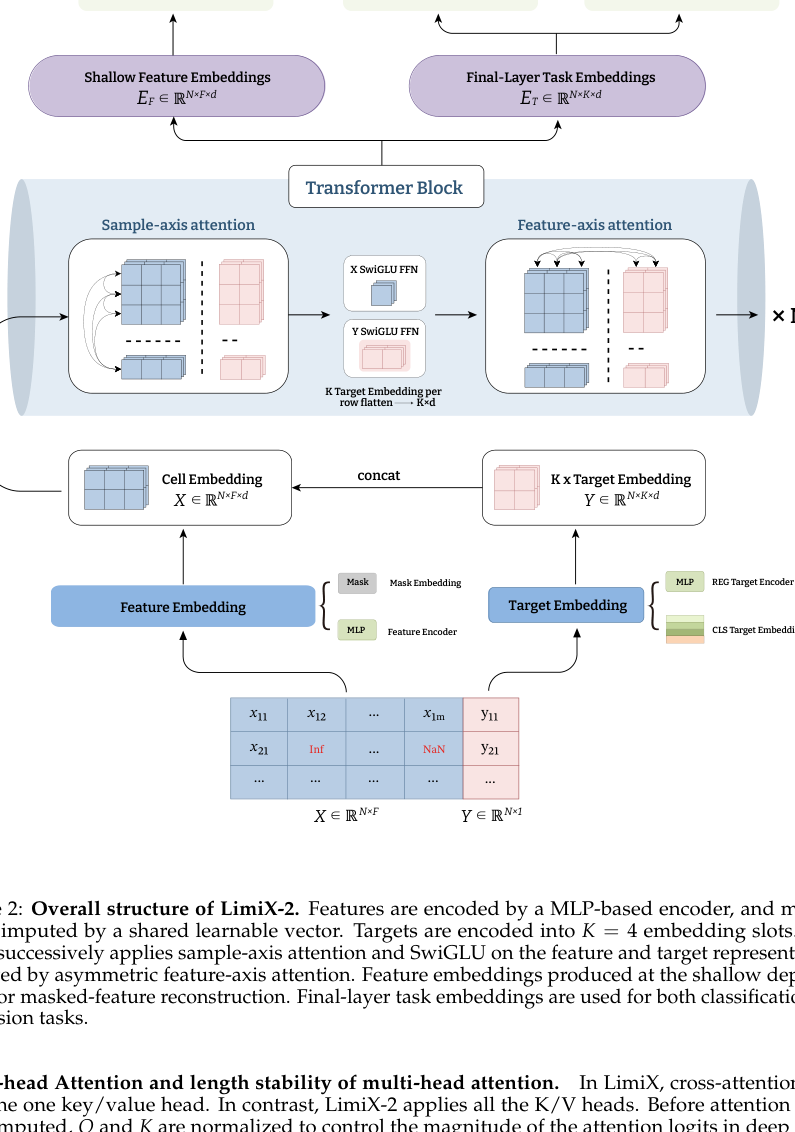
本研究の最大の新規性は、予測タスク単体ではなく因果機構に着目した Contextual Mechanism Networks (CMNs) パラダイムの導入にある。これにより、単なる高精度な予測にとどまらず、モデルの注意機構(Feature Attention)を介して直接的な因果関係を符号化し、因果スキーマの正確な復元(Causal Skeleton Recovery)を可能にする点が学術的・実用的な大きな貢献である。
提案手法の詳細
LimiX-2 は Contextual Mechanism Networks (CMNs) パラダイムを採用し、事前学習として Context-Conditional Masked Modeling (CCMM) を実行する。従来のターゲット中心の予測()から脱却し、データ生成の裏にある同時構造を表現するため以下の結合分布学習を行う。
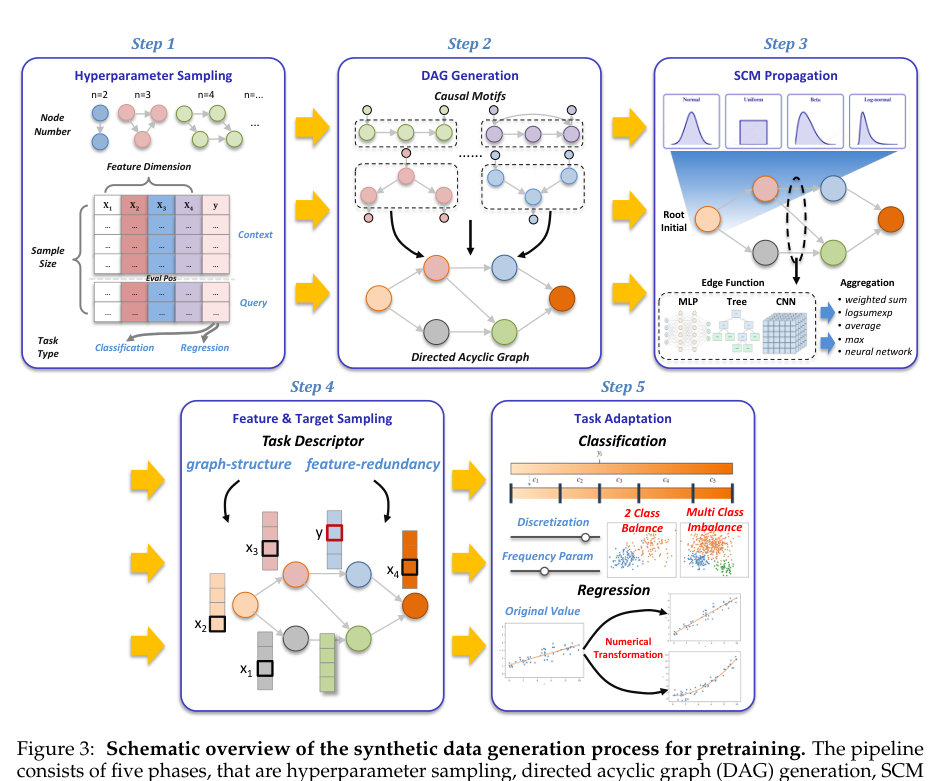
事前学習には、多様なグラフ構造、関数的メカニズム、観測プロセスを包含する構造因果モデル(SCMs)から生成された合成データセットが利用される。
評価・考察
TabArena、TALENT、BCCO ベンチマークにおける評価の結果、LimiX-2 は既存のデータセット特化型モデルや従来型の表形式基盤モデルに対して優位性を示した。また、予測性能の高さだけでなく、特徴量アテンションが直接的な因果関係を捉えることで、因果スキーマの復元において優れた特性を発揮することが確認された。
応用例と今後の展望
構造化データを扱う金融・マーケティング・医療などの分野において、高い予測精度と因果推論的な解釈性を同時に満たすモデルとして活用できる。特に国内の金融機関やヘルスケア企業におけるリスク分析や因果探索パイプラインにおいて、手動での特徴量設計や因果モデル構築のコストを削減する実務インパクトが期待される。
結論
LimiX-2 は、Contextual Mechanism Networks と合成データによるスケーリングを組み合わせることで、表形式データの予測精度向上と因果構造の同時復元を両立させた。構造化データモデリングの新たな標準となる可能性を示している。
注釈
- PFNs (Prior-Data Fitted Networks): 事前学習済みデータを用いて、新たなデータに対する機械学習モデルの挙動を直接シミュレート・予測する枠組み。
- SCMs (Structural Causal Models): 変数間の因果関係を有向グラフと関数方程式で記述する因果推論のフレームワーク。